# Agent 为什么会记错?Anthropic 拆解 Claude 记忆、Dreaming 与 Wiki 检索
你可能碰到过这种情况:昨天 Claude 找到了集成测试的正确跑法,今天开个新会话,它又从头试了一遍。
更麻烦的是,它也可能把昨天试错时的猜测写进笔记,今天一开工就照着做。
前面聊 Claude Code 怎么读懂大代码库时,我们讲的是如何找眼前的代码。
一次任务结束后,哪些经验值得留下?
下一次怎么找到这些经验,又凭什么信它?
2026 年 11 月 6 日,Anthropic 工程团队发布了 Lance Martin 撰写的《The components of agent memory》。
我的理解是,做 Agent 记忆,先把「保存什么」和「何时交给模型」当成两个独立的设计决定。
# 一、四层记忆,决定下一次会话能看到什么
Anthropic 讨论的 Agent 记忆,是从任务里获得、保存到会话之外,并能被后续会话读回的信息。
上下文压缩解决的是同一任务如何在有限窗口里继续跑。
这里的跨会话记忆靠外部存储,模型权重保持原样。
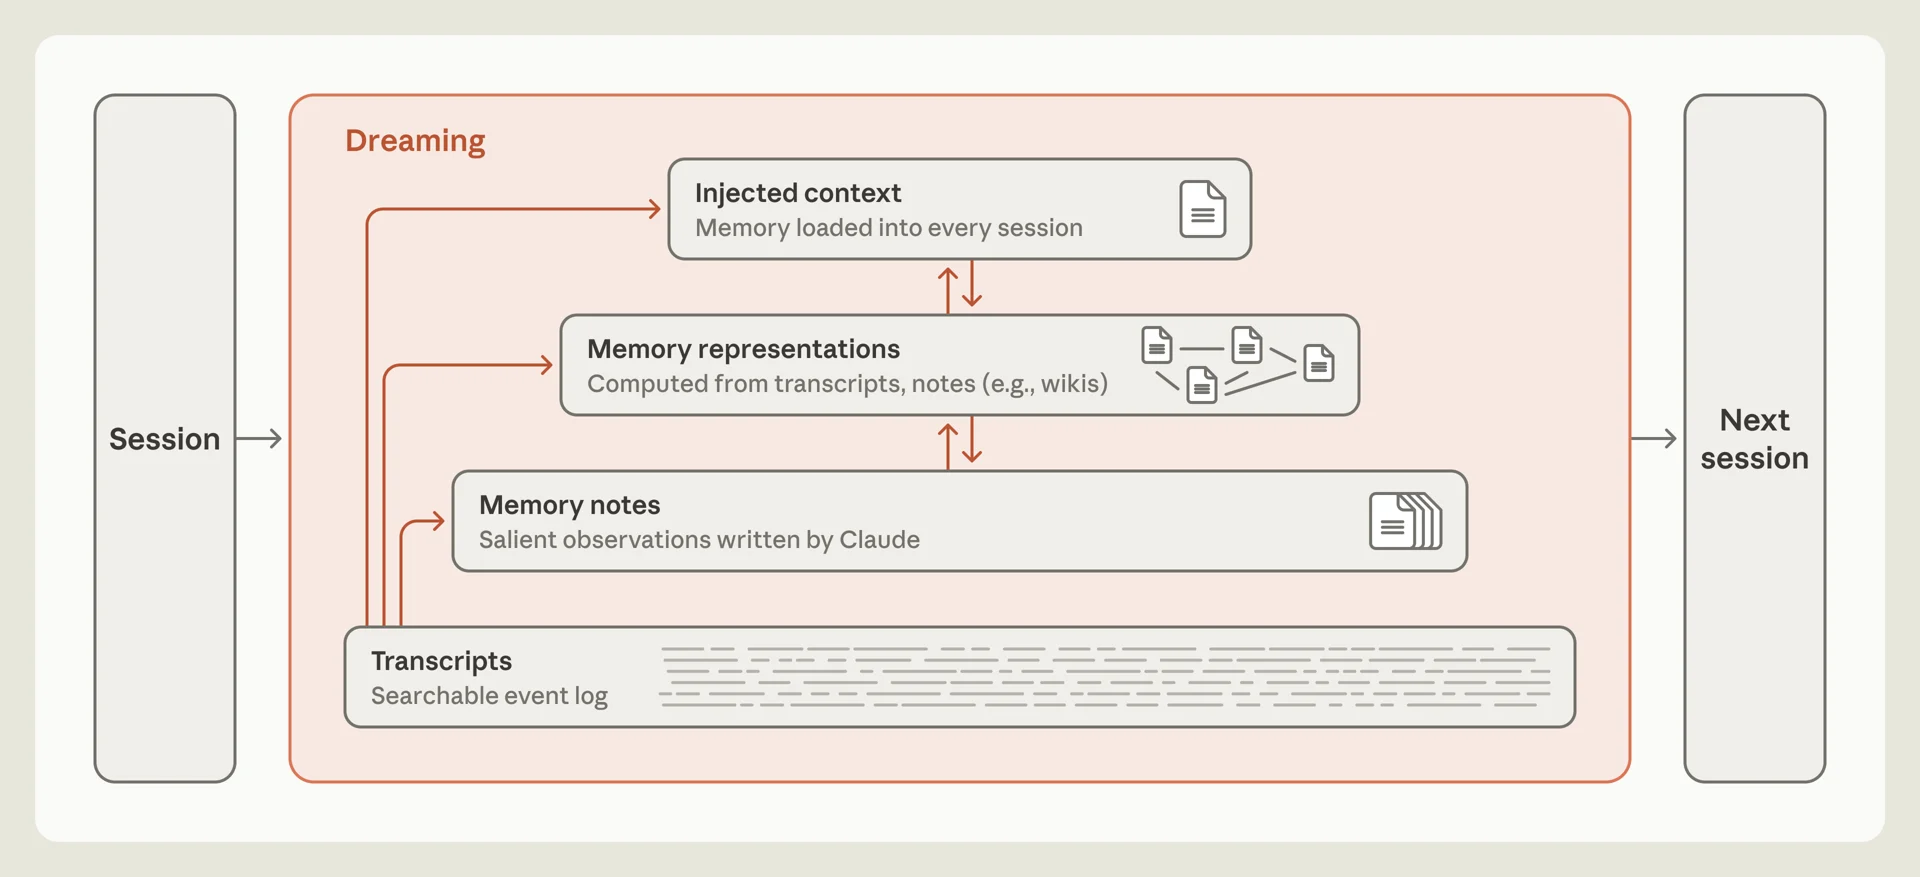
图源:Anthropic 工程博客,图 1 (opens new window)
从下往上看,会话记录保存对话和工具结果,记忆笔记留下可复用经验,记忆表示用 Wiki 等形式组织经验,最上层的预注入上下文在新会话启动时加载。
左侧从会话记录向上分出的三条箭头,表示 Dreaming 可以直接回查原始记录,再修订笔记、更新 Wiki,或者调整启动时注入的内容。
中间的双向箭头表示记忆可以升也可以降,比如把高频规则提到启动层,把细节移回主题页,只留一条索引。
存进系统和进入上下文,是两件不同的事。
Claude Code 有个现成例子:开启 Auto Memory 时,启动阶段只装入 MEMORY.md 开头的 200 行或 25 KB,以先达到的限制为准。
具体主题文件可以在后面按需读取。
想了解团队规则怎么写,再看 CLAUDE.md 指南。
# 二、Dreaming 回放,是为了把猜测变成可核对的记忆
任务进行中写笔记,优势是快,当下的发现马上就能留下。
代价是模型只看到了现在这段上下文。
比如,模型看到重跑后报错消失,可能把「重跑能修复」存成经验。
实际改变结果的是两次运行之间启动的依赖。
测试当时跑了多少秒,留在日志里就够了,值得写进笔记的是某类超时需要先检查哪个依赖。
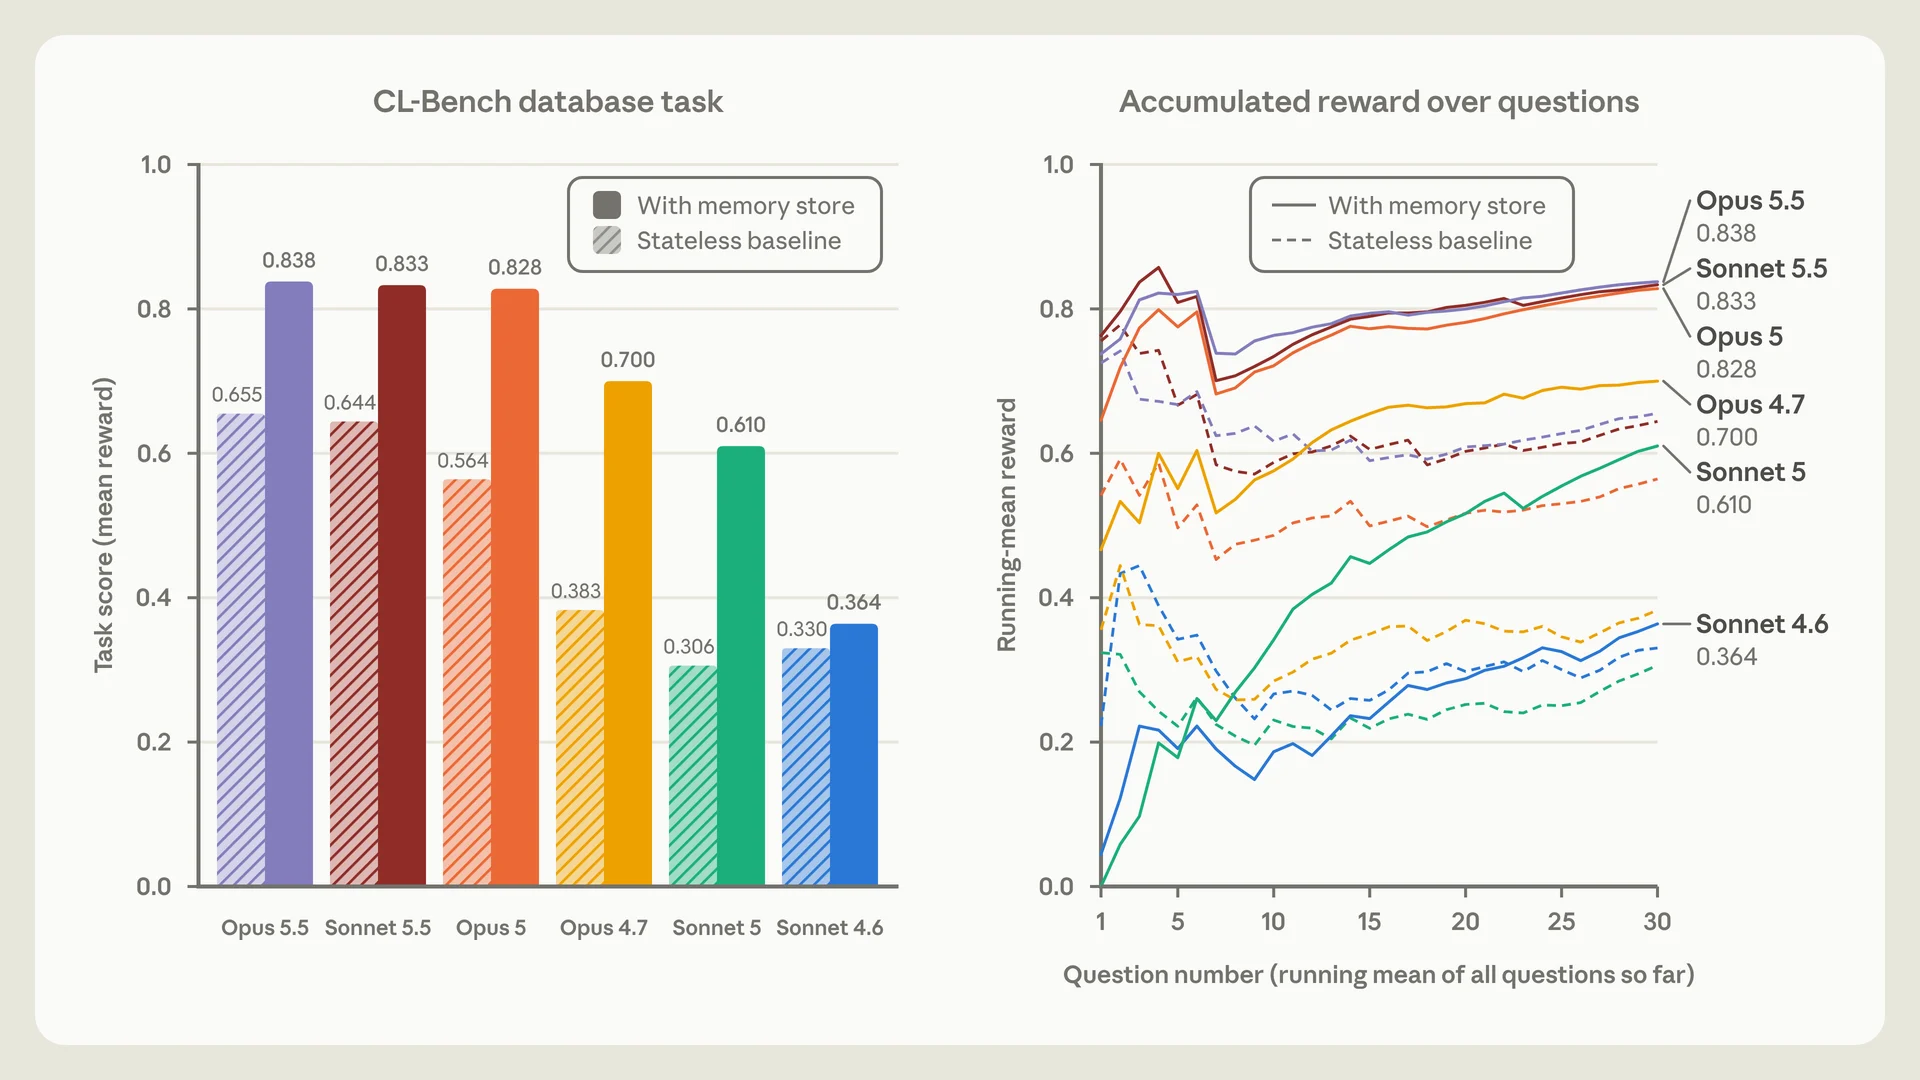
图源:Anthropic 工程博客,图 3 (opens new window)
这项数据库测评每题都开启新会话,开启记忆的那组可以读写跨会话保留的文件。
左图里,Sonnet 5 的平均奖励从 0.306 提到 0.610,Sonnet 4.6 则从 0.330 提到 0.364,同样给一个记忆目录,收益差距很大。
右图每个点是截至该题的累计平均奖励,可以看到这种差距是怎么随答题进程拉开的。
同一项任务里,明确要求 Sonnet 4.6 先读笔记、再验证猜测,平均奖励才从 0.364 提到 0.641。
这个结果提醒我们,评测记忆时还要看 Agent 有没有主动读取笔记,以及有没有验证笔记里的判断。
同一评测里,「只记失败」削弱了 Opus 5 和 Opus 4.7 的记忆收益,说明验证过的成功经验也值得留下。
Dreaming 把复盘放到后台。
它可以拿旧笔记和会话记录对照,发现冲突后修订条目。
它也可以跨多次会话补笔记、重组 Wiki,或把少量高价值条目提升到启动层。
后台整理需要额外算力,产物也有延迟。
遇到日志只保留了模型自述、缺少工具结果的情况,条目只能标成待核验。
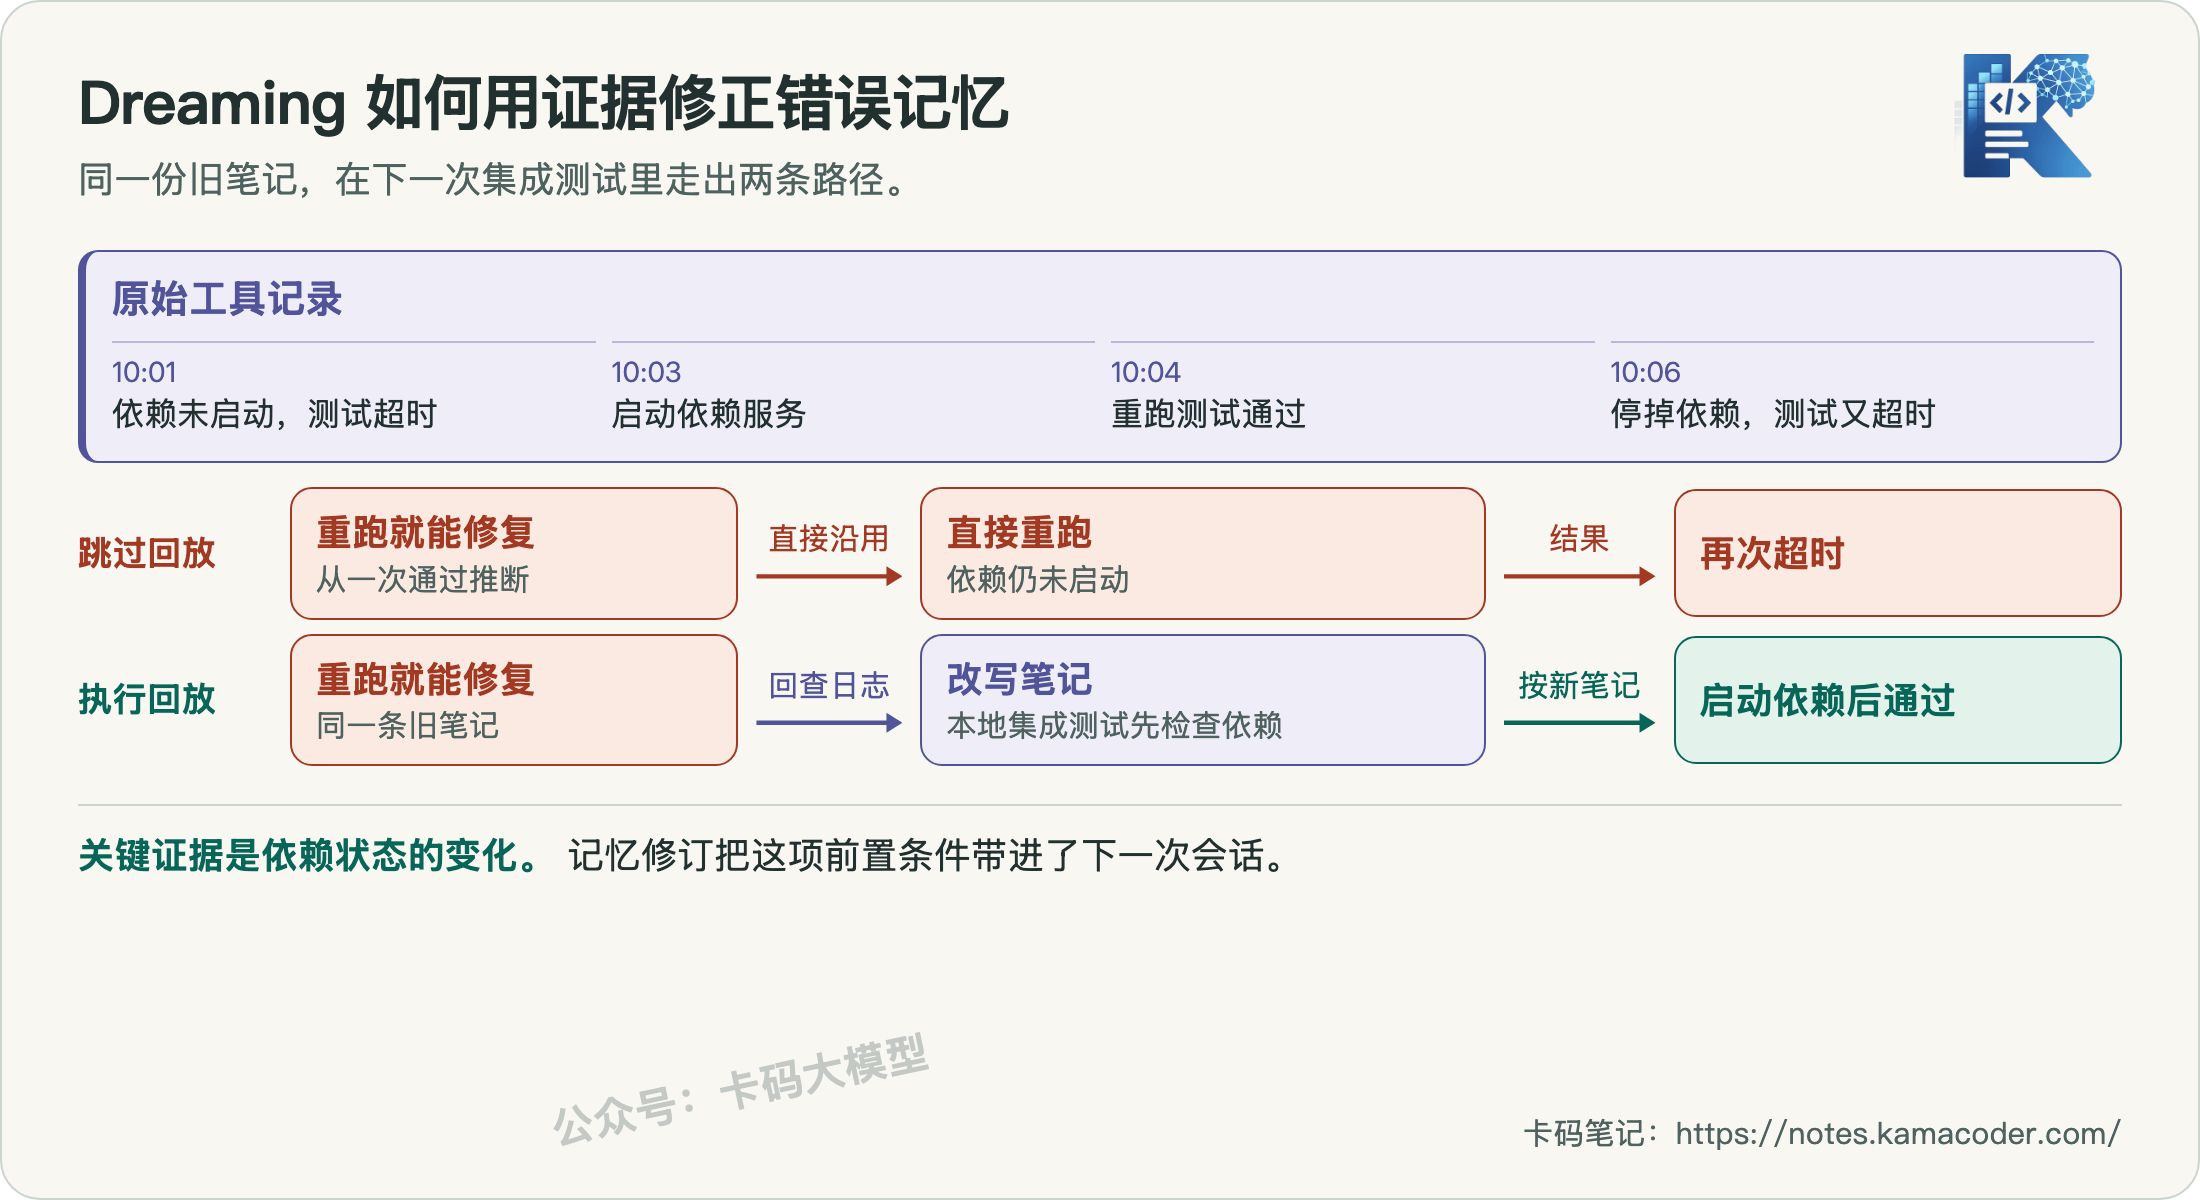
集成测试的例子里,旧笔记让 Claude 直接重跑,回查日志后,Claude 会先验证依赖。
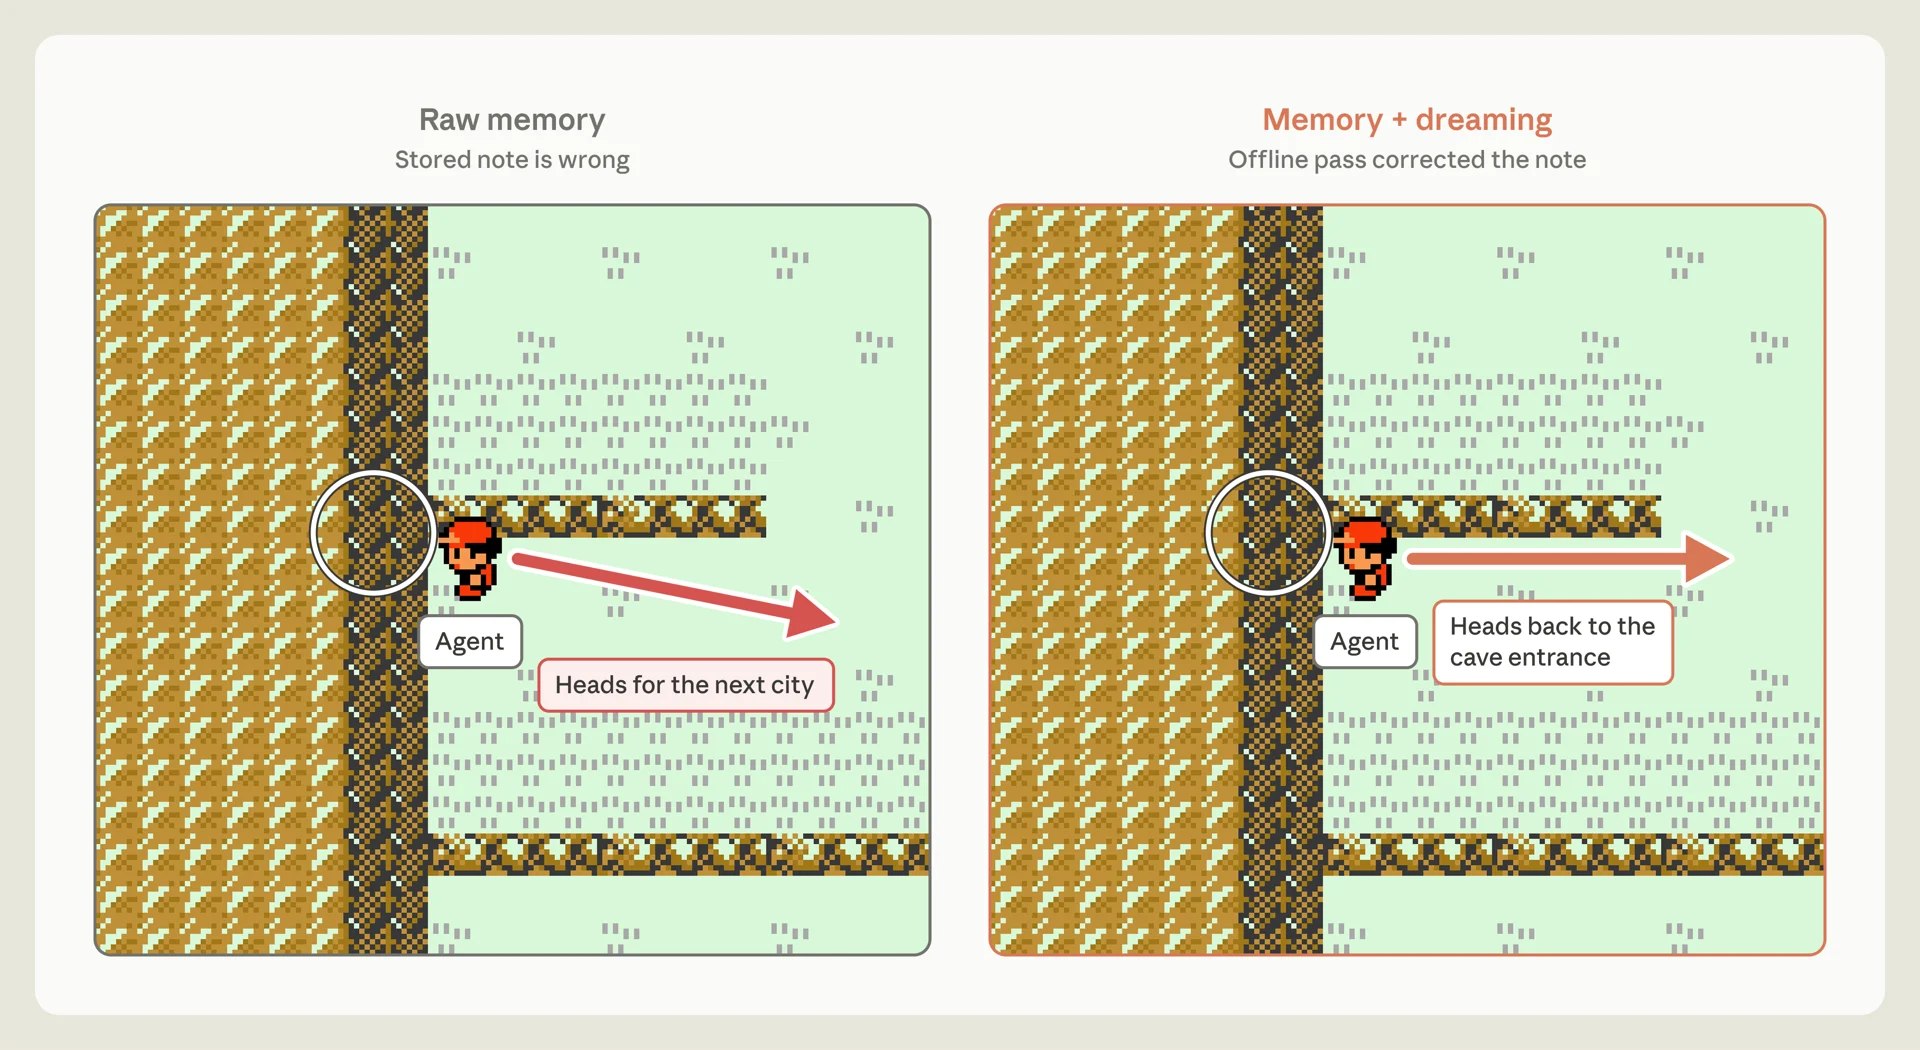
图源:Anthropic 工程博客,图 7 (opens new window)
Anthropic 在《宝可梦 红》里观察到了同样的机制,左右两图是同一个岔路口,变化的是 Claude 手里的笔记。
左图里,Claude 把月见山西侧入口附近的宝可梦中心记成了山的东侧,以为自己已经穿过山洞,结果沿着单向台阶掉回原路。
右图里,Dreaming 回查会话记录并纠正了地标的位置,Claude 重新进洞,后来抵达了下一座城市。
这次复盘纠正的是 Agent 对当前位置的判断,下一步该往哪走也就变了。
# 三、Wiki 提前做的活,是把跨来源的关系整理出来
写一份交接文档时,往往要从故障记录找现象、从配置找条件、从测试找验证方法。
直接搜索也能拼出答案,但类似问题问十次,Agent 可能得拼十次。
主题页可以提前把关联连起来,让下一次检索从正确的地方起步。
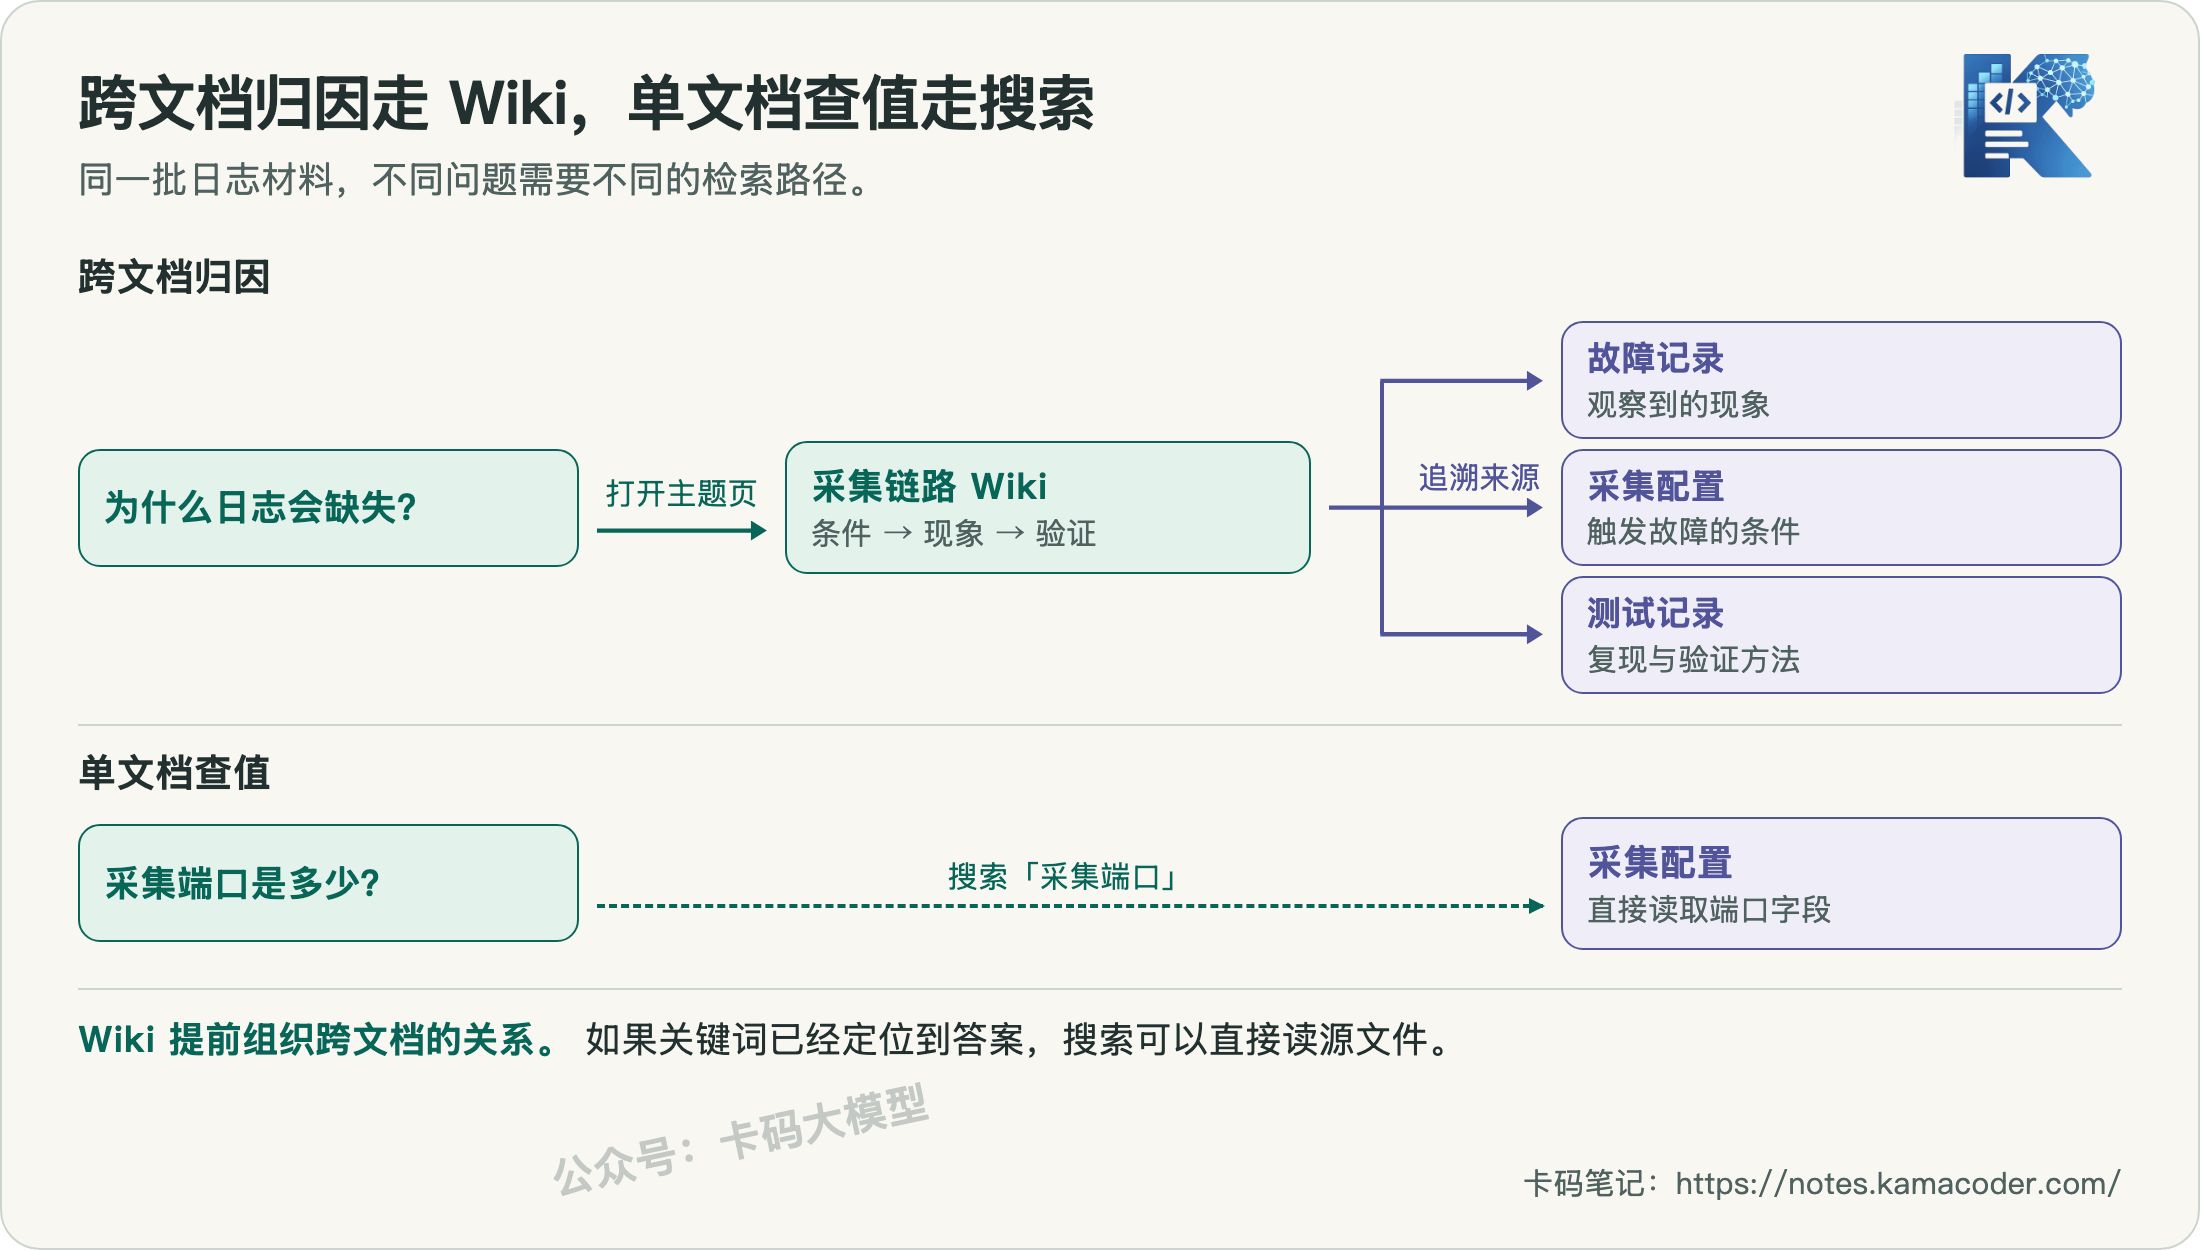
跨文档归因时,Wiki 把散在各处的线索串到一起,原文仍然用来核对关键结论。
单文档查值时,关键词已经能直接定位答案,多读一份主题页会增加一跳。
Anthropic 在 Stainless 的内部文档上做了 25 道题。
成熟 Wiki 配合搜索达到 61% 的评分项,只用搜索是 53%,只用 Wiki 的最高成绩是 48%。
原文还记录了一个反例:生成的 Wiki 比源文档大 77%,维护成本上去了,压缩和导航的价值却没做出来。
# 四、自己做 Agent,先跑通一次跨会话复用
你可以用最容易重复踩的一条坑来做实验。
第一次会话跑任务、记规则时,给笔记留下适用范围和原始证据的位置。
第二次用空白会话重放同类任务,看 Agent 能不能主动找到这条笔记。
再换个环境试一次,看它会不会把办法用到不适用的地方。
想加后台整理,可以优先回放那些高频命中、反复被纠正或证据已变化的条目。
要验证收益,就保留一组「只搜日志」做对照。
记录任务通过率、错误沿用率,以及每次回答和后台整理各自花了多少 token。
先挑一条曾让 Agent 走错两次的记忆,看看第三次它会怎么走。
# 参考链接
- Anthropic 工程博客(The components of agent memory):https://www.anthropic.com/research/components-of-agent-memory
- Claude Code 官方文档(Auto Memory):https://code.claude.com/docs/en/memory
评论
验证登录状态...