# 现代LLM的四大改进:RoPE、RMSNorm、SwiGLU、GQA
上一篇《MoE:稀疏模型为什么越来越流行》讲了用多个专家替换FFN,让参数变多、计算不跟着变多。
但打开Llama的配置文件,你会发现就算不用MoE,它的Block也和《一层Transformer Block的前向过程》里的标准结构不一样。
位置编码、归一化、FFN、注意力,四个地方都换了零件。 面试问"Llama相比Transformer改了什么",问的就是这四处。
# 面试官会怎么问
"Llama相比原始Transformer做了哪些改进?为什么用RoPE不用正弦位置编码?GQA比MHA好在哪?"
很多录友会回答:
"Llama用了RoPE、RMSNorm、SwiGLU、GQA,这些都是更先进的技术。"
这句话只是把名字背出来了。
第一,没说改的是哪个瓶颈。 面试官追问"正弦编码哪里不够用",就答不上来了。
第二,没说机制。 RoPE到底旋转了什么?GQA共享的是Q还是KV?说不清机制,面试官会认为你只看过博客标题。
第三,没说代价。 SwiGLU多了一个矩阵,参数量变没变?GQA省了显存,丢了什么?不讲代价,就讲不出工程判断。
面试官想听的是:每处改动针对哪个瓶颈,用什么机制解决,付出了什么代价。
# 简要回答
- RoPE替代正弦位置编码。 正弦编码把绝对位置加到输入上,相对位置要靠模型自己学;RoPE按位置旋转Q和K,点积结果只取决于相对距离,还能配合位置插值扩展上下文。
- RMSNorm替代LayerNorm。 不减均值、不加偏置,只除以均方根,少一次统计量计算,效果基本持平。
- SwiGLU替代ReLU/GELU的FFN。 多一个门控矩阵,按位置决定每个维度放行多少;同时把中间维度从4d缩到约8d/3,参数量基本不变。
- GQA替代MHA。 多个Query头共享一组K、V,推理时KV Cache按比例缩小,效果接近MHA,比全部共享的MQA稳。
四处改动都是工程取舍:在不明显牺牲效果的前提下,让长上下文更好扩展、训练更省、推理更省显存。
# 标准Transformer哪里不够用了?
原始Transformer是2017年为机器翻译设计的,上下文几百个Token,模型几千万参数。
到了几十B参数、几十K到128K上下文的生产场景,四个地方开始成为瓶颈:
| 位置 | 原始方案 | 瓶颈 | 现代替换 |
|---|---|---|---|
| 位置编码 | 正弦绝对位置编码 | 相对位置要靠模型隐式学,难以扩展到更长上下文 | RoPE |
| 归一化 | LayerNorm | 每层多算一次均值,开销累积 | RMSNorm |
| FFN | 两层线性 + ReLU | 逐元素激活,没有门控 | SwiGLU |
| 注意力 | MHA | 每个头独立缓存K、V,长上下文显存吃紧 | GQA |
骨架没变,仍是Decoder-only + 残差 + 注意力 + FFN。 改的是骨架上的零件。
# RoPE为什么能替代正弦位置编码?
《位置编码》讲过,正弦编码把位置向量加到词向量上。
问题在于加上去的是绝对位置。"猫"在第1位、"垫子"在第4位,和同样的短语出现在第101位、第104位,它们拿到的位置向量完全不同。
两个词相距3这个事实,模型只能从数据里慢慢学出来。
RoPE换了思路:不加位置向量,而是把Q和K按位置旋转一个角度。
位置m的Query旋转mθ,位置n的Key旋转nθ。两个向量做点积时,旋转角度相减,结果只和 (n−m)θ 有关。
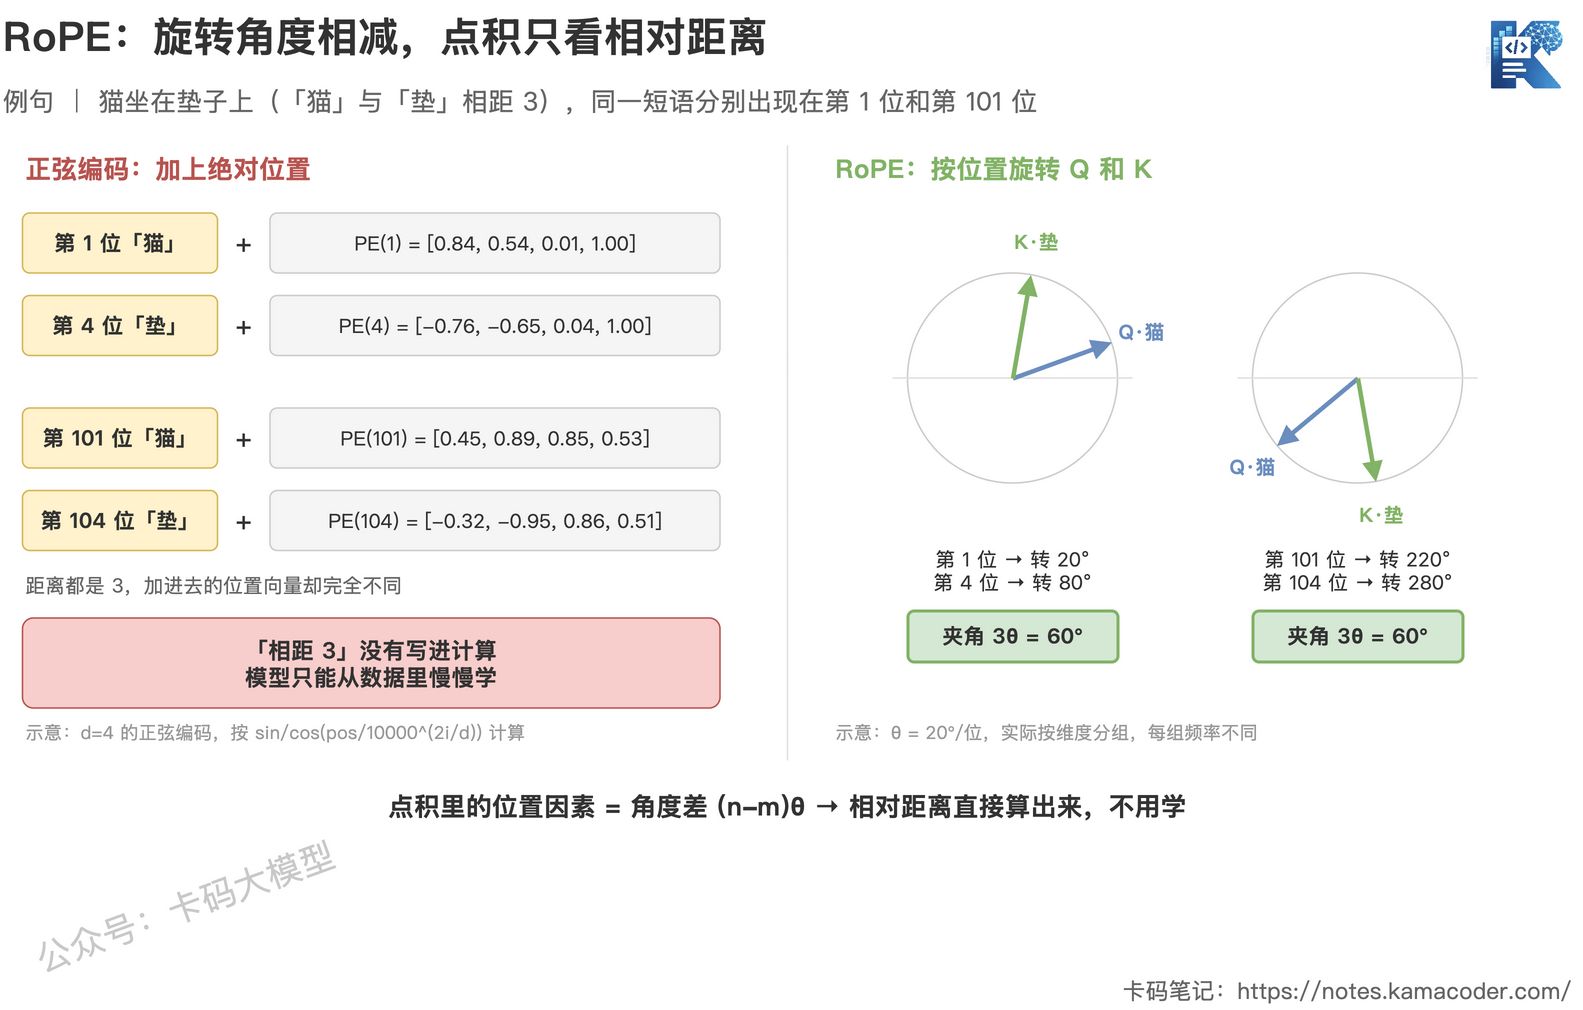
左边正弦编码把绝对位置向量加到输入上,第1位和第101位的「猫」拿到完全不同的位置向量,模型要从数据里学出「相距3」这个关系。右边RoPE按位置旋转Q和K,第1位的「猫」和第4位的「垫」夹角是60°,第101位和第104位的夹角也是60°,点积里的位置因素只看相对距离,不看绝对位置。
所以在RoPE里,第1位和第4位、第101位和第104位,点积里的位置因素完全一样,都是3θ。相对位置不用学,是算出来的。
实际实现时,RoPE把向量每两维分成一组,每组用不同的频率θ旋转,高频组区分近距离,低频组区分远距离。
有一点要说清楚:RoPE本身并不能随意外推。 训练只见过8K长度,直接推理32K,效果照样会崩。
RoPE的优势在于好扩展:位置插值(PI)、NTK缩放、YaRN这类方法,都是调整旋转频率,再配少量长文本继续训练,就能把上下文拉长。Llama 3.1的128K上下文,就是RoPE缩放加长上下文继续训练做出来的。
面试回答:RoPE把相对位置直接写进QK点积,并且可以通过调整旋转频率扩展上下文,这是长上下文模型普遍选它的原因。
# RMSNorm比LayerNorm省在哪?
LayerNorm对一个向量做两件事:减均值(中心化),再除以标准差(缩放),最后乘γ加β。
RMSNorm的论文发现,起主要作用的是缩放,中心化可以去掉。于是它只除以均方根,最后乘γ,不要β。
拿一个4维向量 x = [2, 4, 6, 8] 走一遍:
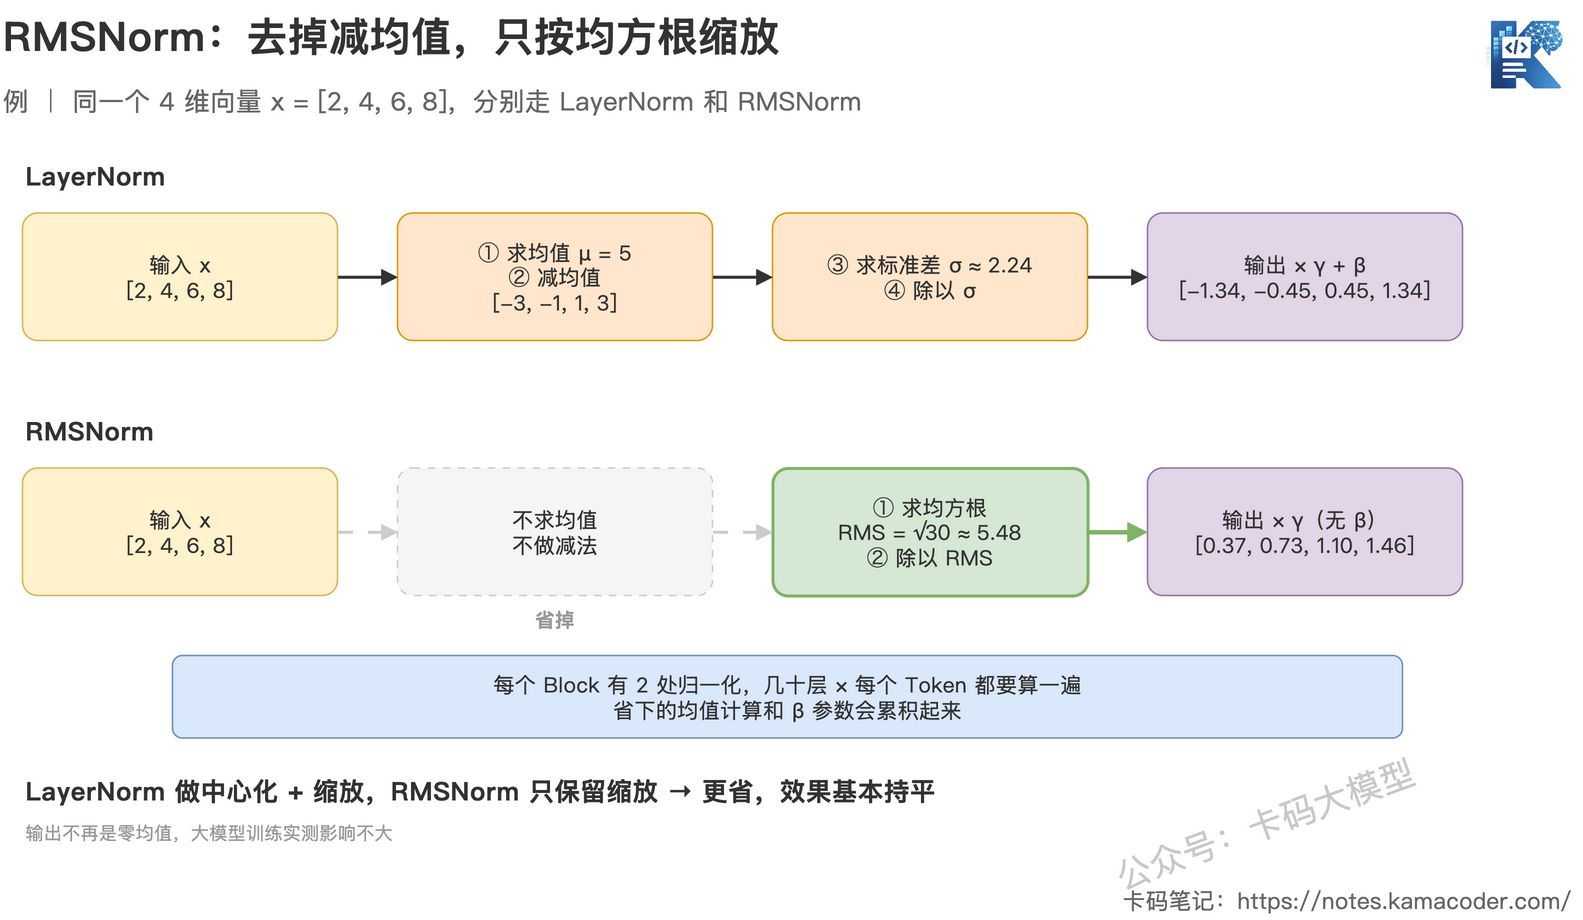
LayerNorm要先算均值5,减完得到 [-3, -1, 1, 3],再算标准差约2.24,最后得到 [-1.34, -0.45, 0.45, 1.34]。RMSNorm直接算均方根 √((4+16+36+64)/4) = √30 ≈ 5.48,一除得到 [0.37, 0.73, 1.10, 1.46]。灰色虚线框标出了省掉的步骤:不求均值、不做减法、不要偏置β。
少一次求均值、少一次减法、少一个β参数。 单次看省得不多,但每个Block有两处归一化,几十层叠加,再乘上每个Token,就是可观的开销。RMSNorm论文在不同模型上报告了7%到64%的运行时间减少,效果和LayerNorm基本持平。
RMSNorm的输出不再是零均值。实践证明这对大模型训练影响不大,Llama、Qwen、Mistral、DeepSeek都用RMSNorm。
面试回答:RMSNorm去掉中心化,只保留按均方根缩放,计算更省,效果基本不掉。
# SwiGLU给FFN加了什么?
《残差连接、LayerNorm、FFN》讲过,标准FFN是两层线性中间夹一个激活函数:
FFN(x) = W2 · ReLU(W1 · x)
ReLU是逐元素的,每个维度只看自己的值大于0还是小于0,然后决定放行还是截断。
SwiGLU多加一条门控路径:
FFN(x) = W2 · ( Swish(W1 · x) ⊙ (W3 · x) )
W1 · x 经过Swish激活后变成门,W3 · x 是内容,两者逐元素相乘。门值由当前Token的输入算出来,同一个维度对不同Token可以放行不同的比例。
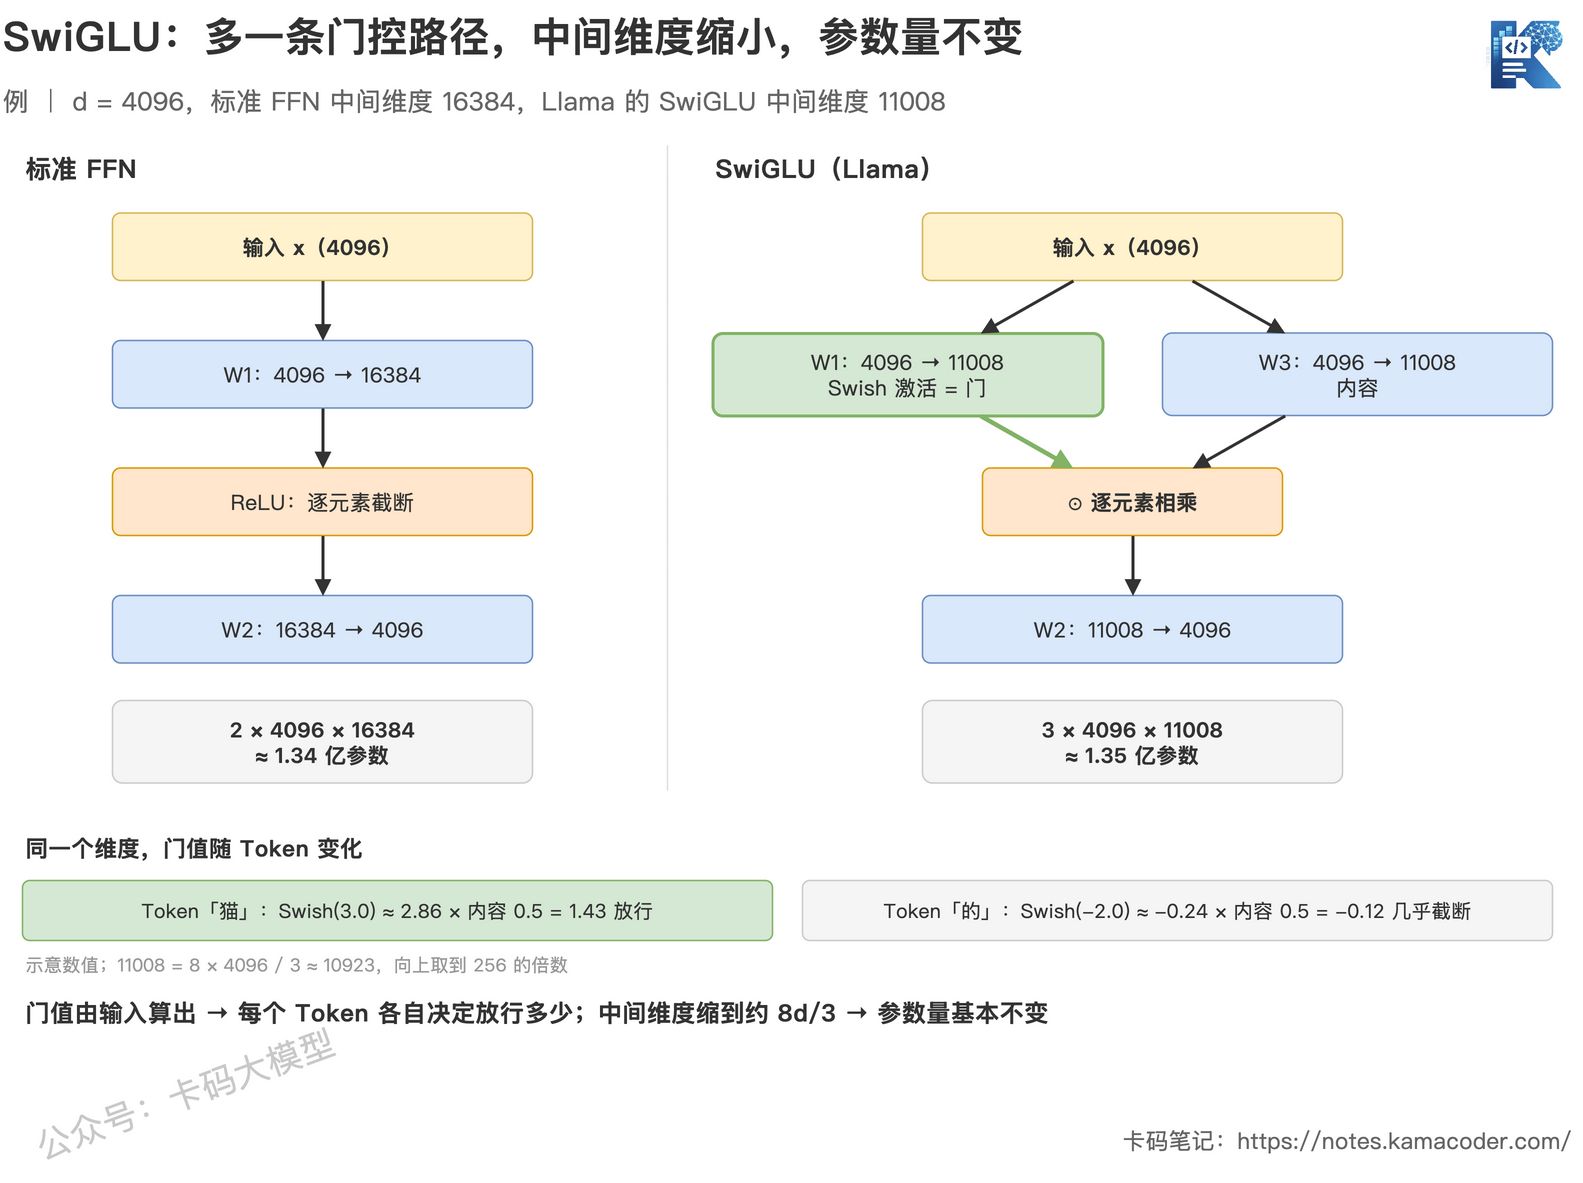
标准FFN:4096 → 16384 → ReLU → 4096,参数约1.34亿。SwiGLU分两路:一路经过Swish变成门,另一路是内容,两路逐元素相乘后再投影回4096。因为中间维度缩到11008(约8×4096/3),三个矩阵加起来仍约1.35亿参数。下方的数值例子展示同一维度对不同Token放行比例不同:「猫」的门值接近3,内容基本通过;「的」的门值接近0,内容几乎截断。
很多录友会以为SwiGLU多了一个矩阵,参数就多了50%。
Llama的做法是把中间维度从4d缩到约8d/3。以d=4096为例:
- 标准FFN:2个矩阵 × 4096 × 16384 ≈ 1.34亿参数
- Llama的SwiGLU:3个矩阵 × 4096 × 11008 ≈ 1.35亿参数
11008是8×4096/3≈10923向上取到256的倍数。参数量基本不变,矩阵从两个变成三个。
GLU变体的论文在相同计算量下对比过,带门控的FFN困惑度更低,所以这笔交换是划算的。
面试回答:SwiGLU用一条门控路径按输入调节每个维度的放行比例,Llama通过缩小中间维度保持参数量不变。
# GQA为什么能省下大量显存?
《KV Cache为什么会吃光显存》讲过,生成时每个Token每一层的K、V都要缓存下来。
MHA里每个Query头都有自己的K、V头,所以KV Cache大小和头数成正比。
拿Llama 3 70B的结构算:80层,64个Query头,每头128维,用BF16存储。
如果用MHA,64个KV头,每个Token要缓存:
2(K和V) × 80层 × 64头 × 128维 × 2字节 ≈ 2.5 MiB
单个请求跑满128K上下文,KV Cache就是 320 GiB,比模型权重本身还大。
三种方案的区别就在KV头的数量:
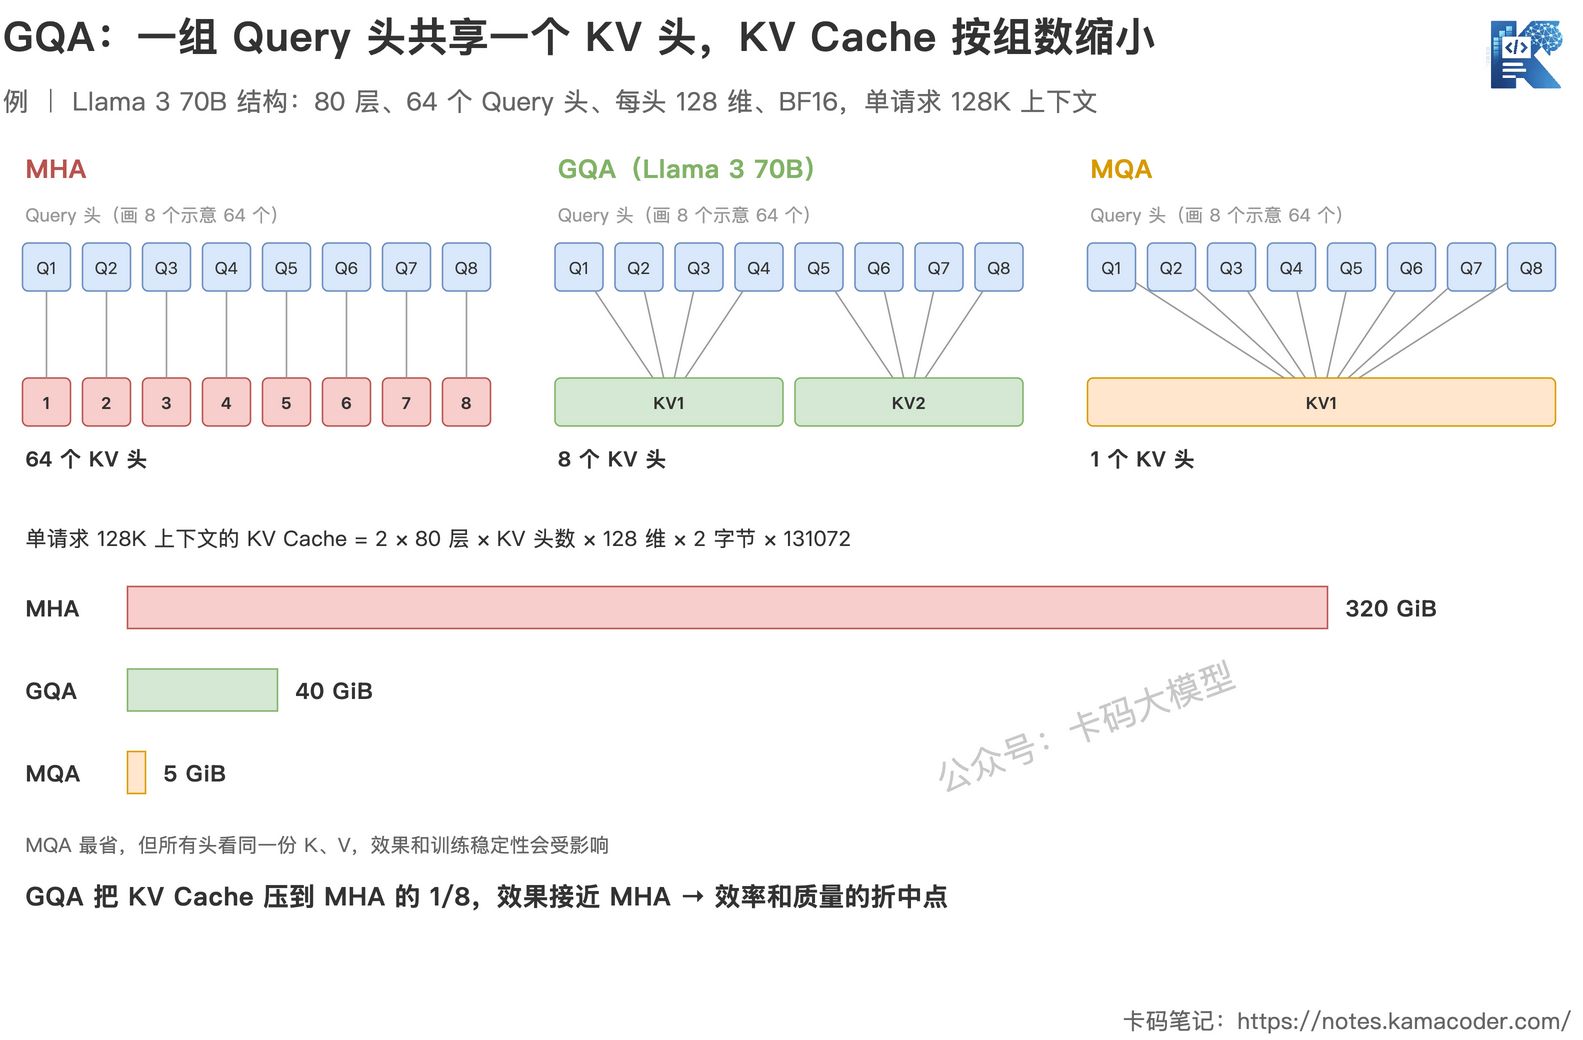
上方画了8个Query头示意64个头的结构。MHA:64个Query头配64个KV头,每个头独立;GQA:64个Query头分成8组,每组8个头共享1个KV头;MQA:64个Query头全部共享1个KV头。下方条形图对比单个请求128K上下文的KV Cache:MHA 320 GiB,GQA 40 GiB,MQA 5 GiB。
- MHA:64个Query头配64个KV头,320 GiB;
- MQA:64个Query头共享1个KV头,5 GiB,但所有头只能看同一份K、V,效果和训练稳定性会受影响;
- GQA:64个Query头分成8组,每组共享1个KV头,40 GiB。
Llama 3 70B实际用的就是8个KV头的GQA。显存降到MHA的1/8,GQA论文的实验里效果接近MHA,明显好于MQA。
GQA还有一个工程上的好处:已经训练好的MHA模型,可以把同组的KV头取平均,再少量继续训练,转成GQA。
面试回答:GQA让一组Query头共享一个KV头,KV Cache按组数比例缩小,在MHA的效果和MQA的效率之间取了折中。
# 知识拓展
# 所有现代模型都同时用这四个改进吗?
不是。Llama 2只有34B和70B用了GQA,7B和13B仍是MHA;到Llama 3,8B也换成了GQA。
DeepSeek-V2/V3用了RoPE、RMSNorm和SwiGLU,但注意力换成了MLA(多头潜在注意力):把K、V压缩成低维潜在向量再缓存,比GQA省得更狠。
所以面试时别说"现代模型都用GQA",要说"KV Cache压缩是共同方向,GQA是最普遍的方案,MLA是更激进的方案"。
# RoPE的θ为什么要调大?
原始RoPE的频率基数是10000,Llama 3把它调到了500000。
基数越大,低频组转得越慢,远距离位置的角度越不容易绕回原点,长上下文更容易区分。这也是NTK缩放这类方法的核心思路:调频率,不改结构。
# GQA的组数怎么选?
组数越少,越接近MQA,越省显存;组数越多,越接近MHA,效果越稳。
常见的选择是8个KV头左右,同时要能和张量并行的切分数对齐,比如8卡张量并行时,每张卡正好分到1个KV头。
组数是显存、效果和并行切分一起决定的,不是只看效果。
# 这些改进对应用开发者有什么用?
做应用不用改模型结构,但这些知识会直接影响你的判断:
- 看到模型配置里
num_key_value_heads小于num_attention_heads,就知道它用了GQA,能估出KV Cache和并发上限; - 看到
rope_scaling字段,就知道上下文是靠RoPE缩放扩出来的,超长输入要实测效果,不能只看宣传的窗口大小; - 做部署选型、压测容量时,KV Cache估算直接决定一张卡能跑多少并发。
# 参考论文
- RoFormer: Enhanced Transformer with Rotary Position Embedding:https://arxiv.org/abs/2104.09864
- Root Mean Square Layer Normalization:https://arxiv.org/abs/1910.07467
- GLU Variants Improve Transformer:https://arxiv.org/abs/2002.05202
- GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints:https://arxiv.org/abs/2305.13245
- LLaMA: Open and Efficient Foundation Language Models:https://arxiv.org/abs/2302.13971
# 结尾
Llama没有发明新架构,它把标准Transformer上四个不适合大规模生产的零件换掉了。
面试时别只报名字,每个改进都要讲清三件事:改了哪个瓶颈,机制是什么,付出了什么代价。
能把RoPE的相对位置、GQA的320 GiB讲清楚,这道题就答到位了。
评论
验证登录状态...