# Python中的匿名函数、map、filter和reduce怎么用?
面试官问:"Python的lambda、map和filter怎么用?和列表推导式比哪个更好?"
很多人知道lambda可以写匿名函数,map可以批量处理,但说不清楚返回值是什么、什么时候该用列表推导式,以及reduce为什么被移出内置函数。
# 简要回答
lambda定义匿名函数,语法是lambda 参数: 表达式,常用于需要简单函数对象的场景。
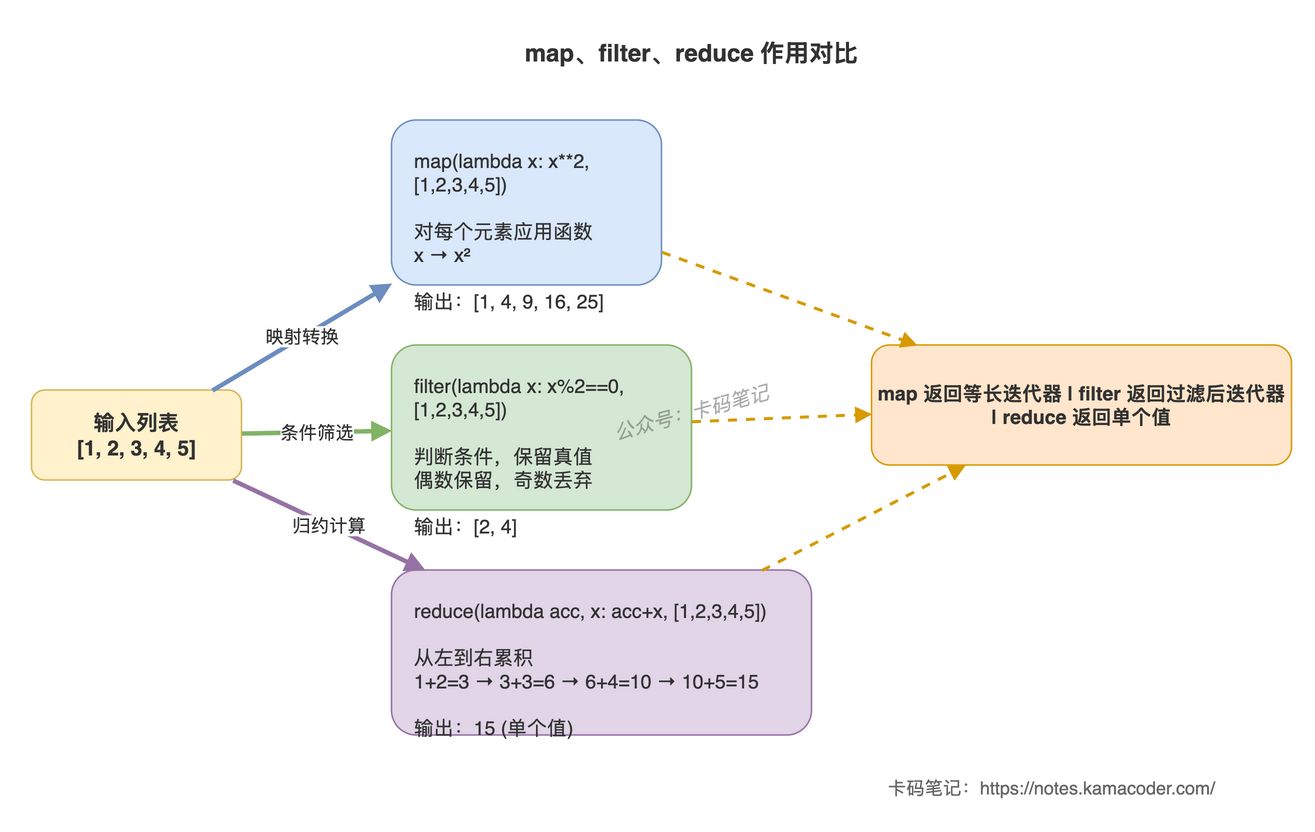
map(func, iterable)对可迭代对象中的每个元素应用函数,返回迭代器。filter(func, iterable)筛选出使函数返回真值的元素,也返回迭代器。reduce(func, iterable)从左到右累积,归约为单个值,在functools模块中。
列表推导式通常比map和filter更清晰,尤其是涉及条件判断或多步操作时。lambda适合一次性的简单函数,复杂逻辑应该用def。
# 详细回答
# lambda匿名函数
# 等价的def和lambda
def add(x, y):
    return x + y

add_lambda = lambda x, y: x + y

print(add(2, 3))         # 5
print(add_lambda(2, 3))  # 5
2
3
4
5
6
7
8
lambda只能包含一个表达式,不能包含语句(如if语句、赋值、return)。返回值是表达式的计算结果。
常见用途是作为参数传递:
students = [
    {"name": "Alice", "score": 85},
    {"name": "Bob", "score": 92},
    {"name": "Charlie", "score": 78}
]

# 按分数排序
sorted_students = sorted(students, key=lambda s: s["score"])
print([s["name"] for s in sorted_students])  # ['Charlie', 'Alice', 'Bob']
2
3
4
5
6
7
8
9
# map映射操作
numbers = [1, 2, 3, 4, 5]
squared = map(lambda x: x ** 2, numbers)

print(squared)         # <map object at 0x...>
print(list(squared))   # [1, 4, 9, 16, 25]
2
3
4
5
map返回迭代器,不是列表。迭代器是惰性的,只有在需要时(如转换为列表或遍历)才计算结果。
等价的列表推导式:
squared = [x ** 2 for x in numbers]
对于简单映射,列表推导式可读性更好。
# filter过滤操作
numbers = [1, 2, 3, 4, 5, 6]
even_numbers = filter(lambda x: x % 2 == 0, numbers)

print(list(even_numbers))  # [2, 4, 6]
2
3
4
filter也返回迭代器,保留使函数返回真值的元素。
等价的列表推导式:
even_numbers = [x for x in numbers if x % 2 == 0]
# reduce归约操作
reduce在Python 3中被移到functools模块:
from functools import reduce

numbers = [1, 2, 3, 4, 5]
total = reduce(lambda acc, x: acc + x, numbers)
print(total)  # 15
2
3
4
5
reduce从左到右累积,第一次调用时acc是序列的第一个元素,x是第二个元素;之后acc是上一次的返回值。
可以提供初始值:
total = reduce(lambda acc, x: acc + x, numbers, 0)
对于求和,直接用sum(numbers)更清晰。reduce适合更复杂的累积逻辑。
# map和filter的组合
numbers = [1, 2, 3, 4, 5, 6]
result = list(map(lambda x: x ** 2, filter(lambda x: x % 2 == 0, numbers)))
print(result)  # [4, 16, 36]
2
3
先过滤出偶数,再平方。但这样的链式调用可读性不如列表推导式:
result = [x ** 2 for x in numbers if x % 2 == 0]
# 何时用列表推导式
- 需要立即得到列表。
- 涉及条件判断或多步操作。
- 可读性优先。
# 推荐
result = [x ** 2 for x in numbers if x % 2 == 0]

# 不推荐
result = list(map(lambda x: x ** 2, filter(lambda x: x % 2 == 0, numbers)))
2
3
4
5
# 何时用map和filter
- 函数已经存在,不需要
lambda。 - 需要惰性求值,不立即计算所有结果。
- 与其他接受可迭代对象的函数组合。
# 函数已经存在
numbers = ["1", "2", "3"]
integers = map(int, numbers)  # 比[int(x) for x in numbers]简洁

# 惰性求值
for x in map(expensive_function, huge_list):
    if x > threshold:
        break  # 不需要计算所有元素
2
3
4
5
6
7
8
# lambda的限制
lambda只能包含表达式,不能包含:
- 赋值语句:
lambda x: y = x + 1(语法错误) if语句:可以用三元表达式lambda x: "even" if x % 2 == 0 else "odd"- 多行代码:复杂逻辑用
def定义函数
lambda没有名字,调试时栈信息只显示<lambda>,不如命名函数清晰。
# 知识拓展
Q1:map返回的迭代器能遍历多次吗?
不能。迭代器遍历一次后就耗尽了:
squared = map(lambda x: x ** 2, [1, 2, 3])
print(list(squared))  # [1, 4, 9]
print(list(squared))  # [],已经耗尽
2
3
需要多次使用时,先转换为列表。
Q2:reduce为什么被移出内置函数?
Python创始人Guido认为reduce可读性不如显式循环,且大多数常见用途(求和、求积、连接)有更清晰的替代方案(sum、math.prod、"".join)。只有复杂的累积逻辑才需要reduce。
Q3:map可以接受多个可迭代对象吗?
可以:
a = [1, 2, 3]
b = [4, 5, 6]
result = list(map(lambda x, y: x + y, a, b))
print(result)  # [5, 7, 9]
2
3
4
lambda的参数数量要和可迭代对象数量匹配。
Q4:filter传入None会怎样?
filter(None, iterable)过滤出真值元素:
values = [0, 1, False, True, "", "hello", None, []]
result = list(filter(None, values))
print(result)  # [1, True, 'hello']
2
3
Q5:列表推导式和map性能差异大吗?
在CPython中,列表推导式通常稍快,因为它是专门优化的字节码。但差异很小,可读性比微小性能差异更重要。需要惰性求值时,map和生成器表达式更合适。
评论
验证登录状态...