# 理想智能应用研发一面:手撕四数之和,面试官说“让 AI 写,要求一次过”
面经时间:2026年10月10日
这次分享一篇理想智能应用研发一面面经,前半场围着实习项目确认“你具体做了什么”,后半场直接让候选人用 AI 写算法题。
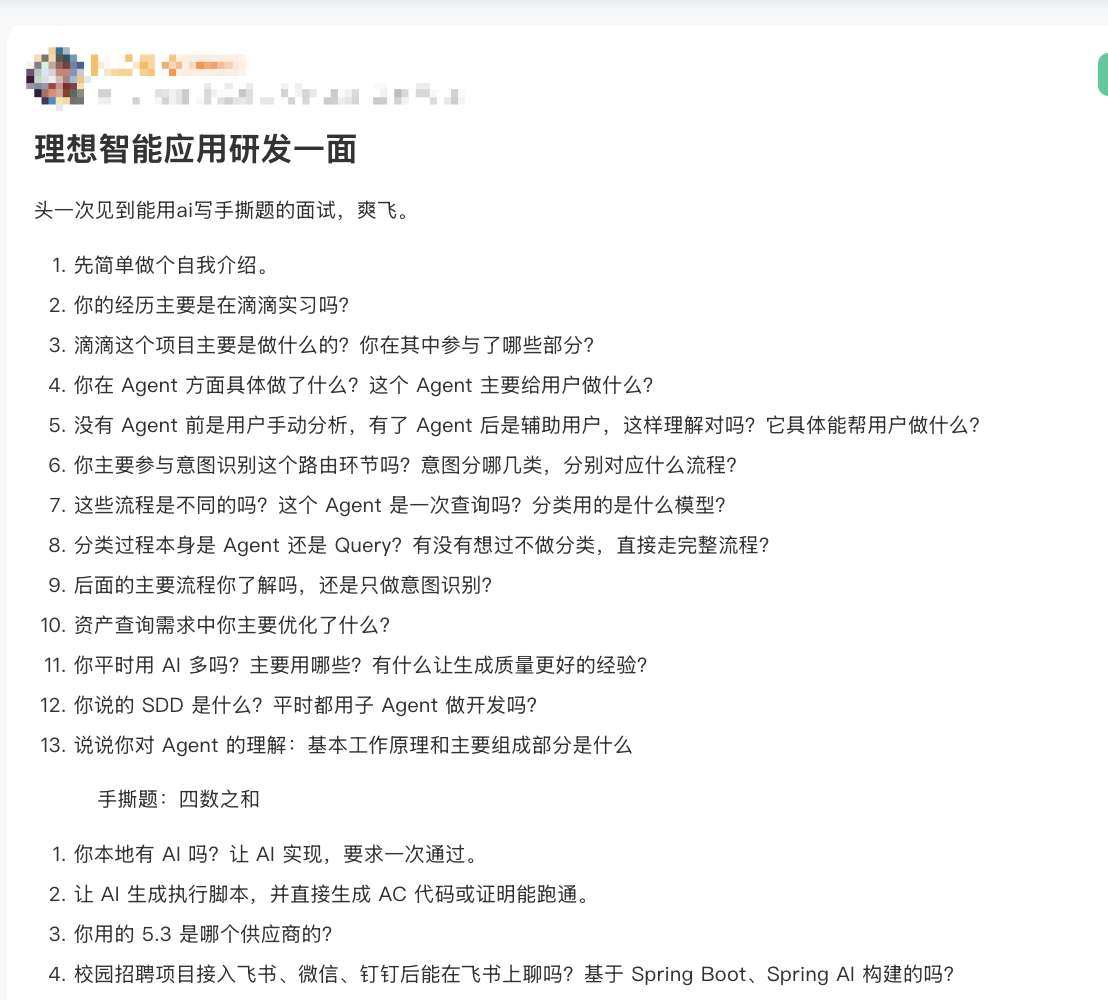
面经里候选人开头就一句就是:“头一次见到能用 AI 写手撕题的面试,爽飞。”
但面试官接着加了要求:本地有没有 AI?让它实现四数之和,要求一次通过;再生成执行脚本,直接交付 AC 代码或者证明能跑通。
允许用 AI 之后,代码怎么写出来只是其中一步。需求有没有讲清、程序有没有真的执行、边界有没有检查,仍然要自己负责。
面经没有给出候选人的完整回答。
所以为了让大家有一个参考,我这里会给大家补充参考回答,让大家了解这些面试题应该怎么答更合适。
我也会虚拟一些业务细节、意图划分和优化方案,这是为了回答面试题里的业务场景。
关于很个人的问题,我就不给示范回答了。
本次面经问题:
- 一、先简单做个自我介绍
- 二、你的经历主要是在滴滴实习吗?
- 三、滴滴这个项目主要做什么,你参与了哪些部分?
- 四、你在 Agent 方面具体做了什么,它主要给用户做什么?
- 五、没有 Agent 前用户手动分析,有了以后辅助用户,具体能帮到哪一步?
- 六、你主要参与意图识别路由吗,意图分哪几类,分别对应什么流程?
- 七、这些流程有什么不同,Agent 是一次查询吗,分类用什么模型?
- 八、分类过程本身是 Agent 还是 Query?能不能不分类,直接走完整流程?
- 九、后面的主要流程了解吗,还是只做意图识别?
- 十、资产查询需求中,你主要优化了什么?
- 十一、平时用 AI 多吗,主要用哪些,有什么提升生成质量的经验?
- 十二、SDD 是什么,平时都用子 Agent 做开发吗?
- 十三、怎么理解 Agent,它的工作原理和主要组成部分是什么?
- 十四、手撕四数之和,算法怎么实现?
- 十五、本地有 AI 吗,让 AI 实现并要求一次通过,怎么组织这次任务?
- 十六、让 AI 生成执行脚本,直接给 AC 代码或证明能跑通,怎么验证?
- 十七、你用的“5.3”是哪个供应商的?
- 十八、校园招聘项目接入飞书、微信、钉钉后,能在飞书上聊吗?是基于 Spring Boot、Spring AI 构建的吗?
# 二、你的经历主要是在滴滴实习吗?
这是一道确认经历的问题,按简历直接回答。主要相关经历确实在滴滴,就说明实习所属方向、持续时间和负责范围;还有其他相关经历,也可以简短补充。
我会把“团队项目做什么”和“个人交付什么”分开说。例如:“团队做的是一套查询与分析助手,我主要参与入口意图路由和资产查询链路,其他分析模块了解接口和执行过程,但不是主要开发者。”
接下来面试官大概率会沿着这个边界深挖。这里说得准确,后面才不会为了维持一个过大的职责范围,不断补自己没做过的事。
# 三、滴滴这个项目主要做什么,你参与了哪些部分?
以本文示例来说,用户想了解某个应用的负责人、接口信息和关联文档,原来要在几个系统里分别查询。助手把自然语言请求转成可执行的查询条件,调用已有服务,再组织带来源的结果。
我的参与部分可以围绕三件事讲:梳理 Query 类型与路由规则;把资产名、环境、时间等条件转成下游能使用的结构;分析错分和查询失败样本,改进具体环节。哪些真正做过,就展开哪些,不把示例清单整体当作自己的经历。
如果要体现贡献,我会拿一条完整请求演示:用户问了什么,原来在哪一步失败,我改了哪个模块,改完用什么样本验证。用户量、准确率和耗时没有记录,就不填一个看起来漂亮的数字。
# 四、你在 Agent 方面具体做了什么,它主要给用户做什么?
我会先回答个人工作:“我主要负责入口理解和路由,以及资产查询方向的接入与优化。”然后再解释整体系统为用户做什么,避免把团队能力都说成个人实现。
比如用户问“测试环境里应用 A 的接口负责人是谁”,入口先识别为资产查询,抽取应用名和环境,再调用有权限的资产服务。拿到结构化数据后,回复负责人信息和对应记录入口;如果应用名不唯一,先让用户补充条件。
复杂请求可能还需要组合多条信息,例如先找应用,再查关联接口,再读取说明文档。个人负责路由,不意味着整个系统只有分类;整个系统有 Agent,也不意味着每个节点都是 Agent。
# 五、没有 Agent 前用户手动分析,有了以后辅助用户,具体能帮到哪一步?
可以这样理解,但“辅助”要落到实际动作。以前用户自己判断去哪个系统、填什么条件、怎么拼结果;助手可以承担请求理解、参数整理、工具调用和信息汇总这些步骤。
例如,“这个应用有哪些接口,分别由谁维护”,可以拆成应用定位、接口查询、负责人关联和结果整理。助手把这些动作串起来,用户不必重复在几个页面之间切换。
但查到负责人,不等于完成根因分析;生成一段分析,也不等于结论已经被业务验证。遇到证据不足、权限不够或对象重名,就返回缺什么条件,不能靠模型把空白补成事实。
衡量价值时,也要对应这些动作:用户是否更快拿到正确结果、需要补充几次信息、结果能否追溯来源,而不只是回答看起来更像人。
# 六、你主要参与意图识别路由吗,意图分哪几类,分别对应什么流程?
如果主要负责这一段,我会直接答是,再给出实际标签定义。本文示例可以分为三类业务意图,并设置澄清或兜底出口:
| 示例意图 | 用户请求 | 对应流程 |
|---|---|---|
| 资产查询 | 应用 A 的负责人是谁? | 抽取对象和条件,调用资产查询服务,返回结构化结果 |
| 知识问答 | 这个接口的接入规范是什么? | 检索相关文档,筛选证据,生成带来源的说明 |
| 关联分析 | 应用 A 与哪些接口有关,分别有什么约束? | 拆解子问题,组合查询与文档证据,汇总结果 |
| 澄清或兜底 | 查一下那个应用 | 补充必要条件,或说明当前不支持的范围 |
类别要按执行差异划分,不能只是给同一条流程换几个名字。“查负责人并解释接入限制”可能同时包含查询和问答,需要支持组合任务,或者允许下游继续分解,不能强行丢掉一半需求。
路由输出也不只有一个标签。我会明确它是否包含实体、约束、缺失字段,以及判定依据。模型自报一个高置信度不代表就可信,阈值要用标注集验证,尤其要关注“本应澄清却直接查错对象”的样本。
# 七、这些流程有什么不同,Agent 是一次查询吗,分类用什么模型?
不同主要体现在数据来源、执行步骤和验收方式。资产查询检查对象和字段是否匹配;知识问答检查证据是否支持答案;关联分析还要检查多步结果能否拼起来。不能只看它们最后都输出了一段文字,就说是同一个过程。
用户发来一次请求,不代表后端只执行一次查询。一个入口请求可以触发多次模型调用和多个工具调用;反过来,一次简单资产查询也可能直接通过固定服务完成,不需要让模型循环很多轮。
原面经里,候选人没有给分类模型的名称,因此这里不能补成某个具体型号。现场要说清实际模型与版本、是否微调、输入是否带历史、输出怎么约束,以及分类结果如何评测。只说“用了一个大模型”,还不足以解释选型。
如果要比较模型,我会固定标签定义和测试集,看各类准确率、召回率、混淆矩阵、端到端任务完成情况,以及延迟和费用。模型更贵,不自动意味着这个分类任务更合适。
# 八、分类过程本身是 Agent 还是 Query?能不能不分类,直接走完整流程?
Query 是用户输入,分类是处理这个输入的一次操作,两者不是同一层概念。如果流程只是“读 Query → 输出标签 → 进入固定分支”,我会把它叫分类器或路由节点,而不会单凭调用了模型就称为完整 Agent。
当然可以不设置独立分类器,让一个 Agent 根据工具描述直接选择后续动作;也可以把所有请求交给统一流程。但“统一入口”不等于每个请求都必须把检索、查询、分析全部执行一遍。
显式路由的价值是减少不必要步骤、缩小可选工具范围,便于按场景评测;代价是多一层开销,而且错分可能提前走错路。统一 Agent 更灵活,但可能增加决策成本和调试难度。两种方案要在相同样本上比较,不能因为架构里写了 Router,就默认它必需。
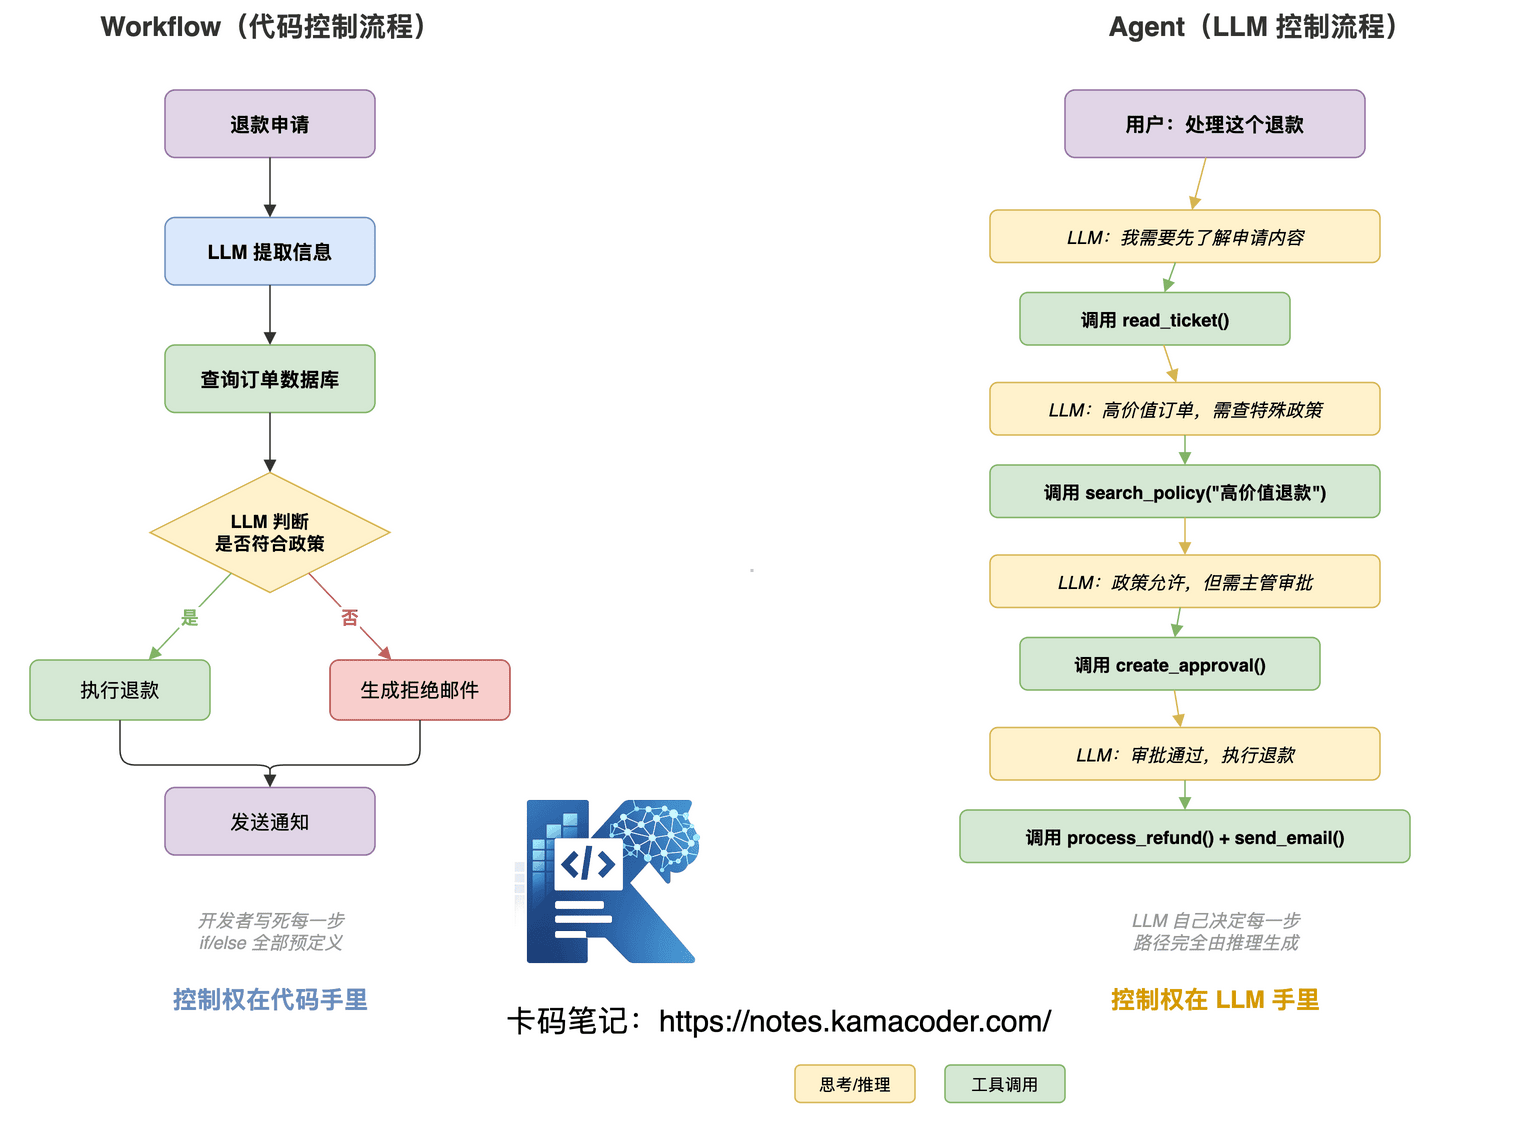
这张图可以用来解释本题的边界:哪些路径由代码预先确定,哪些下一步由模型结合结果选择。流程与角色的区别,也可以结合Agent 面试题继续练。
# 九、后面的主要流程了解吗,还是只做意图识别?
我会如实区分“负责实现”和“了解链路”。如果自己只写了入口路由,可以说:“下游不是我主导开发的,但我需要了解请求协议、返回结构和失败条件,否则没法判断路由结果是否真的可用。”
以资产查询为例,我至少要讲清路由输出如何变成查询条件、谁执行接口调用、结果为空怎么处理,以及结果如何组织成用户回复。权限判断由业务服务执行,不能让意图分类结果顺便决定用户有没有权限。
有些下游实现确实不熟,就明确说不熟,而不是临时补一个框架名。可以通过读接口定义、跟一次 Trace、联合排查错分样本,说明自己对整个调用过程了解到了哪一层。
只做一个模块没有问题,问题是说不清它接收什么、交给谁、失败会影响什么。
# 十、资产查询需求中,你主要优化了什么?
这道题要从真实失败样本出发。本文用一个假设问题说明:用户说的是应用简称,资产服务保存的是标准名称,入口虽然分到了“资产查询”,下游却查不到结果。
对此可以建立别名与标准名称映射,保留环境、部门等消歧条件;命中多个对象时返回候选供确认。优化的是实体解析和查询条件,不一定需要重新训练意图分类器,更不能把一个路由问题和数据库慢查询混为一谈。
验证时把原始 Query、目标资产、标准查询条件和预期结果放在一起,对比改动前后的对象匹配、参数完整性、澄清率和最终查询成功情况。正常返回空结果也可能是正确行为,要与解析失败区分。
如果实际优化的是接口性能,就展开查询计划、索引、分页或缓存一致性;如果做的是 Prompt 或分类标签调整,就拿错分样本说明。不要把“准确率提升了”和“接口更快了”合成一句笼统的“效果变好”。
# 十一、平时用 AI 多吗,主要用哪些,有什么提升生成质量的经验?
我会按实际使用的工具讲,不需要把热门产品全部报一遍。更有用的是拿一次任务说明:用它定位相关代码、整理修改方案,再生成实现和测试;最终由自己检查差异、运行验证。
提升质量时,我会把目标、相关代码、限制和验收条件一次说清。比如新增查询接口时,要给已有接口约定,说明分页格式、权限要求、错误返回,以及哪些文件不能改。只说“帮我优化一下”,模型就容易自己补需求。
任务大时先让 AI 阅读和提出方案,确认边界后再修改;任务小时直接做一个可验证的改动。给上下文也要有选择,相关定义和调用链比整仓库无差别塞进去更有用。
生成后,我会看它是否改到了范围外、测试是否验证了真实需求。发现问题就反馈具体输入、预期和实际结果,而不是只说“再认真想想”。
# 十二、SDD 是什么,平时都用子 Agent 做开发吗?
SDD 是 Spec-Driven Development,可以理解为规约驱动开发:先把要做什么、不能做什么、怎么验收写清,再推进设计、任务拆分、实现和验证。实现中发现需求矛盾,要回到规约更新,不能让文档与代码各说一套。
拿资产查询来说,规约要明确“简称重名时先澄清”“无权限时不返回资产详情”“查不到时不编结果”。这些内容可以直接变成验收用例,约束 AI 生成代码时的自由发挥。SDD 不是先写一篇很长的文档,也不是必须使用某个工具。
子 Agent 是执行组织方式,和 SDD 可以配合,但并非必需。读取独立模块、审查修改、梳理测试等任务适合分工;多个 Agent 同时改同一份接口定义,则容易冲突,还增加上下文重复和汇总成本。
我会按任务是否独立、能否清楚验收来决定是否拆分,不会所有开发都开多个子 Agent。更完整的流程可以接着看SDD 面试详解。

图里的反馈回流对应这里的关键动作:发现实现不满足规则,要检查规约和设计,而不是不停给模型补临时提示。
# 十三、怎么理解 Agent,它的工作原理和主要组成部分是什么?
我会把 Agent 解释为围绕目标运行的一套系统:模型根据当前输入和状态提出动作,执行器校验并执行工具,把结果反馈回来,再决定继续、调整方案或结束。具体实现可以显式规划,也可以逐步决策,不要求每个 Agent 都有独立的规划模型。
主要组成包括模型与任务指令、上下文和状态、工具及执行器、控制循环,以及验收和终止条件。记忆、权限、预算、失败恢复与观测,根据场景补齐。框架帮忙连接这些组件,不会替你定义正确的业务目标。
例如用户要求查应用负责人,模型提出资产查询请求,执行器检查参数和用户身份后调用服务,返回实际记录。信息足够就回答;对象不明确就澄清;权限不够就停止。模型不能仅凭一段“负责人应该是某某”完成任务。

这张图强调模型之外的工程组件。回到开头的追问,意图识别是其中一个节点,不能用它替代对完整执行过程的解释。
# 十四、手撕四数之和,算法怎么实现?
先确认要求:四个下标必须不同,四个数之和等于 target,返回的是去重后的数值组合。数组可以有重复值;四元组里的值可以重复,但必须来自不同位置。
我的实现思路是排序,固定前两个下标,再用左右指针找剩下两个数。和偏小就移动左指针,偏大就移动右指针;命中后两边都移动并跳过重复值。前两层循环也要去重,否则会重复输出同一个组合。
四个 int 相加可能溢出,Java 里要在相加前提升到 long,不能先算出溢出的 int 再强转。时间复杂度 O(n³),结果存储另外占空间;双指针扫描只需常数个变量,排序本身的额外空间取决于实现。
面经理,候选人没给出现场语言与输入协议。
下面是 Java 17 补充参考实现,采用单组 ACM 输入:n target,随后是 n 个整数。输出每个去重四元组,每行四个整数;无解输出 []。实际提交应换成题目指定的接口和格式。
import java.util.*;

public class Main {
    static List<List<Integer>> fourSum(int[] nums, long target) {
        Arrays.sort(nums);
        List<List<Integer>> answer = new ArrayList<>();
        int n = nums.length;
        for (int i = 0; i < n - 3; i++) {
            if (i > 0 && nums[i] == nums[i - 1]) continue;
            for (int j = i + 1; j < n - 2; j++) {
                if (j > i + 1 && nums[j] == nums[j - 1]) continue;
                int left = j + 1;
                int right = n - 1;
                while (left < right) {
                    long sum = 0L + nums[i] + nums[j]
                               + nums[left] + nums[right];
                    if (sum < target) {
                        left++;
                    } else if (sum > target) {
                        right--;
                    } else {
                        answer.add(Arrays.asList(
                            nums[i], nums[j], nums[left], nums[right]));
                        int leftValue = nums[left];
                        int rightValue = nums[right];
                        while (left < right && nums[left] == leftValue) left++;
                        while (left < right && nums[right] == rightValue) right--;
                    }
                }
            }
        }
        return answer;
    }

    public static void main(String[] args) {
        Scanner scanner = new Scanner(System.in);
        if (!scanner.hasNextInt()) return;
        int n = scanner.nextInt();
        long target = scanner.nextLong();
        int[] nums = new int[n];
        for (int i = 0; i < n; i++) nums[i] = scanner.nextInt();
        List<List<Integer>> answer = fourSum(nums, target);
        StringBuilder output = new StringBuilder();
        for (List<Integer> row : answer) {
            output.append(row.get(0)).append(' ')
                  .append(row.get(1)).append(' ')
                  .append(row.get(2)).append(' ')
                  .append(row.get(3)).append('\n');
        }
        System.out.print(answer.isEmpty() ? "[]\n" : output.toString());
    }
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
例如输入 6 0 1 0 -1 0 -2 2,应得到 [-2,-1,1,2]、[-2,0,0,2]、[-1,0,0,1] 三个组合。输出顺序不是算法正确性的核心,是否满足格式要求则要按评测器约定处理。
# 十五、本地有 AI 吗,让 AI 实现并要求一次通过,怎么组织这次任务?
“本地有 AI”先确认是能在本机调用的 Coding 工具,还是必须离线运行的本地模型,不能因为客户端装在电脑里,就说模型在本地推理。工具可用后,我会先确认语言、数据范围、输入输出和允许的操作目录。
给 AI 的任务可以写得很具体:“在当前空目录创建 Java 17 的 Main.java,实现四数之和。采用上面确认的输入输出约定,排序加双指针,结果去重,求和使用 long。再生成 Python 3 验证脚本,真实编译运行,并用暴力枚举对照小规模输入。只修改这两个文件,输出执行命令和结果。”
模型生成文件后,执行器才能落盘和运行命令。我要看实际编译退出码、程序输出和测试结果,而不是接受一句“代码应该可以 AC”。如果要求的是首次生成就通过,还要保留首次代码和第一次执行记录,不能修改后把它包装成一次通过。
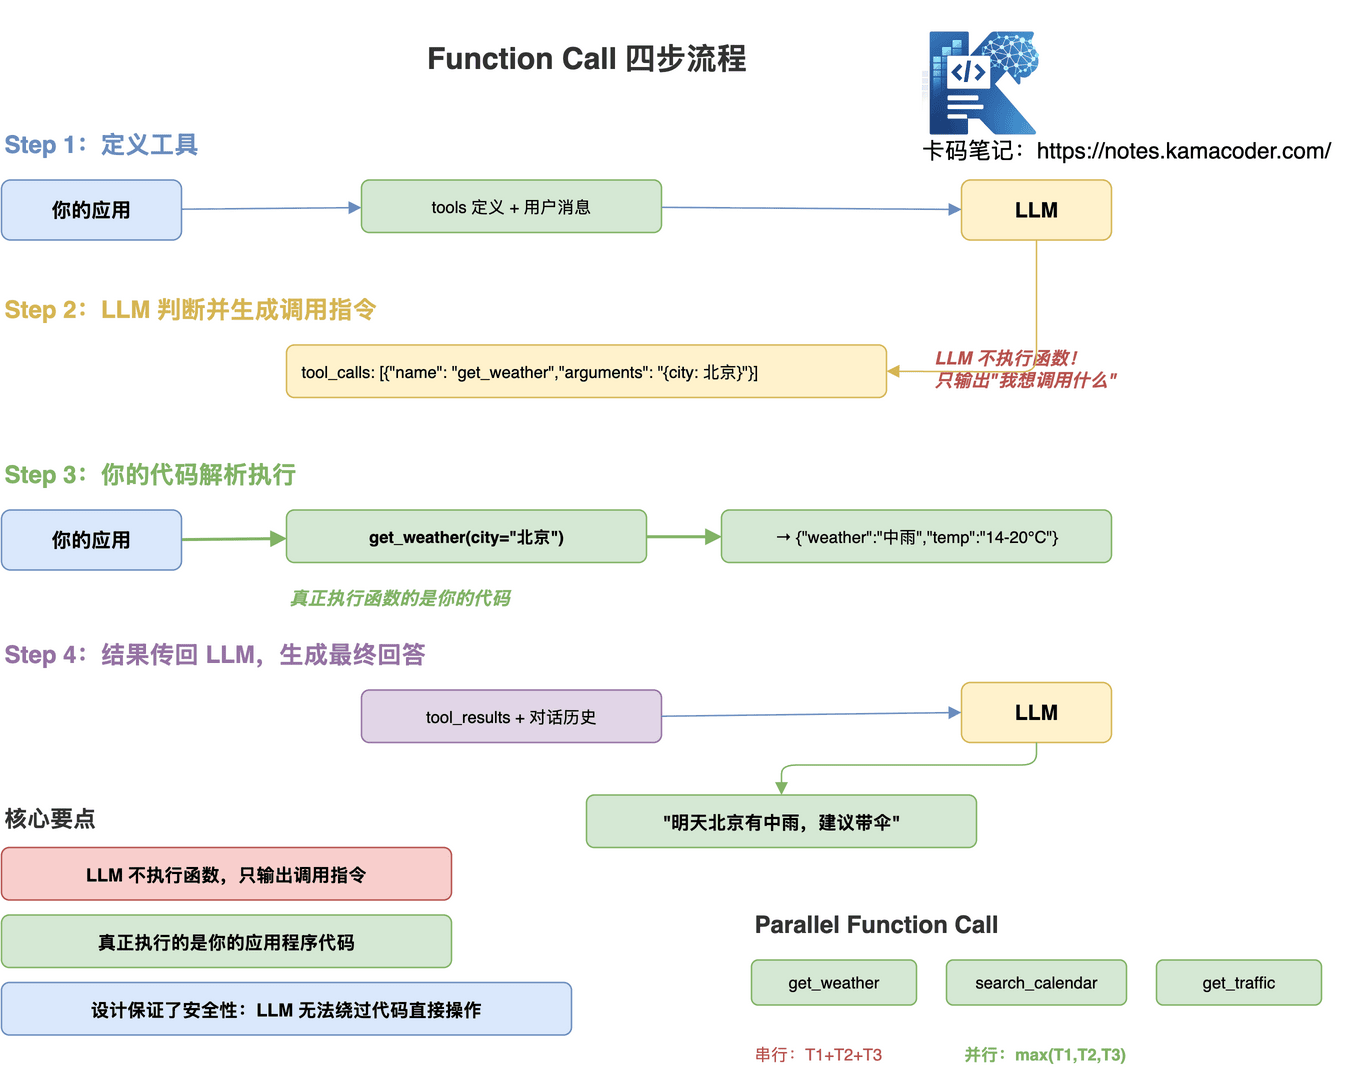
这张图对应现场的执行过程:模型请求创建文件或运行命令,工具实际执行,再把结果反馈。“要求一次过”是验收目标,不是模型给出的保证。
# 十六、让 AI 生成执行脚本,直接给 AC 代码或证明能跑通,怎么验证?
我会把代码和下面的脚本分别保存为 Main.java、verify.py,在同一目录执行 python3 verify.py。环境需要能直接运行 javac 和 java;脚本编译到临时目录,编译失败或任一用例不符都会退出报错。
验证不能只跑题目示例。我会覆盖少于四个数、全零、重复值、无解、负数,以及四个十亿求和这种溢出风险。再对小数组用四下标暴力枚举做独立对照,避免测试脚本重复写一份相同的双指针逻辑。
import itertools
import random
import subprocess
import tempfile
from pathlib import Path


def oracle(nums, target):
    return {
        tuple(sorted(values))
        for values in itertools.combinations(nums, 4)
        if sum(values) == target
    }


def check(classes, nums, target):
    data = f"{len(nums)} {target}\n" + " ".join(map(str, nums)) + "\n"
    result = subprocess.run(
        ["java", "-cp", classes, "Main"], input=data,
        text=True, capture_output=True, check=True, timeout=5,
    )
    text = result.stdout.strip()
    rows = [] if text == "[]" else [
        tuple(map(int, line.split())) for line in text.splitlines()
    ]
    assert text, "程序没有输出"
    assert all(len(row) == 4 for row in rows), rows
    assert all(tuple(sorted(row)) == row for row in rows), rows
    assert len(rows) == len(set(rows)), f"重复四元组: {rows}"
    assert set(rows) == oracle(nums, target), (nums, target, rows)


cases = [
    ([], 0), ([1, 2, 3], 6), ([0, 0, 0, 0, 0], 0),
    ([1, 0, -1, 0, -2, 2], 0), ([2, 2, 2, 2, 2], 8),
    ([1, 2, 3, 4], 100), ([-5, -4, -3, -2, -1], -10),
    ([10**9] * 4, 4 * 10**9),
    ([10**9] * 4, -294967296),
    ([-2147483648, -2147483648, 2147483647, 2147483647], -2),
]
rng = random.Random(42)
for _ in range(60):
    nums = [rng.randint(-6, 6) for _ in range(rng.randint(0, 10))]
    cases.append((nums, rng.randint(-15, 15)))

with tempfile.TemporaryDirectory() as classes:
    source = Path(__file__).resolve().with_name("Main.java")
    subprocess.run(
        ["javac", "--release", "17", "-d", classes, str(source)],
        check=True, timeout=30,
    )
    for nums, target in cases:
        check(classes, nums, target)
print(f"PASS: {len(cases)} cases")
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
本文补充的 Java 代码已在 Java 17 环境编译,并通过上述脚本的 70 组用例,包括 10 组固定边界和 60 组随机对照。这是整理文章时的本地验证结果,原记录没有提供现场提交结果。
这些检查提供的是对本地参考实现的验证证据,不是数学上的完整证明,更不能代替现场平台的提交结果。真正说“AC”,要有相应评测器的通过记录;如果没有平台,就准确说“已编译,已通过哪些测试”。
现场还要能解释为什么双指针移动不会漏解、为什么各层需要去重,以及为什么 long sum = nums[i] + ... 仍可能先溢出。AI 可以生成代码,面试官仍然可以随时指着一行让你解释。
# 十八、校园招聘项目接入飞书、微信、钉钉后,能在飞书上聊吗?是基于 Spring Boot、Spring AI 构建的吗?
先区分“往群里发通知”和“支持双向对话”。只配置出站 Webhook,能推送岗位消息,不代表能接收用户的问题。要在飞书里聊,需要相应的消息事件接入、会话处理,以及把结果发回原会话的能力。
以校园招聘项目为例,用户在机器人会话里问“有哪些符合条件的岗位”,平台适配层接收事件并校验身份,转成统一请求,交给后端查询或模型流程处理,再通过平台发送接口回复。会话至少按平台、租户或组织、用户与聊天范围隔离;重复投递的事件要去重,较长任务也要处理超时和回复状态。
Spring Boot 可以承担接口、鉴权、业务服务和异步处理;Spring AI 可以用于模型调用、工具接入等集成。平台事件订阅、用户权限、消息去重和发送回复仍然需要应用自己的逻辑,不能因为引入 Spring AI 就说三端聊天已经接好了。具体 API 用法还要按项目实际版本说明。
微信也要讲清是哪个产品形态,例如企业微信或公众号,不能用“微信”两个字代替所有接入方式。飞书、微信、钉钉可以共用业务能力,但事件协议、权限和回复通道各自适配,不能把某个平台的用户 ID 直接当全平台身份。
如果面经中的项目确实基于 Spring Boot、Spring AI,就按实际依赖和调用链解释;如果不是,就说明自己的实现。面试官提出框架名,是在确认技术栈,不等于已经证实候选人用了它。
# 总结
前半场考项目归属和执行细节:你负责的路由解决了什么问题,分类之后任务怎么完成。后半场把同一个问题搬到了现场:让 AI 写代码之后,你能不能把产物变成可检查的结果。
大家可以拿四数之和练一次完整交付:先写清输入输出,再让 AI 生成代码和脚本,保留首次执行记录,然后自己解释去重、指针移动和溢出。能讲清每个失败样本为什么失败,比记住一句“我平时很会用 AI”更有说服力。
评论
验证登录状态...