# 美团 Agent 开发日常实习面经:一个 RAG 项目,被追问了三层
面经时间:2026年10月21日
前面那篇阿里淘天 Agent 研发岗面经,重点是代码 Agent 从读取仓库到修改、验证的执行链路。
这次看美团 Agent 开发日常实习,面试官抓住智能运维项目,沿着“为什么检索、怎么检索、证据是否可信”继续往下钻。
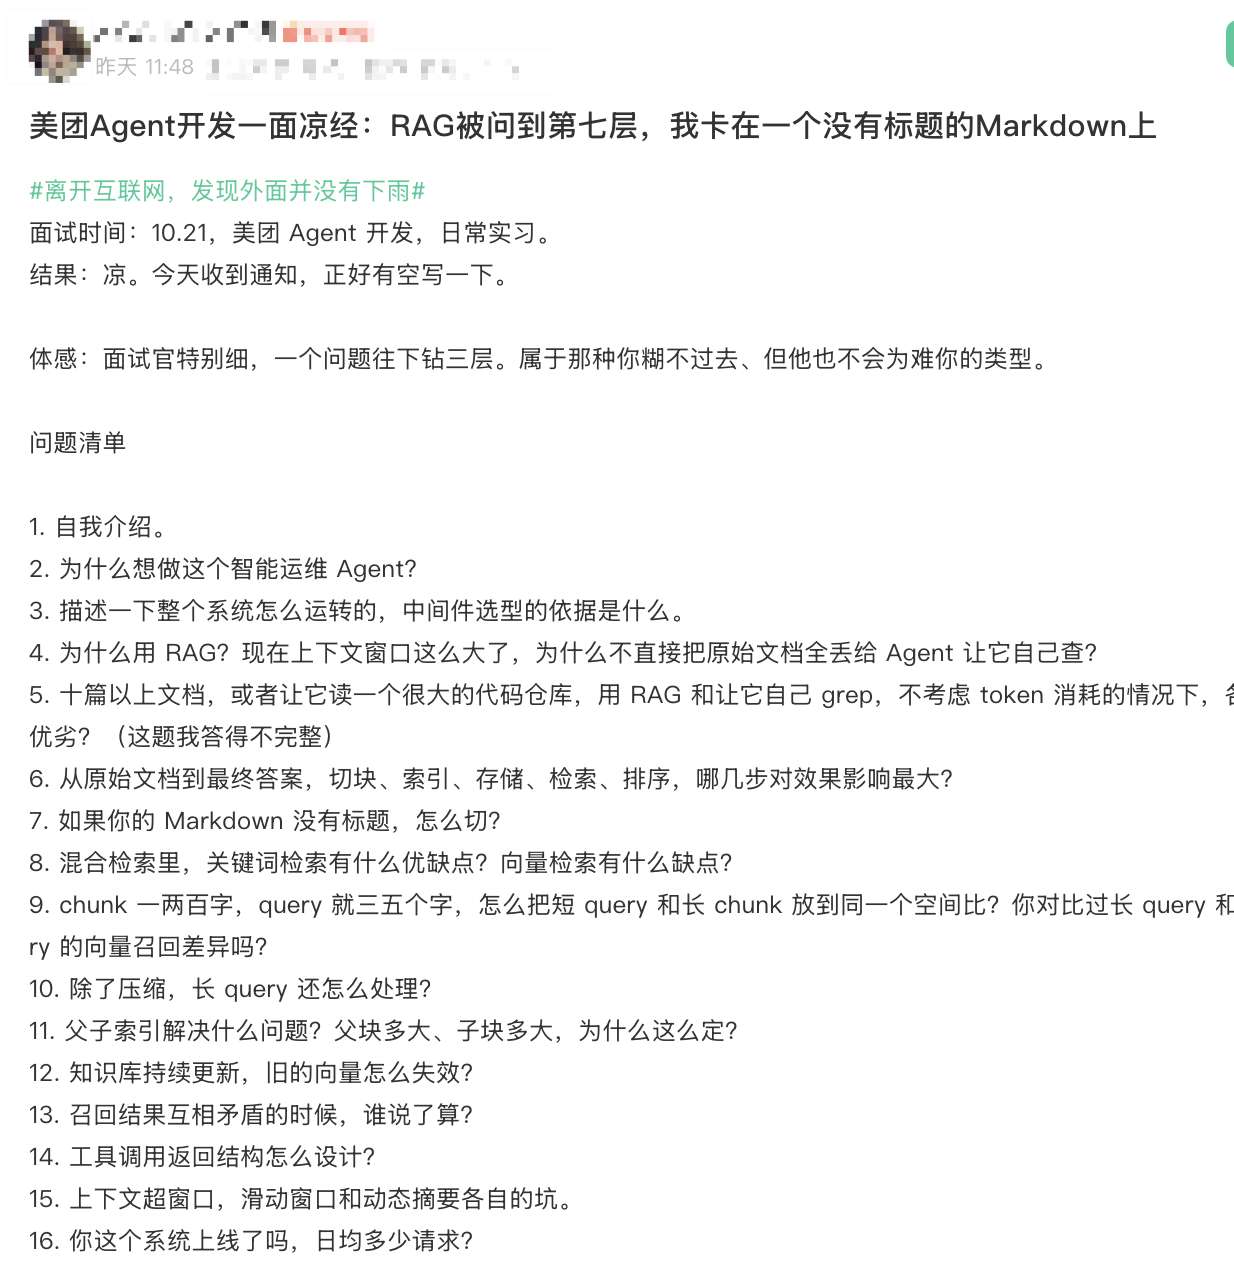
本次美团的面试体感:面试官特别细,一个问题往下追三层,糊不过去,但也不会刻意为难人。
第 5 题关于 RAG 和 grep 的比较,候选人明确说自己答得不完整。
这场的难点在于,你说“用了混合检索”,他会接着问:短 Query 怎么和长 Chunk 比?文档更新了旧向量怎么办?两段答案互相矛盾,听谁的?
下面保留原题顺序,以下为补充的参考回答,第一人称为口述示例,不是候选人的真实作答记录。 全文统一以一个学习验证阶段的智能运维 Agent 为例:查询故障手册、调用只读监控和日志工具、输出带证据的排查建议。
本次面经问题:
- 一、自我介绍。
- 二、为什么想做这个智能运维 Agent?
- 三、整个系统怎么运转,中间件选型依据是什么?
- 四、为什么用 RAG?上下文窗口这么大,为什么不直接把原始文档全丢给 Agent?
- 五、十篇以上文档或大代码仓库,不考虑 Token 消耗,RAG 和 Agent 自己 grep 各有什么优劣?
- 六、从原始文档到答案,切块、索引、存储、检索、排序,哪几步对效果影响最大?
- 七、Markdown 没有标题,怎么切?
- 八、混合检索里,关键词检索有什么优缺点?向量检索有什么缺点?
- 九、一两百字的 Chunk 和三五字的 Query 怎么比较?对比过长 Query 和三字 Query 的向量召回吗?
- 十、除了压缩,长 Query 还怎么处理?
- 十一、父子索引解决什么问题?父块、子块多大,为什么这么定?
- 十二、知识库持续更新,旧向量怎么失效?
- 十三、召回结果互相矛盾时,谁说了算?
- 十四、工具调用返回结构怎么设计?
- 十五、上下文超窗口,滑动窗口和动态摘要各有什么坑?
- 十六、系统上线了吗,日均多少请求?
# 二、为什么想做这个智能运维 Agent?
我想解决的是排障过程里的信息分散问题。故障手册说明一般处理步骤,监控告诉我现在发生了什么,日志补充具体错误,单独问一个文档问答系统,往往还需要人手工把这些信息接起来。
比如“订单服务刚发布后错误率上升”,我需要先确认服务、环境、时间和发布版本,再查指标与错误日志,检索适用的故障手册。发现连接超时后,还可能继续看依赖服务状态。Agent 的价值就在于根据上一轮证据选择下一步检查。
固定流程能完成的部分,我会保留为确定性代码。 参数检查、权限、超时、停止条件不交给模型自由决定。如果任务只是按服务名返回一篇固定手册,用普通搜索或规则流程就够了。
# 三、整个系统怎么运转,中间件选型依据是什么?
我会分离线入库和在线排障两条链路讲。离线把 Markdown 手册解析、清洗、切块,记录文档版本和适用范围,再生成关键词索引与向量索引。在线接收问题,确认服务、环境和时间范围,检索手册或查询运行数据,最后生成带引用的建议。
在这个最小示例里,可以用 Python 实现编排和工具执行,用 PostgreSQL 保存文档版本、父子块关系及任务状态,用 Elasticsearch 承载 BM25 和向量候选检索。选它的理由是需要同一份业务文档的关键词与语义两路召回、元数据过滤,而不是“做 RAG 就必须用 ES”。具体能力还要核对选用版本。
两路候选先合并去重,再按需要重排、扩展父块。每条证据保留来源、版本和位置;模型请求查日志时,由执行器校验查询范围、执行并返回结构化结果。轮数或时间达到上限,就返回当前证据和未完成检查。
原型阶段不必为了技术栈丰富就增加 Redis、消息队列和独立向量库。文档入库耗时且需要重试时,再考虑独立后台任务;多实例需要共享缓存时,再引入相应组件。选型要对应查询能力、更新方式和运维代价,也要交代为什么当前规模值得用它。
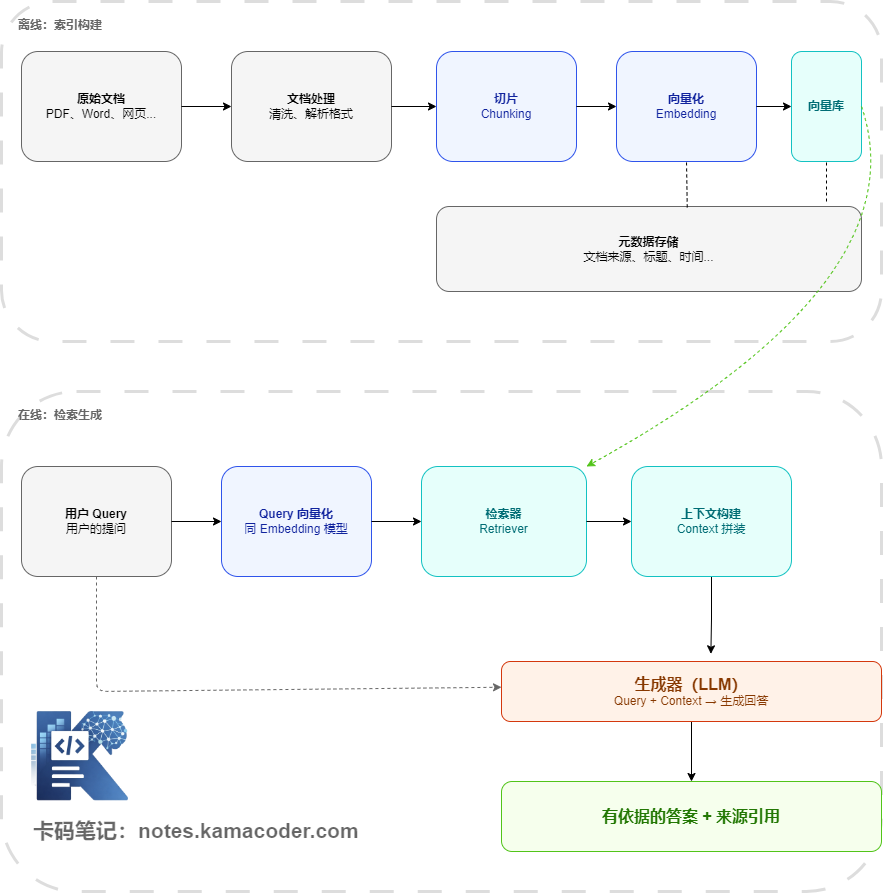
图中是系统里的知识检索部分:离线负责构建知识,在线负责检索和生成。监控、日志等只读工具由 Agent 按排障需要另外调用,这张图展示的是 RAG 子链路。
# 四、为什么用 RAG?上下文窗口这么大,为什么不直接把原始文档全丢给 Agent?
如果文档少、总长度适合、问题需要跨全文理解,我会把直接全文阅读作为基线。上下文窗口变大以后,这确实是一种可行方案,不能只回答“省 Token”。
我在运维场景考虑 RAG,是因为知识库持续变化,而且每次问题通常只对应某个服务、环境和软件版本。检索能先缩小适用范围,返回可追溯证据,减少把旧手册和无关信息一起交给模型的情况。
能放进窗口,不等于模型能稳定利用其中每一处细节。 大量相似步骤、冲突版本和无关材料会增加判断难度。不过 RAG 也可能漏召回、切断条件,不能只讲它的好处。
我会用同一组问题对比全文阅读和 RAG,检查必要证据是否齐全、答案是否忠于来源、冲突是否识别,以及响应时间。若全文阅读表现更好、维护也更简单,我就没有理由坚持 RAG。
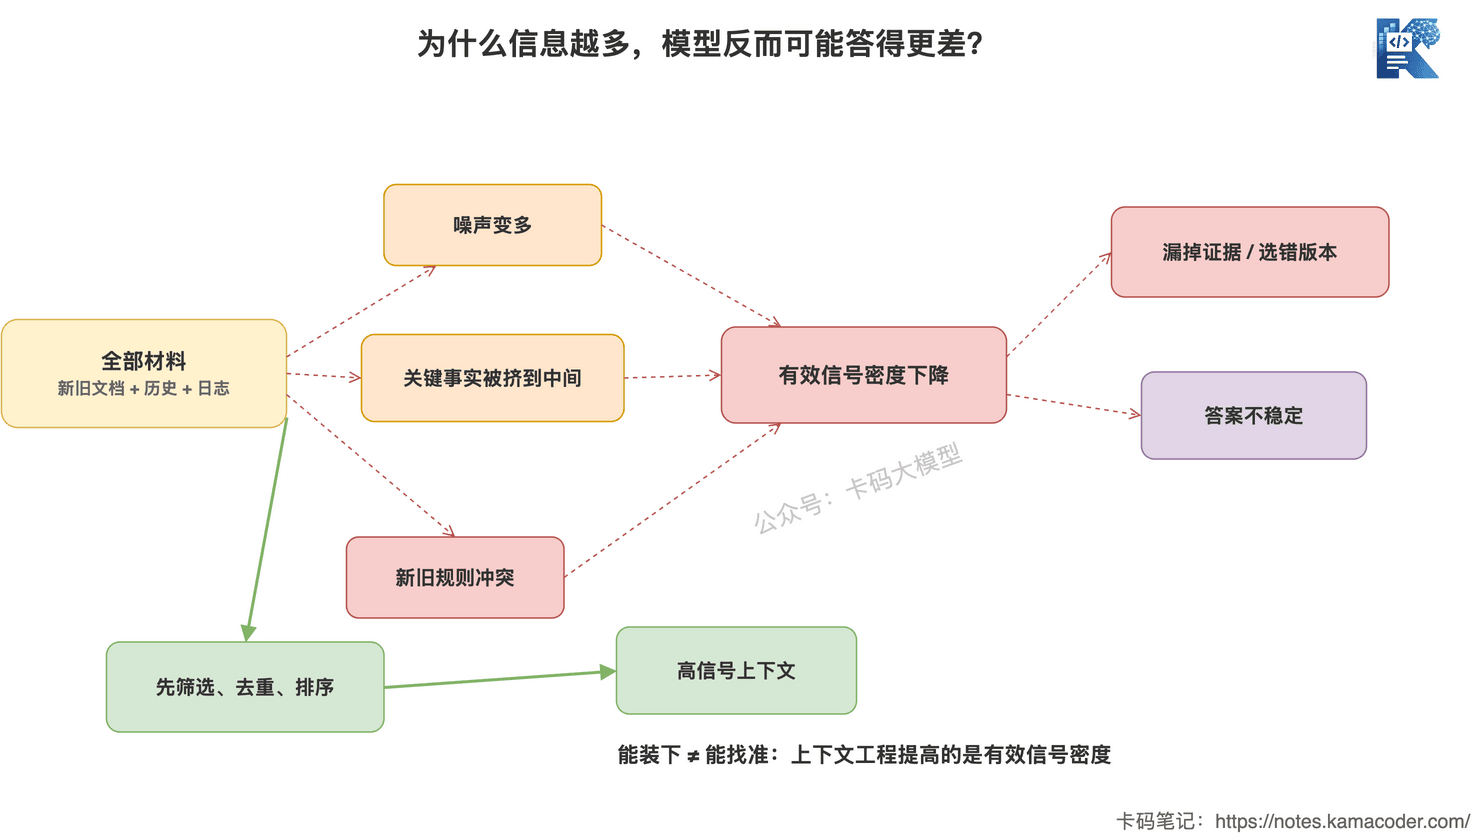
图里对比的是材料直接堆入与筛选后进入上下文的差异。它解释了为什么“放得下”还不够;具体项目仍需用全文阅读与检索两组结果验证。
# 五、十篇以上文档或大代码仓库,不考虑 Token 消耗,RAG 和 Agent 自己 grep 各有什么优劣?
我会先说明:这里把 RAG 理解成预先建索引、检索相关片段的方案;grep 是 Agent 对当前文件进行词法搜索,再逐步阅读的方式。广义上,grep 找到证据再用于生成,也是在做检索增强,两者不是完全互斥的类别。
十篇不是分界线,十篇短手册和十篇几百页的文档差别很大。即使不考虑 Token 消耗,覆盖率、更新一致性、阅读完整性和多轮定位的时间仍然要比较。 如果总量小且需要全文综合,直接阅读也应加入比较。
| 比较点 | 预建索引的 RAG | grep 后逐步阅读 |
|---|---|---|
| 语义发现 | 不知道原文措辞时,也可能找到相近表达 | 依赖搜索词,可以借助别名和多轮搜索补足 |
| 精确定位 | 普通向量召回可能混淆相似符号,需关键词等能力补充 | 适合错误码、配置键、函数名和路径 |
| 更新一致性 | 依赖增量更新和版本过滤 | 搜索当前工作区文件,仍需确认分支、未提交修改和忽略范围 |
| 证据完整性 | 分块容易丢前提、跨文件关系,需回源和扩展 | 能继续读完整方法与调用方,但搜索命中也可能只是局部 |
| 主要失败方式 | 没召回、索引过期、候选被噪声挤掉 | 搜索词没猜对、路径范围不全、输出截断后漏读 |
以大仓库为例,知道错误是 PoolTimeout,我会先精确搜索,再读连接池初始化、调用位置和测试。问题是“哪些模块负责依赖故障隔离”时,文件里未必出现这句话,语义索引能提供入口,然后再读当前源码确认。
grep 本身不理解调用关系。重命名、接口实现、动态分派这些问题,必要时还要结合符号索引、语言服务和运行验证。反过来,RAG 也不必只用向量,可以混合关键词与结构信息。
我倾向于“索引发现入口,实时搜索与阅读核实证据”。评测时固定同一份文档或仓库版本,用已知符号定位、未知措辞发现、跨文件追踪和最近修改四类任务比较,记录必要证据覆盖率、定位轮数和结果正确性。更完整的背景可以看代码 Agent 为什么需要 grep 和 RAG。
# 六、从原始文档到答案,切块、索引、存储、检索、排序,哪几步对效果影响最大?
我不会脱离错误样本给一个固定排名。对这个示例,我会优先检查原文解析与切块是否保留条件、候选召回有没有找到必要证据,再看重排和最终生成。前面丢掉的证据,后面通常补不回来。
比如手册写“仅在测试环境执行清理”,切块却把限制留在上一块,模型看到清理步骤后就可能给出错误建议。关键词和向量都没召回目标段落时,重排模型再强也只能在错误候选里挑。
索引和存储也不是只影响性能。索引漏了配置键、近似向量搜索漏掉目标、存储的版本或权限元数据错误,都会影响最终结果。反过来,候选里有正确证据却被排在后面,就应该检查排序;证据已正确送入模型而答案仍编造,则要检查生成与引用约束。
我会用带证据标注的排障问题逐段记录:原文能否正确还原,候选集合是否覆盖必要证据,重排后是否保留,答案引用是否支持结论。一次只改一类因素,避免同时换模型、改切块、加大 Top-K,最后不知道哪里起了作用。这个思路可以对照RAG 落地最难的地方在哪。
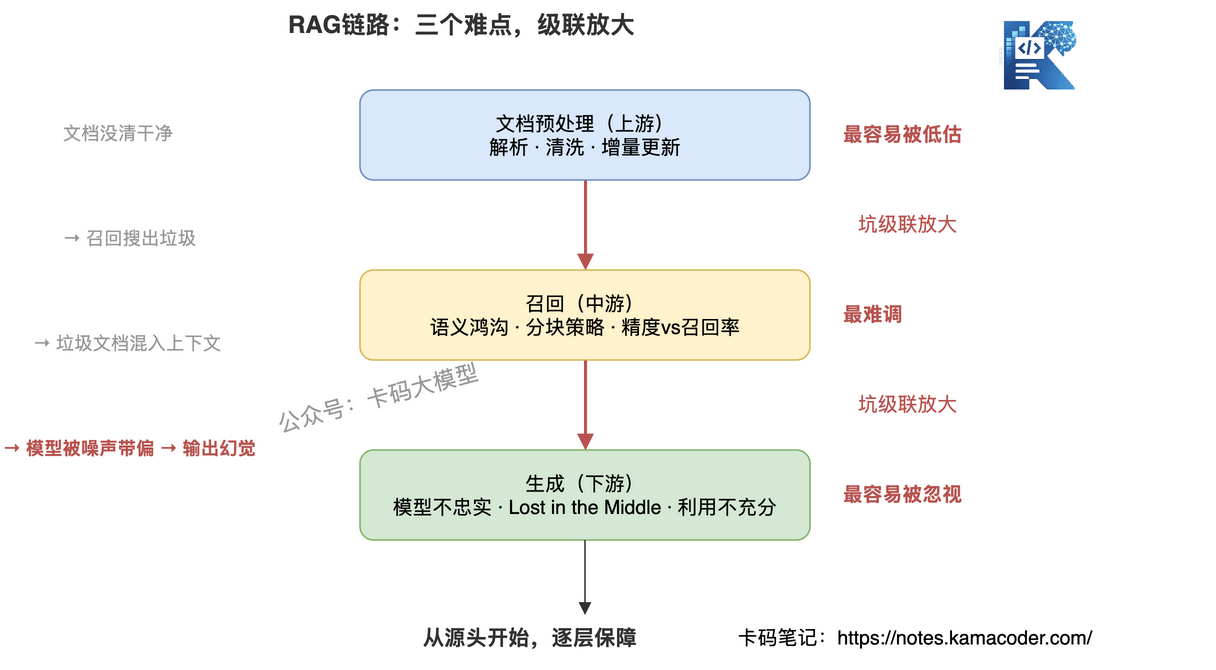
沿着这张图排查,可以先找错误在哪一段出现,再看它如何影响下游。比如原文条件被切丢,应先修复文档处理,而不是只调整重排分数。
# 七、Markdown 没有标题,怎么切?
没有标题,我会先按 Markdown 结构解析,识别自然段、列表、代码块和表格,而不是直接按固定字数截断。
短文可以整体保留;长文优先在段落或句子边界切,并设置 Token 上限。运维手册里的“现象、适用条件、检查步骤、预期结果”尽量保留在同一个语义单元里。超长代码块和表格需要专门拆分,重复必要的代码上下文或表头,保留原文位置。
比如某段先说“出现连接耗尽时,先检查连接是否归还”,下一段给检查命令,我会尽量把它们放在一起。确实跨块时,可以保留适度重叠或相邻块关系,命中以后再扩展。
语义切分可以作为候选方案,但它也有成本,不能保证每个主题边界都判断准确。补充主题标签时,应把生成标签与原始正文区分,并保留路径和段落范围。验证重点是条件和动作有没有被拆散,而不是块长度是否整齐。
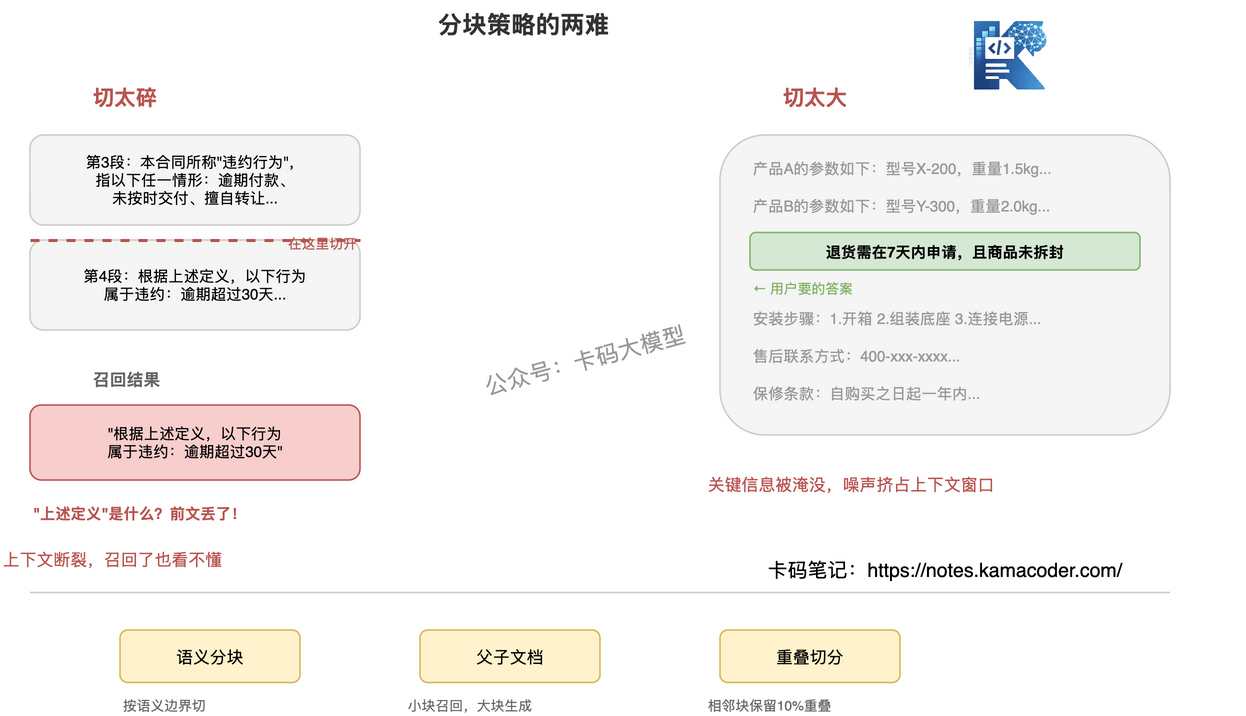
没有标题也要处理图里的这组矛盾:块太小,条件与动作可能分离;块太大,相关内容又容易被无关段落淹没。因此要结合自然段边界和命中后的上下文扩展。
# 八、混合检索里,关键词检索有什么优缺点?向量检索有什么缺点?
关键词检索的优势是精确、可解释。运维里有很多错误码、接口名、配置键,用户输入 max_connections,我希望包含这个配置的手册能被稳定找到。不过 BM25 是相关性排序,不等于字符串精确匹配;标识符有精确匹配要求时,要配合合适的分词、字段和查询方式。
它的短板是表达不一致。用户说“数据库连不上”,手册写“连接池耗尽”,如果没有同义词、改写或其他补充,可能漏掉。中文分词、缩写和拼写错误也会影响结果。
向量检索能补语义表达差异,但它也可能把“如何开启”和“如何关闭”判得很相近,对错误码、数字、版本以及否定条件不够敏感。多主题长块还可能稀释关键内容;近似检索和过期索引也会带来额外漏召回。
我的方案是两路分别取候选,做权限与版本约束,合并去重后重排。融合可以先用基于名次的 RRF,避免直接把量纲不同的分数相加;但它仍需验证,精确错误码命中也不能被重复的泛化片段挤掉。
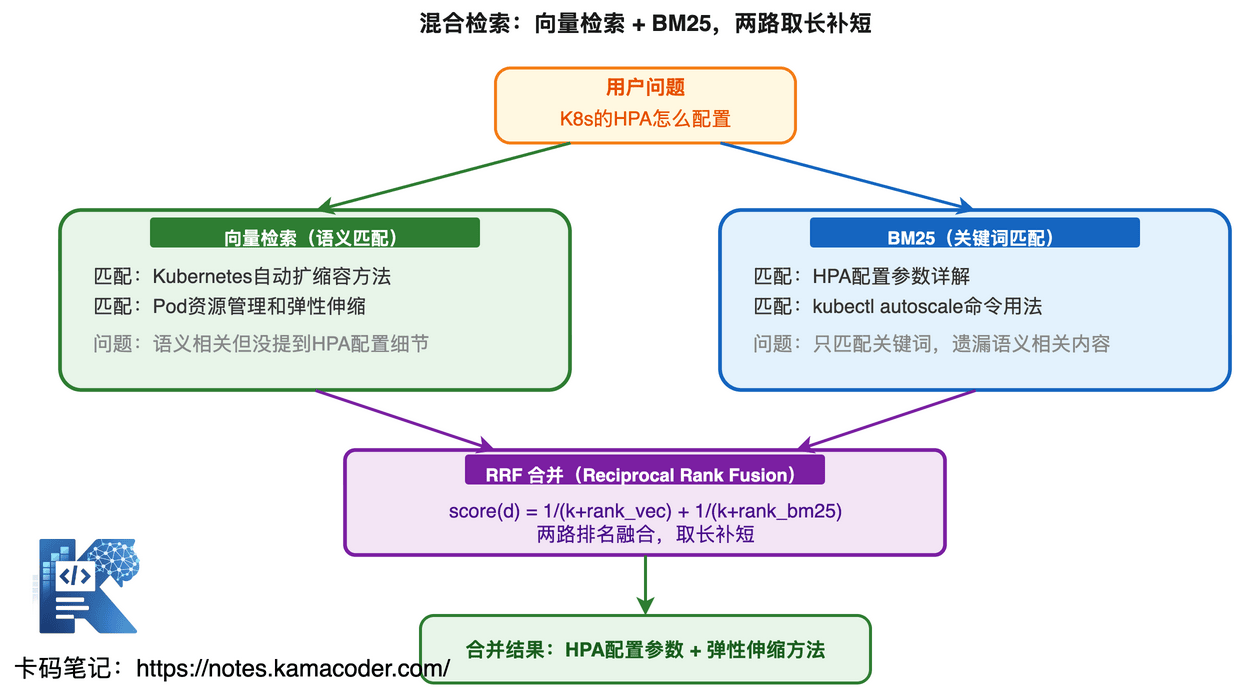
这张图说明两路召回如何汇合。具体优缺点和排序过程,可以结合RAG 面试题汇总一起看。
# 九、一两百字的 Chunk 和三五字的 Query 怎么比较?对比过长 Query 和三字 Query 的向量召回吗?
不同长度文本可以经检索 Embedding 模型映射成兼容的固定维度向量,再计算相似度,输入字数不需要一样。查询端和文档端怎么编码,要遵循模型约定;有的模型需要不同指令或编码入口,不能随意混用不同模型的向量。
但“维度相同,能算余弦相似度”只解释了怎么计算,没解释为什么准确。检索模型需要学到短问题与长段落的相关性;短 Query 信息不足、多主题 Chunk 表达分散,都会影响效果,不能靠补字、截成同样长度解决。
比如“连接池”只有主题,无法区分耗尽、泄漏和参数配置;“订单服务发布后连接池耗尽,如何确认连接未归还”提供了更多条件。后者可能更容易命中目标,但长 Query 加入无关聊天或错误假设,也可能更差。
没有实际对比过,就直接说没有完成这项实验。 在这个参考项目里,我会说明目前不能给出长短 Query 的召回差异结论,然后讲清准备怎么验证。
测试要用同一意图的成对问题,固定语料版本、模型和检索配置,标注相关段落,比较短 Query 与完整问句的 Recall@K、MRR,以及最终答案的证据覆盖。再分出错误码、泛主题、含服务上下文等类型,防止平均值掩盖差异。如果只测向量召回,就先固定关闭其他召回分支,再测完整混合链路。
# 十、除了压缩,长 Query 还怎么处理?
我会先判断它为什么长。可能是带了大量日志,也可能混了多个问题,或者里面其实有很关键的环境和时间条件,这几种情况不能统一删短。
例如“订单服务昨天发布后超时,附了几百行日志,还想知道怎么检查连接池、是否能回滚”,可以先抽取服务、环境、版本、时间、错误码,把这些作为过滤条件或检索词。重复堆栈可以去重,但异常链、关键错误和行号要保留,原始日志也要能按引用重新读取。
多个意图可以拆成子查询:一条找超时诊断,一条找连接池排查,一条找发布回滚条件,分别检索再合并证据。不要把“能否回滚”的决策条件混进连接池症状匹配里。缺服务或环境时,再根据对答案的影响决定是否澄清。
还可以保留原 Query,同时做术语归一、指代补全或多种检索表达,避免单次改写丢条件。Query 超过编码模型输入上限时,要按语义拆分后分别检索,不能静默截断末尾的关键限制。
这些方法会增加查询次数,也可能产生意图漂移。我会检查拆解前后的服务、时间、否定条件是否一致,并限制分支数;“扩写后搜得更多”不等于找得更对。
# 十一、父子索引解决什么问题?父块、子块多大,为什么这么定?
父子索引主要缓解“检索需要精确片段,回答需要完整上下文”的矛盾。子块聚焦一个局部,适合召回;命中后通过 parent_id 找回包含它的父块,补上适用条件、前后步骤和例外说明。
比如子块是“检查未释放连接的命令”,父块是这一节完整的连接池耗尽排查流程。多个子块命中同一父块时先去重;父块太大则只扩展必要范围,不能一命中就把整篇手册都塞回来。
作为待验证的起始参数,这个示例可以试子块约 150~300 Token、父块约 600~1200 Token,优先服从自然段和流程边界,而不是为了凑长度硬切。前面题目的“一两百字”是描述文本长度,落地时还要按实际模型的分词器计数,字数和 Token 数不能直接等同。
这样定的假设是:子块容纳单个症状或检查动作,父块能放下它的前提和后续分支。是否合适,要用召回覆盖率、父块里的无关内容比例、条件完整性和最终回答正确性验证,不能把这个范围背成通用标准。
父子关系还要绑定相同文档版本。否则新版子块指到旧版父块,扩展上下文反而会把已经废弃的操作带回来。
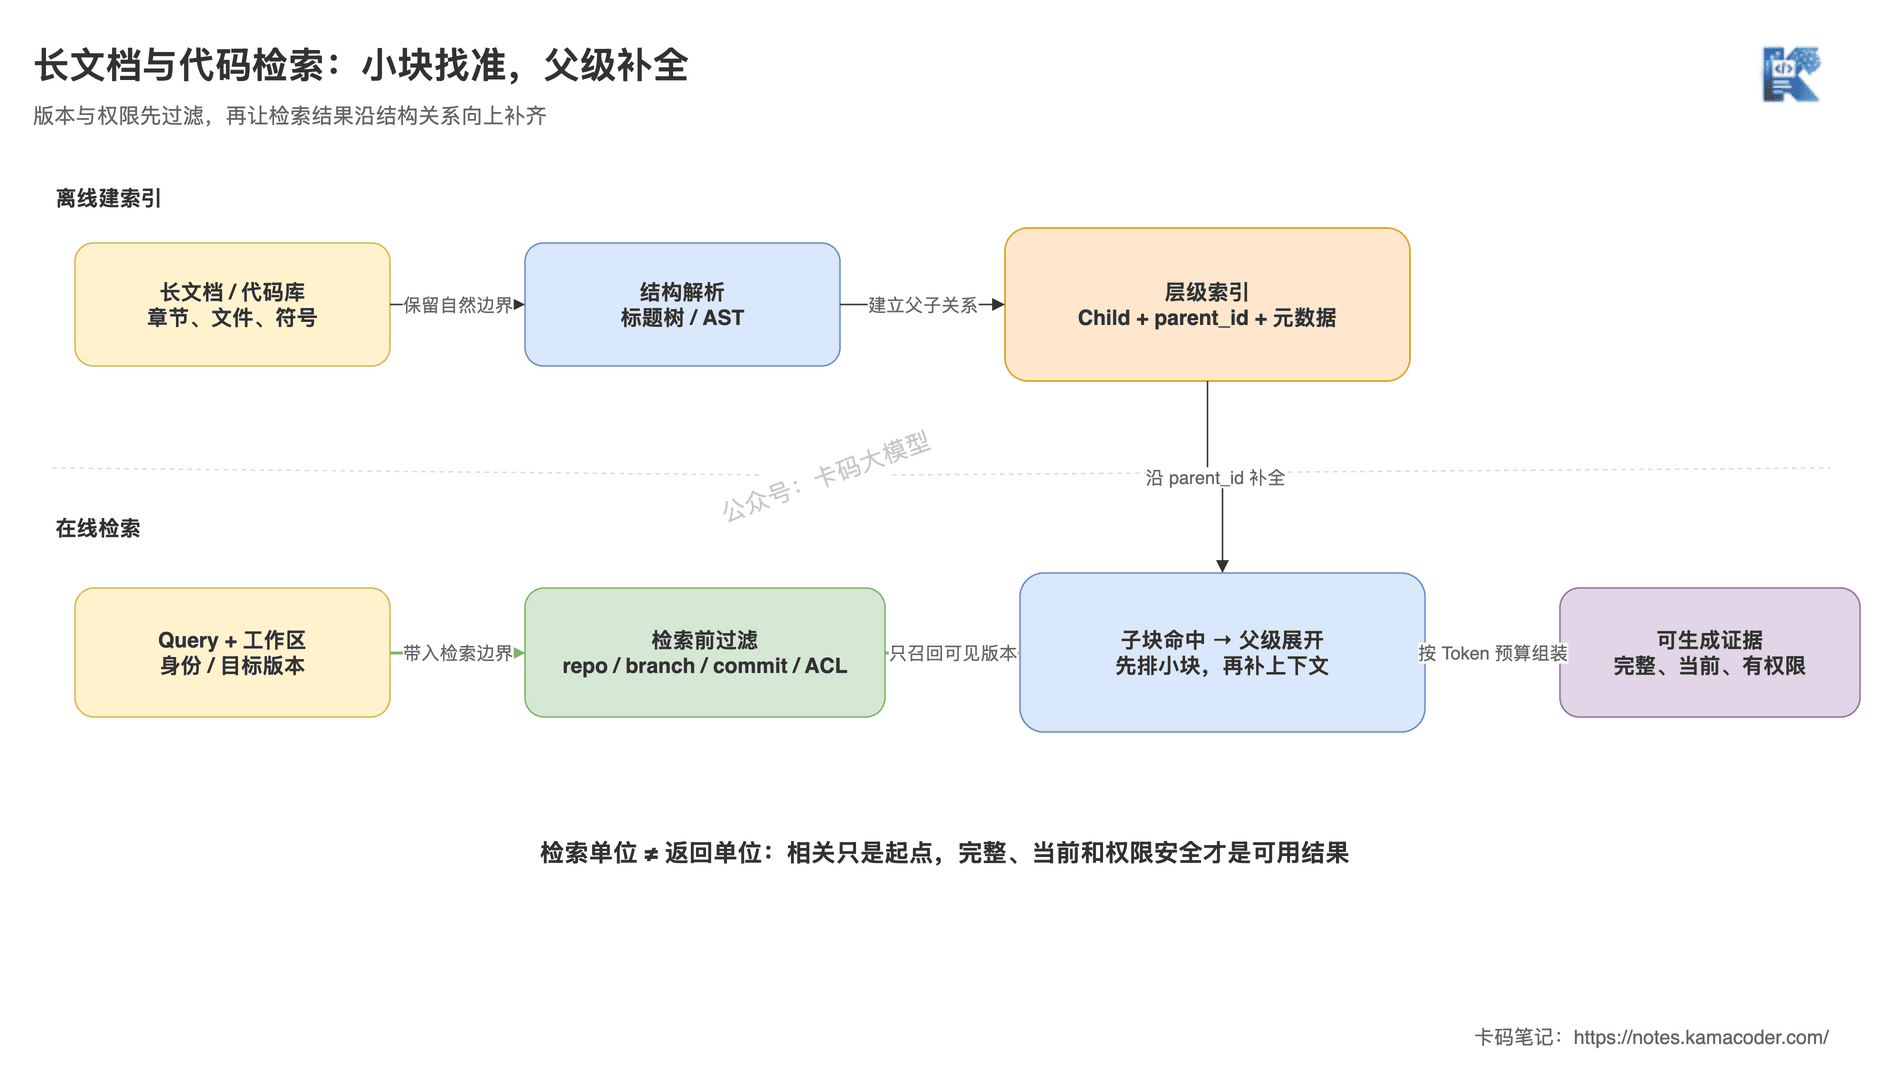
图中把文档章节和代码结构分别组织成层级,再从子节点命中扩展到父级证据。本题的运维手册对应文档这一支;版本与权限过滤也要贯穿检索过程。
# 十二、知识库持续更新,旧向量怎么失效?
我会把“查询时不再可见”和“物理删除数据”分开。文档保存 doc_id、版本、内容哈希和生效状态,块记录文档版本、父子关系及切块策略版本。每个文档版本还要有自己的 Chunk 清单,不能只靠文件名覆盖。
更新时先识别变化,构建新版本的子块、父块、关键词索引和向量索引。确认内容与关联完整后,再让新版本生效。索引粒度允许时可切换版本化索引的读别名;逐文档更新则要设计活动版本过滤,或在服务层校验文档版本并补取候选,避免旧结果占满 Top-K。
只新增向量、不处理旧版本,查询就可能同时拿到新旧两套答案。 ES 与关系库之间也没有天然的跨系统原子切换,我会用入库状态、幂等任务和失败重试协调,查询端只接受已经发布的版本;构建失败时继续使用完整旧版本。
文档删除或权限收回,可以先设置墓碑或禁用状态,让读取层及时拦截,再异步清理索引与正文。缓存也要包含知识库版本、权限范围等条件,并同步失效,不能数据库删了,缓存还继续返回。
换 Embedding 模型时,即使向量维度相同,也不能默认新旧向量空间兼容。需要重建对应索引,并让查询编码与文档编码成套切换。验证时除了“新内容能搜到”,还要检查旧版本、删除文档和旧父块是否仍能被返回。
# 十三、召回结果互相矛盾时,谁说了算?
我不会让向量分数最高的片段直接决定,也不会简单投票。先确认它们是不是在回答同一条件下的问题:服务、环境、版本、时间和操作目标不同,表面相反的建议可能都成立。
比如一篇说“可以重启恢复”,另一篇说“禁止直接重启”。前者可能适用测试环境,后者是生产环境故障流程。当前问题是生产环境,就应先筛选适用范围,再检查正式发布状态、维护责任人与是否已被替代。
仍有冲突时,依据预先约定的来源权威和文档治理规则处理。受控发布的操作手册通常比个人笔记更适合作为执行依据,但“更新时间更晚”本身不代表更权威,复制旧内容也会产生新时间。
监控查询只能证明当前观测到的状态,不能独自证明某个恢复动作一定有效。若两个有效手册在相同条件下仍矛盾,我会展示各自来源和冲突点,暂缓给出确定操作,交由负责人确认。模型负责解释证据,系统和文档治理规则负责限定哪些证据有资格参与判断。
# 十四、工具调用返回结构怎么设计?
我会把调用标识、执行状态、业务数据、来源范围、分页截断和错误信息分开。工具结果要让模型明确知道“查到了什么”和“这次执行是否完整”,同时让执行器能做超时、重试和审计。
下面是日志查询工具的示意返回格式,不绑定具体厂商 API:
{
  "tool_call_id": "call_017",
  "status": "success",
  "data": {
    "items": [
      {
        "timestamp": "2026-10-21T10:03:00+08:00",
        "message": "PoolTimeout",
        "source_ref": "log://order-service/event-42"
      }
    ]
  },
  "scope": {
    "service": "order-service",
    "environment": "test",
    "from": "2026-10-21T10:00:00+08:00",
    "to": "2026-10-21T10:05:00+08:00"
  },
  "complete": false,
  "next_cursor": "page_2",
  "error": null
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
这里 success 表示这次分页请求执行成功,complete: false 表示结果还没读完,不能据此说“全部日志只有一条”。如果扫描中途超时,应返回明确的部分成功状态、已获得的数据、错误码和可重试信息。
查询成功但没有匹配记录,与权限不足、服务不可达、参数错误必须区分。retryable 可以帮助执行器判断,但真正是否重试,还要结合剩余时间、次数和操作是否幂等。日志里出现的指令性文字属于数据,不能被升级成工具调用指令;敏感字段也应在进入模型前脱敏。
模型提出调用请求,执行器完成校验并执行,工具返回观测结果,最终任务状态再由任务控制逻辑确定。日志工具执行成功,不等于故障已经解决,返回文案不能把这几层混为一谈。
# 十五、上下文超窗口,滑动窗口和动态摘要各有什么坑?
滑动窗口实现简单,保留近期消息、丢弃早期消息,但关键条件不一定出现在最近几轮。用户一开始说“只查测试环境”,几十轮后这句话被滑掉,后面的查询就可能失去范围约束。
它还可能切断工具调用请求和返回结果的对应关系,或丢掉已经验证失败的假设,让模型反复走老路。因此不能机械保留最后若干条消息,应按完整交互单元裁剪,并把仍然有效的任务约束单独保存。
动态摘要能保留更长历史,但压缩是有损的。它可能把“怀疑连接泄漏”写成“已确认连接泄漏”,漏掉否定条件、单位、时间范围;反复摘要还可能让错误累积。摘要不能替代原始日志和证据。
我会分开保存当前目标、权限与环境约束、已确认事实及其引用、待验证假设、已尝试动作和结果。摘要只负责叙述性历史;错误码、版本号、关键命令和证据位置保留精确字段,原始内容放在可重新读取的存储里。权限仍由执行器校验,不能依赖模型是否记住摘要。
进入每轮模型调用前,先计算系统指令、工具定义、任务状态和近期消息的预算,并预留输出空间。工具的大结果优先分页、过滤或按引用读取。验证时可以故意把“仅测试环境”“假设尚未确认”放到早期,再拉长对话,检查压缩后行为和事实状态有没有变化。
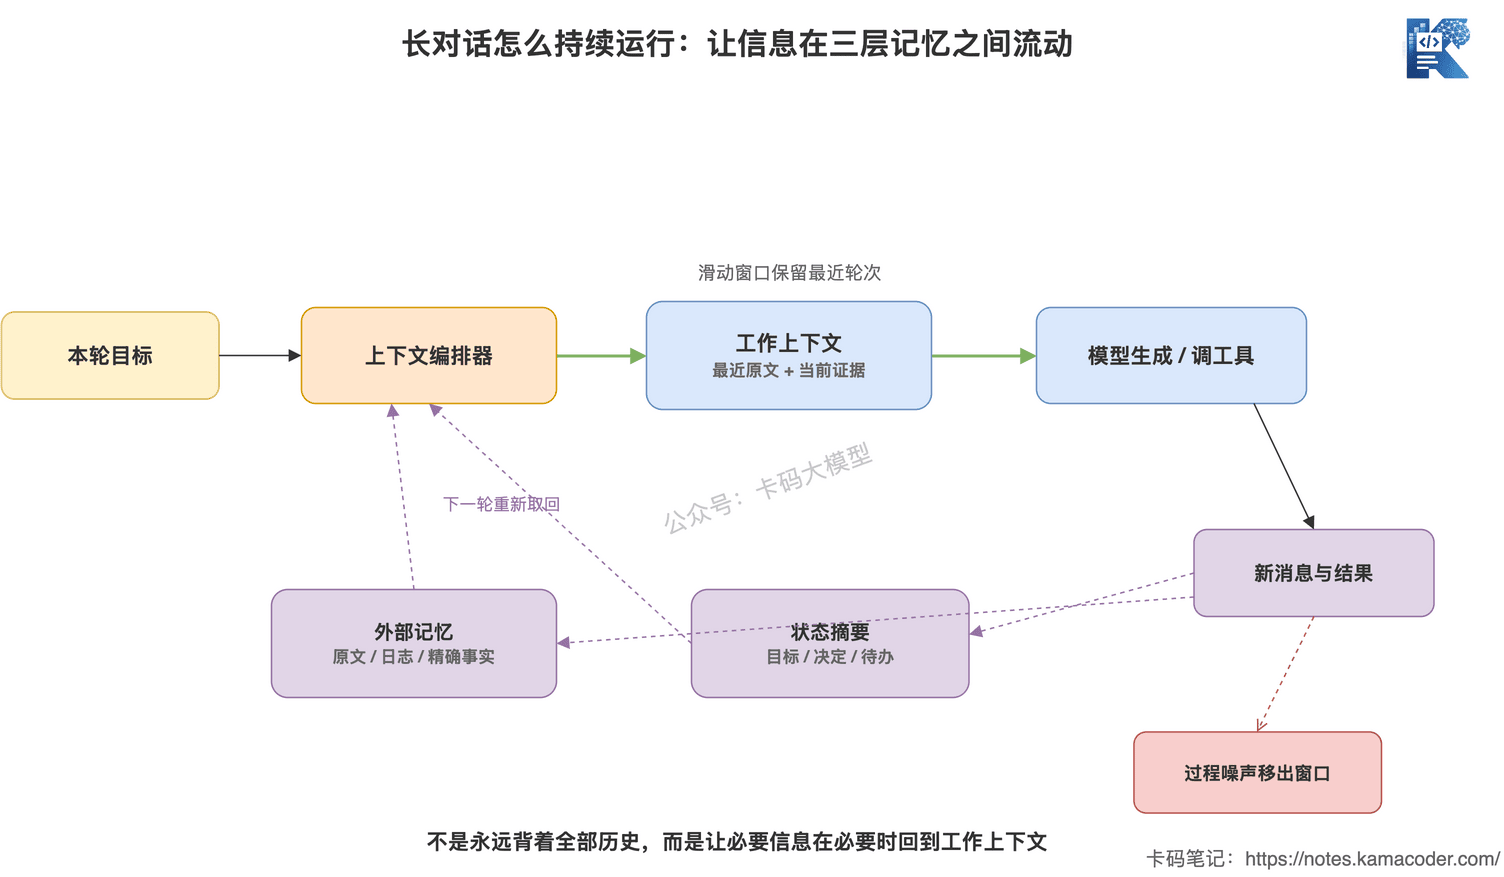
这张图展示工作上下文、状态摘要和外部记忆如何配合。早期约束通过状态保留,完整日志通过引用重新读取,避免每轮都携带全部历史,也避免只剩一份无法核实的摘要。
评论
验证登录状态...