# 多模态大模型:图片和语音是怎么被模型“看懂”的?
上一篇《大模型应用怎么稳定上线?网关、限流、监控、灰度与回滚》讲了文本大模型应用进入生产环境后,怎么控制流量、故障和版本风险。
但今天的模型输入早已不只是文本。上传一张截图,模型能找出报错;对着麦克风说话,模型还能听出语气。
面试官很可能接着问:“图片和语音又不是文字,大语言模型到底是怎么理解它们的?”
很多录友会回答:“图片先做OCR,语音先做ASR,都转成文字再交给大模型。”
这确实是一种工程方案,但不是多模态大模型的全部。OCR能读字,却可能丢掉图片的空间关系;ASR能转录,却可能丢掉语气、音色和环境声。
多模态的关键,不是给聊天接口多加一个图片参数,而是把不同模态都编码成模型可计算、可对齐的表示。
# 简要回答
- 图片先被缩放、切块,再由视觉编码器提取物体、颜色、边缘和空间关系,得到一串视觉特征;
- 语音波形先被采样、分帧,再由音频编码器提取音素、节奏、音色和情绪等特征;
- 连接器把视觉或音频特征映射到语言模型的向量空间,与文本Token放进同一段上下文;
- 训练用成对的图文、语音文本和多模态指令数据对齐它们的含义,模型才能围绕图片或语音生成文本回答。
一句话:编码器负责把图片和语音“翻译”成向量,对齐训练负责让这些向量和文字表达同一个意思。
# 详细回答
# 语言模型为什么不能直接读像素和声波?
文本进入大模型前,会先被Tokenizer切成Token,再查表变成一串向量。Transformer真正处理的从来不是“字”,而是向量序列。
图片是二维像素阵列,语音是随时间变化的波形。如果把原始像素或每个采样点直接交给语言模型,序列会长得离谱,而且数值和文字向量完全不在同一种分布里。
所以模型前面需要一个专用的模态编码器:
图片 / 语音
→ 切块 / 分帧
→ 视觉 / 音频编码器
→ 连接器(Projector / Adapter)
→ 语言模型可处理的向量序列
→ 文本、语音或其他形式的输出
2
3
4
5
6
工程上经常把这些向量叫作“视觉Token”或“音频Token”。严格来说,它们可能是连续向量,也可能是离散编码,不一定像文本Token一样对应某个词片段。
# 一张图片是怎么变成视觉Token的?
以常见的Vision Transformer思路为例,模型会把图片切成许多固定大小的Patch。每个Patch展平并投影成一个向量,再加上位置信息,告诉模型这个小块在图片的哪里。
如果图片高宽是H × W,Patch边长是P,忽略裁剪和特殊Token时,小块数量可以粗略理解为:
视觉Token数 ≈ (H / P) × (W / P)
接着,视觉编码器在这些小块之间做Attention,不再只看某个像素是红是蓝,而是逐层形成边缘、纹理、物体、位置和场景关系。
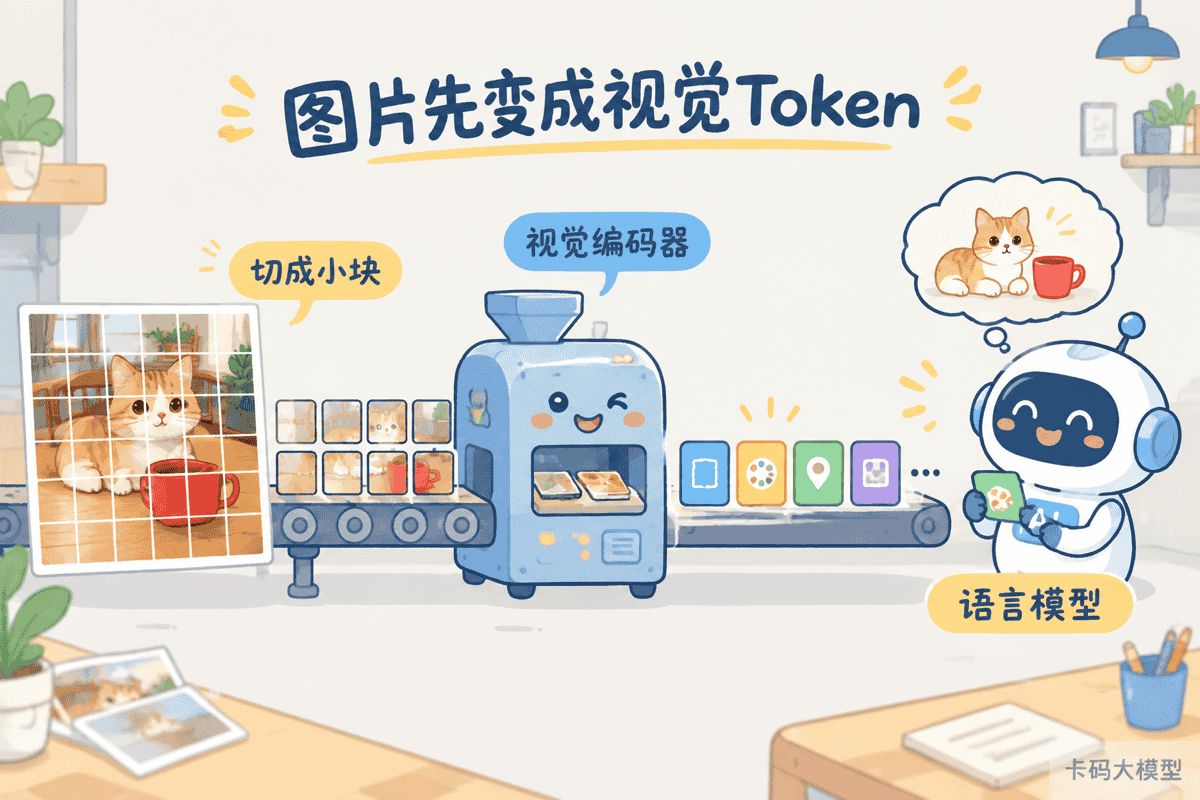
这张图回答的是:模型不是把整张图当成一个超大数字,而是先拆成局部视觉单元,再压缩成携带内容和位置信息的向量序列。
连接器再把这些向量的维度和分布转换成语言模型熟悉的形状。用户问题的文本Token和图片的视觉Token被放到同一段上下文中,语言模型才能回答“红色水杯在猫的哪边”这类跨模态问题。
不同模型会用动态分辨率、多尺度切块或Token压缩减少信息损失和计算量,但主线没变:先编码图像,再把视觉表示接入语言模型。
# 一段语音又是怎么变成音频Token的?
语音不是一串天生带有文字标签的数据,它只是振幅随时间变化的波形。第一步通常是把连续声音按采样率数字化,再切成几十毫秒级的短帧。
后面常见两条路:
- 先把波形转成频谱特征,再交给音频编码器;
- 由端到端编码器直接从原始波形学习特征。
音频编码器会把大量采样点压缩成更短的向量序列。这些表示里可以包含音素、节奏、音高、音色、情绪和环境声,不只是转录后的文字。
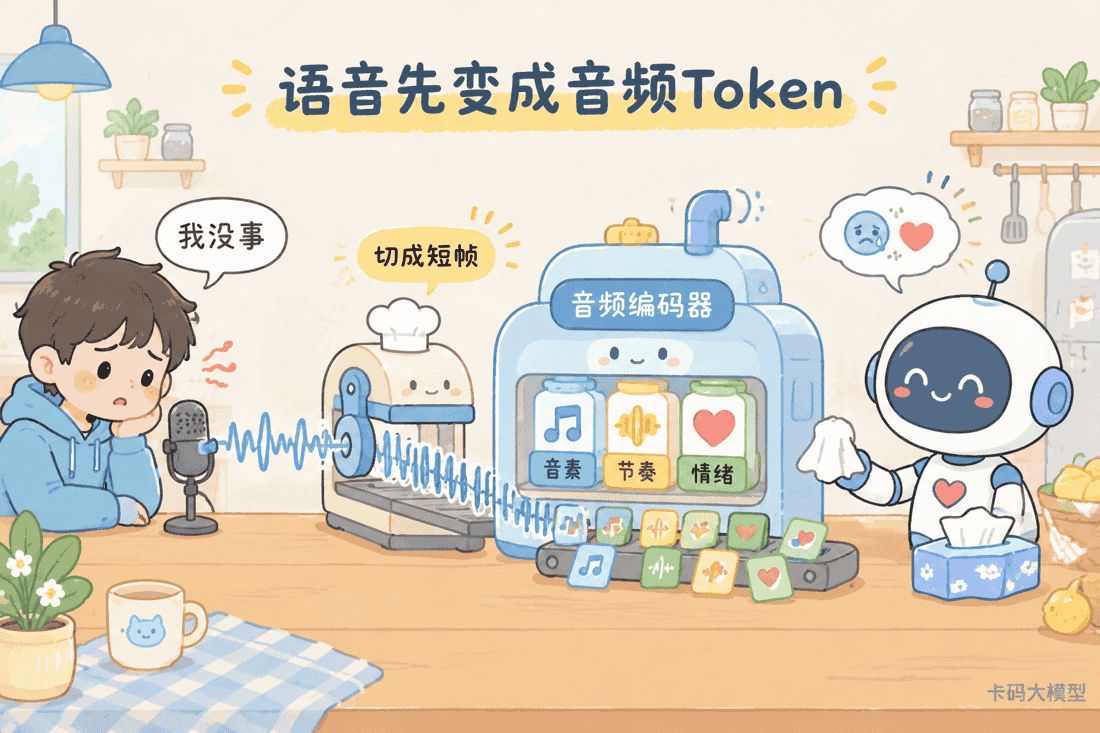
这张图回答的是:“我没事”转录后只剩三个字,直接处理语音却还能保留节奏和情绪线索。这也是原生音频理解相对“ASR转文字再提问”最有价值的地方。
如果任务只需要搜索会议记录,ASR级联方案成熟、便宜、可调试,未必需要原生音频模型。但如果任务依赖说话人、语气、音乐或环境声,先转文字就会丢掉关键证据。
# 图片、语音和文字是怎么对齐的?
只把Vision Encoder接到LLM上还不够。一串视觉向量刚接进去时,语言模型并不知道哪个向量表示猫,更不知道怎么根据它回答问题。
常见训练思路有三层:
- 先训好单模态编码器:让视觉编码器会提取图像特征,让音频编码器会提取语音特征;
- 做模态对齐:用图片-文本、语音-文本配对数据训练连接器,让相同语义的跨模态表示能被同一个模型使用;
- 做多模态指令微调:用图片问答、语音指令、多轮对话等数据,让模型学会按人类指令调用这些感知能力。
这三层不是所有模型都原样照搬的固定菜谱。有的会冻结编码器和LLM,只训连接器;有的会联合更新多个模块。但训练目标一致:让“画面里的猫”、“说出来的猫”和文本“猫”能参与同一次语义计算。
# LLaVA、Qwen-VL、GPT-4V的架构可以直接画等号吗?
不能。
LLaVA的公开架构很适合用来建立直觉:一边是预训练视觉编码器,一边是语言模型,中间用投影层连起来,再做视觉指令微调。
Qwen-VL等开源视觉语言模型会在分辨率处理、视觉Token压缩、位置编码和训练数据上做不同设计。闭源商业模型只公开部分技术信息,不能仅根据API行为就断定它的内部结构。
面试时最稳妥的说法是:它们共享“模态编码—表示对齐—跨模态推理”这条主线,具体编码器、连接方式和联合训练策略并不完全一样。
# 项目里应该直接用多模态模型吗?
先别被“原生多模态”四个字带跑。先问:任务的关键证据,在转成文字后会不会丢?
| 任务 | 更合适的起点 | 原因 |
|---|---|---|
| 扫描合同的关键字检索 | OCR + 文本RAG | 主要证据就是文字,链路便宜且可追溯 |
| 图表、版式和文字的联合问答 | 视觉语言模型 | 仅OCR会丢掉空间和视觉关系 |
| 会议转录与搜索 | ASR + 文本处理 | 需要的主要是可检索文本 |
| 语气、情绪、音乐或环境声理解 | 原生音频模型 | 转录会删掉任务所需的信号 |
然后再看三类指标:任务正确率,端到端延迟,以及单个成功任务的成本。多模态模型不是默认升级,它应该用在“非文本信息真的决定结果”的地方。
# 知识拓展
Q1:视觉Token越多,效果就一定越好吗?
不一定。更高分辨率和更小Patch能保留更多细节,但会增加Attention计算、显存、延迟和输入成本。如果任务只需要判断大类,把每个像素都保住反而是浪费。
Q2:多模态模型看到图片里的字,就等于OCR吗?
不等于。OCR强调字符识别、坐标和可校验的结构化输出;多模态模型更擅长把文字、版式和图像语义一起理解。需要高精度录入时,仍然要保留OCR的置信度、坐标和人工复核。
Q3:语音模型是不是一定先在内部转成文字?
不一定。级联系统会显式走ASR,原生音频模型则可以直接处理音频表示。后者能保留更多非文本线索,但调试和评估也更难。
Q4:多模态“幻觉”为什么会发生?
编码器可能没保住小字和细节,连接器可能没对齐好,训练数据可能存在偏差,语言模型也可能用强语言先验补全没看清的内容。因此不能只评估“答得像不像”,还要检查答案是否真的由输入图像或音频支撑。
Q5:面试时怎么用30秒讲清楚?
按“切分—编码—对齐—生成”四步讲。图片切Patch,语音切帧;专用编码器提取特征;Projector或Adapter映射到LLM的向量空间;多模态对齐和指令微调让模型会根据这些表示回答。
多模态不是让LLM突然长出眼睛和耳朵。
真正的核心,是让不同模态的信息进入同一个可计算、可对齐的语义空间。
← 大模型应用怎么稳定上线? 多模态能做什么? →
评论
验证登录状态...