# 多模态能做什么?文档解析、图片问答、视频理解
上一篇《多模态大模型:图片和语音是怎么被模型“看懂”的?》讲了图片、语音如何被编码成模型能处理的向量。
知道模型怎么“看”,不等于知道项目里该让它看什么。
面试官很可能继续问:“你说项目用了多模态,具体解决了什么问题?为什么不能先转成文本,再交给普通大模型?”
常见回答是:“多模态能识别图片、解析PDF、理解视频,能力更强。”
方向没错,但没有说清任务依赖哪类证据、输入输出是什么、文本方案会丢什么。这会让人听不出你是在做工程选型,还是只把图片塞进了模型接口。
# 简要回答
- 文档解析:输入是PDF、扫描件或截图,输出不只是文字,还包括标题层级、表格、图表、坐标和阅读顺序;
- 图片问答:输入是图片和问题,模型要先找到与问题相关的区域,再结合文字、物体和空间关系给出答案;
- 视频理解:输入是视频和问题,系统要联合处理关键帧、动作顺序、字幕和声音,回答“发生了什么、为什么发生”;
- 多模态RAG:先检索相关页、图或视频片段,再让多模态模型围绕证据回答,避免把全部素材一次性塞进上下文。
判断是否该用多模态,只问一句:任务所需的关键证据,转成纯文本后会不会丢失?
# 详细回答
# 文档解析为什么不等于OCR?
OCR解决的是“这几个像素是什么字”,文档解析还要回答:字属于哪个标题、哪个单元格、哪张图,阅读顺序又是什么。
例如一份财报里同时有正文、双栏排版、表格和柱状图。把OCR结果从上到下拼成一段长文本,字可能一个没错,但表头和数值错位后,含义已经变了。
一个可用的文档解析结果,通常至少包含三层:
- 内容层:文字、公式、印章、图表和图片;
- 结构层:标题层级、段落、列表、表格行列和阅读顺序;
- 定位层:页码、坐标、区域类型和原图引用,方便回溯证据。
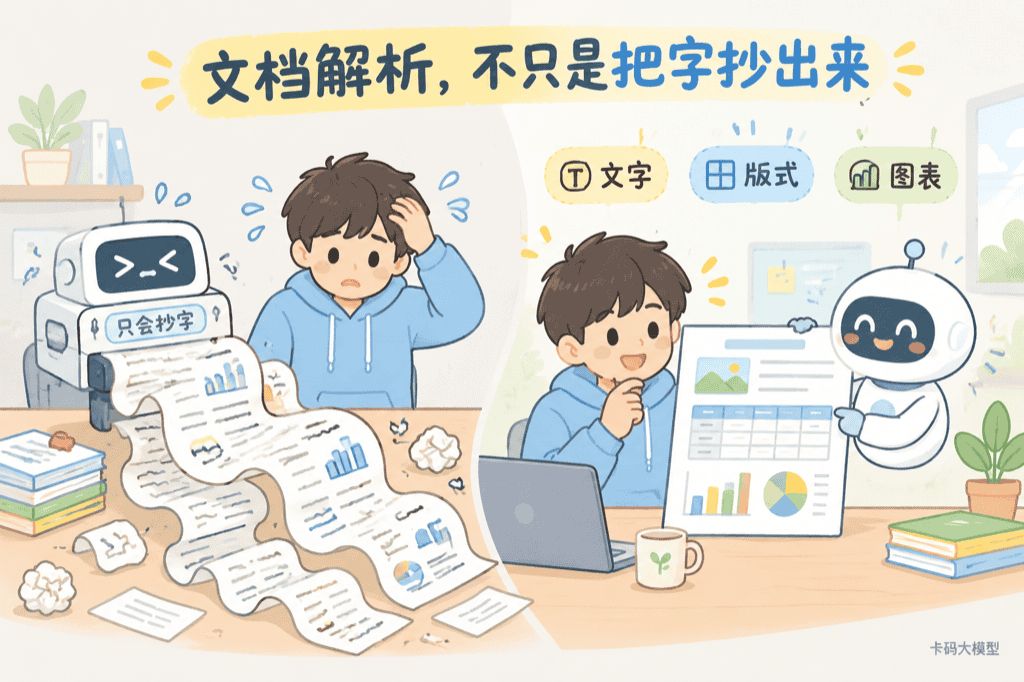
这张图回答的是:只抄出文字,会把页面原有的结构打散;多模态解析真正要保住的是文字、版式和图表之间的对应关系。
工程上也不要迷信“一个多模态模型包打天下”。更稳的做法往往是组合链路:
PDF / 扫描件
→ 页面分类与图像预处理
→ OCR + 版面分析 + 表格识别
→ 多模态模型补充图表理解和语义校正
→ 结构化JSON / Markdown
→ 质量校验与人工复核
2
3
4
5
6
固定模板的票据,传统OCR加规则通常更便宜、更稳定;版式复杂、图文混排、模板变化大的材料,才更能体现多模态模型的价值。
# 图片问答真正难在哪里?
图片问答不是“识别完图片,再随便聊两句”。同一张图,问题不同,模型需要寻找的证据也不同。
给一张机房照片:
- 问“画面里有几台机柜”,依赖物体检测和计数;
- 问“红色告警灯在哪台设备上”,依赖颜色、位置和物体归属;
- 问“这个接线是否存在风险”,还要结合视觉证据与外部规范。
所以链路应该围绕问题来组织:
图片 + 问题
→ 判断问题需要文字、物体还是空间关系
→ 定位相关区域并读取细节
→ 必要时检索业务知识
→ 基于图像证据生成答案
2
3
4
5
最容易翻车的是模型“看不清但敢回答”。小字、密集目标、遮挡和模糊区域都会让视觉证据不足,语言模型却可能用常识补出一个很顺的答案。
生产环境要给答案加证据锚点,例如页码、裁剪区域、检测框或原图链接。高风险场景还要允许模型明确返回“当前图片无法判断”,而不是强制它给结论。
# 视频理解为什么不能只看一张截图?
视频比图片多出来的关键维度是时间。
只看“杯子落在地上”这一帧,无法判断是人碰倒的、猫推下去的,还是它本来就在地上。要解释事件,必须把前后帧串起来。
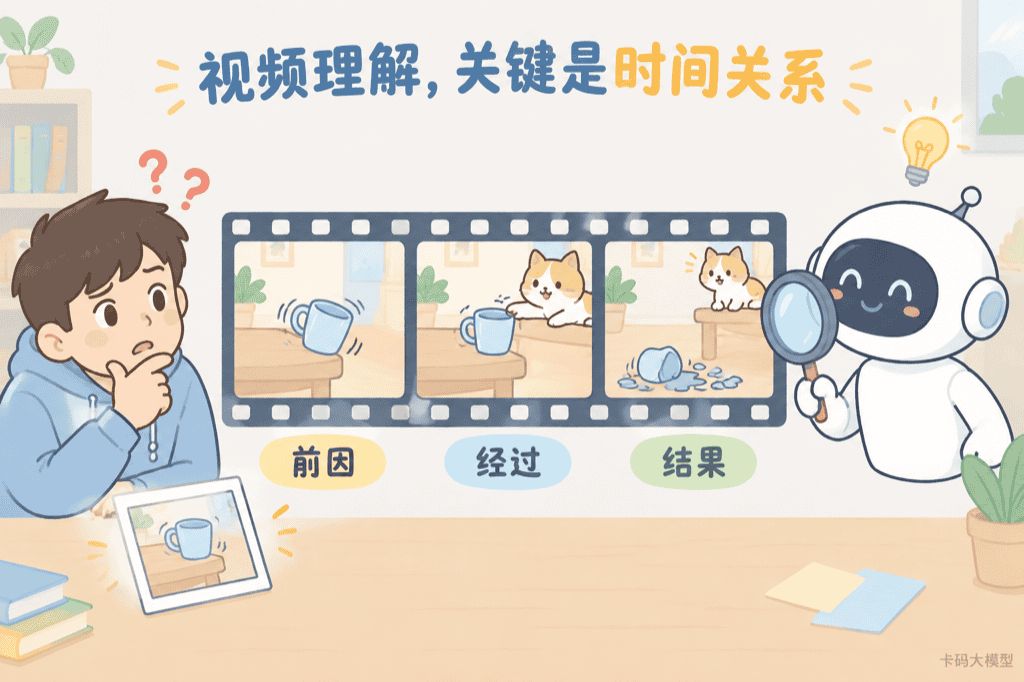
这张图回答的是:单帧只能告诉模型某个瞬间有什么,连续片段才能提供前因、经过和结果。
一段视频通常会被拆成多路信息:
- 关键帧或短片段,提供人物、物体、动作和场景变化;
- 音轨,提供对话、语气、环境声和事件提示;
- 字幕与画面文字,提供可检索的文本线索;
- 时间戳,负责把不同证据重新对齐。
工程上不会默认逐帧分析。一个30分钟、每秒30帧的视频有5.4万帧,全部送进模型既慢又贵。
常见做法是先按固定间隔、镜头切换或事件检测抽取候选片段,再围绕用户问题二次加密采样。回答时必须带时间范围,例如“02:14—02:22出现设备冒烟”,否则结果很难复核。
# 多模态怎么和文本RAG结合?
多模态和RAG不是二选一。真实系统里,更常见的是先检索缩小范围,再让模型看原始证据。
以产品手册问答为例,可以在离线阶段保存四类信息:
- OCR文本和标题层级,用于关键词检索;
- 文本或页面Embedding,用于语义检索;
- 原始页图、图表裁剪和坐标,用于视觉复核;
- 文档版本、权限和页码,用于过滤与引用。
在线提问时,先用文本检索召回候选页;如果问题涉及接线图、表格或版式,再把候选页原图交给多模态模型。这样既保留了文本RAG便宜、可检索的优势,又没有丢掉视觉证据。
视频也一样。先用字幕、镜头摘要和时间戳建立索引,召回相关时间段后再读取原片段。多模态模型负责精读,不负责盲看整个资料库。
这和前面讲过的长文档层级检索是同一个工程思想:小范围检索命中,大范围证据返回,只是这里返回的不止文本,还包括页面、图片或视频片段。
# 什么时候用文本就够了?
不要看到PDF、图片、视频就默认上多模态。输入载体是视觉内容,不代表任务证据一定是视觉的。
| 场景 | 建议起点 | 判断理由 |
|---|---|---|
| 扫描合同中查公司名称 | OCR + 文本检索 | 关键证据就是文字 |
| 财报图表趋势问答 | 多模态模型 | 数值与图形、图例、位置共同决定含义 |
| 商品图片生成一句描述 | 多模态模型 | 需要直接理解物体和属性 |
| 监控录像按字幕搜索 | ASR + 文本检索 | 只需要找说过的话 |
| 监控录像判断动作先后 | 视频理解 | 时间顺序本身就是证据 |
| 固定模板发票录入 | OCR + 模板规则 | 输出字段稳定,更容易校验 |
一个实用决策顺序是:先尝试可靠的文本化方案,再检查它是否丢失任务所需证据;只有丢失真的影响结果,才引入多模态链路。
# 上线前要评估什么?
不能只拿几张效果好的图片做演示。三类场景的评估重点并不相同:
- 文档解析看字符准确率、表格结构准确率、阅读顺序和字段完整率;
- 图片问答看答案正确率、证据定位准确率和拒答质量;
- 视频理解看事件识别、时间定位误差、跨片段推理和音画一致性;
- 整条链路还要看端到端延迟、单任务成本与人工复核率。
测试集要包含低清、旋转、遮挡、密集小字、长视频和无答案样本。否则模型在Demo里“什么都能看”,一到真实数据就会暴露证据缺失和幻觉问题。
# 知识拓展
Q1:多模态文档解析会替代OCR吗?
短期内更像互补。OCR擅长稳定地识别字符和坐标,多模态模型擅长理解版式、图表和上下文。对精度要求高的系统,保留两者结果并做交叉校验通常更稳。
Q2:图片问答和图片分类有什么区别?
图片分类的输出集合通常提前固定,例如“猫、狗、汽车”;图片问答的问题和答案更开放,还可能依赖文字、计数、位置关系和外部知识。
Q3:视频抽帧越多,理解效果一定越好吗?
不一定。帧太少会漏事件,帧太多会增加成本和噪声。采样密度应该跟镜头变化、事件速度和问题类型一起调整,并用时间定位准确率验证。
Q4:多模态RAG能只存图片Embedding吗?
可以做,但通常不够。生产系统还需要保存OCR文本、结构元数据、原图坐标、版本和权限,才能兼顾召回、过滤、引用与复核。
Q5:面试时怎么讲自己的多模态项目?
按“关键证据—输入输出—处理链路—失败边界—评估指标”来讲。不要只说用了哪个模型,要说清楚纯文本方案丢了什么,以及多模态方案是否真的把这部分效果补回来了。
多模态不是给应用多装一双眼睛,就自动变聪明。
真正的工程能力,是知道哪些证据必须看,哪些内容转成文本反而更稳。
评论
验证登录状态...