# 列表、字典和集合推导式怎么写?什么时候不该用?
面试官问:“Python的推导式怎么写?它和普通for循环有什么区别,什么时候不该用?”
多数人能写出[n * 2 for n in nums],但一问到多层for的执行顺序、if放在前面和后面有什么区别、推导式里的变量会不会泄漏到外面,就开始含糊。这道题真正考的是:推导式本质上是“一个带返回值的循环”,它适合描述“从一组数据构造一个新容器”,不适合承载复杂逻辑。
# 简要回答
推导式是用一个表达式构造新容器的语法。列表推导式写成[表达式 for 变量 in 可迭代对象 if 条件],把方括号换成花括号就是集合推导式,花括号里写键: 值就是字典推导式。把方括号换成圆括号得到的不是元组推导式,而是生成器表达式,它按需产出元素,不会一次性构造整个列表。
推导式和等价的for循环在执行逻辑上一样:多个for从左到右对应从外到内的循环嵌套。区别在于推导式一定会产生新对象,而且在Python 3中循环变量不会泄漏到外层作用域。
推导式适合“过滤 + 转换”这种简单构造。 当逻辑需要多个分支、嵌套超过两层、或者主要目的是执行副作用(打印、写文件、修改其他对象)时,应该改回普通for循环。
# 详细回答
# 三种推导式和生成器表达式
先看最常见的四种写法:
scores = [88, 92, 75, 92]

doubled = [s * 2 for s in scores]           # 列表:[176, 184, 150, 184]
unique = {s for s in scores}                # 集合:{88, 92, 75},顺序不固定
indexed = {i: s for i, s in enumerate(scores)}  # 字典:{0: 88, 1: 92, 2: 75, 3: 92}
lazy = (s * 2 for s in scores)              # 生成器表达式
print(type(lazy).__name__)                  # generator
2
3
4
5
6
7
列表推导式保留所有元素和顺序,集合推导式自动去重,字典推导式遇到重复的键会让后面的值覆盖前面的值。字典和集合的哈希特性,在《Python字典和集合有什么区别?》里讲过,推导式只是换了一种构造方式,规则不变。
没有元组推导式。 (s * 2 for s in scores)的结果是生成器,需要元组时写tuple(s * 2 for s in scores)。
# if放在哪里,含义完全不同
推导式里的if有两种位置:
nums = [1, 2, 3, 4, 5]

evens = [n for n in nums if n % 2 == 0]
print(evens)   # [2, 4]

labels = ["偶" if n % 2 == 0 else "奇" for n in nums]
print(labels)  # ['奇', '偶', '奇', '偶', '奇']
2
3
4
5
6
7
写在for后面的if是过滤条件,决定元素要不要进入结果,结果长度可能变短。写在for前面的if ... else是条件表达式,属于“表达式”的一部分,每个元素都会产出一个结果,长度不变。
一个常见错误是把过滤写成[n for n in nums if n > 2 else 0],这是语法错误。过滤条件后面不能接else;需要“不满足时给默认值”,就把条件表达式移到前面。
# 多层for的执行顺序
多个for时,从左到右就是从外到内,和写普通嵌套循环的顺序一致:
pairs = [(row, col) for row in range(2) for col in "ab"]
print(pairs)  # [(0, 'a'), (0, 'b'), (1, 'a'), (1, 'b')]

# 等价于
pairs = []
for row in range(2):
    for col in "ab":
        pairs.append((row, col))
2
3
4
5
6
7
8
很多人会误以为右边的for是外层。记住“推导式去掉表达式部分,剩下的for和if按原顺序写成缩进,就是等价循环”,就不会搞反。
展平二维列表是这种写法的典型场景:
matrix = [[1, 2], [3, 4], [5, 6]]
flat = [n for row in matrix for n in row]
print(flat)  # [1, 2, 3, 4, 5, 6]
2
3
注意row必须先在左边的for里定义,右边的for才能使用它。
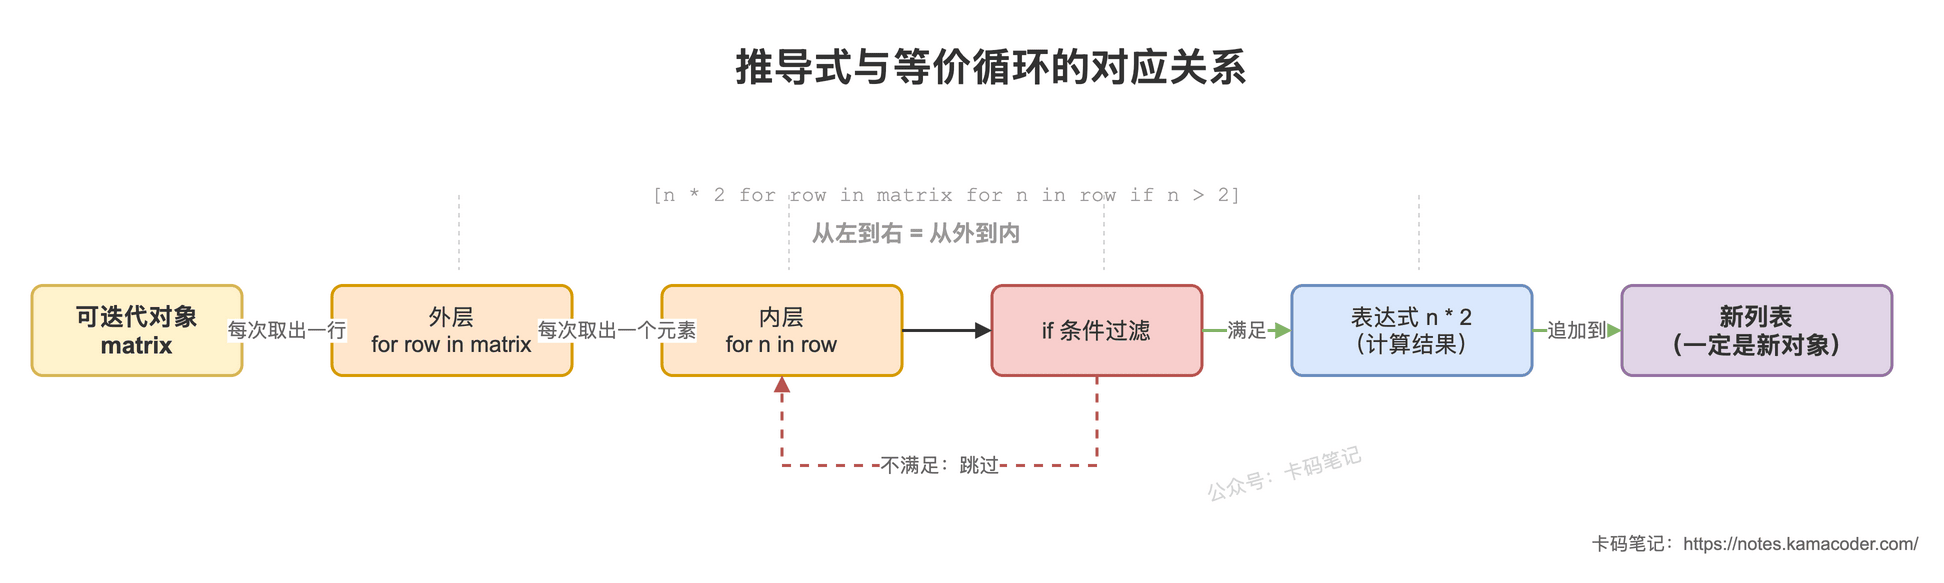
图中把一条推导式拆成了循环的各个环节:左边的for是外层循环,右边的for是内层循环,if决定元素能否通过,最左边的表达式只负责计算要放进结果的值。所有通过的结果都追加到一个新建的列表里。
# 推导式有自己的作用域
在Python 3中,推导式的循环变量不会泄漏到外层:
name = "外层"
names = [name for name in ["Alice", "Bob"]]
print(name)  # 外层
2
3
推导式内部的name是另一个名字,执行结束后,外层的name依然指向原来的字符串。这和普通for循环不同,普通for循环结束后,循环变量仍然保留最后一次的值。循环的这类细节可以回顾《Python条件判断和循环有哪些常见写法与易错点?》。
Python 2的列表推导式会泄漏变量,这是Python 3修正的行为之一。CPython 3.12起把列表、字典、集合推导式内联到所在函数中执行,不再单独创建函数对象,这属于性能优化,变量不泄漏的语义保持不变。
# 生成器表达式为什么更省内存
列表推导式会立即构造整个列表;生成器表达式只保存“怎么产生下一个元素”,需要时才计算:
total = sum(n * n for n in range(1_000_000))
print(total)  # 333332833333500000
2
sum()每次向生成器要一个值,用完就丢,不需要先存一百万个平方数。函数只接收一个参数时,生成器表达式外层的括号可以省略。
但生成器表达式只能遍历一次,也不支持索引和len()。数据量小、需要多次使用结果时,用列表推导式更直接。生成器更省内存,不等于一定更快,速度要看具体场景。
# 什么时候不该用推导式
逻辑超过一行能看懂的程度。 多个条件分支、嵌套三层以上的for,写成推导式只会让读代码的人逐字拆解。改成普通循环加变量名,可读性更好。
主要目的是副作用。 下面这种写法只是为了调用print,却额外构造了一个装满None的列表:
names = ["Alice", "Bob"]
[print(n) for n in names]  # 不推荐:结果列表 [None, None] 没有用

for n in names:            # 推荐
    print(n)
2
3
4
5
推导式的意义是“产出一个容器”。不需要这个容器时,就应该写for循环。
需要提前结束或处理异常。 推导式里没法写break,也不能在内部写try/except。需要“找到第一个就停”时,可以用next()配合生成器表达式,或直接写循环。
# 知识拓展
面试官可能追问:
Q1:推导式比for循环快吗?
在CPython中,简单的列表推导式通常比“循环 + append”略快,因为省去了每次查找和调用append方法的开销。但差距一般不大,而且逻辑一复杂就不明显了。选择推导式的理由应该是可读性,而不是性能。
Q2:在推导式里修改原列表会怎样?
推导式会生成新列表,但表达式里如果调用了会原地修改对象的方法,原对象照样会被改。比如[row.append(0) for row in matrix]会修改matrix里的每一行,同时返回一个全是None的列表。这正是“不要在推导式里做副作用”的原因。
Q3:字典推导式怎么交换键和值?
写成{v: k for k, v in d.items()}。要注意原字典的值必须可哈希,而且如果有重复的值,交换后只会保留最后一个键。
Q4:如何在推导式里找到第一个满足条件的元素?
用next()配合生成器表达式,并给一个默认值:
nums = [3, 7, 10, 15]
first_even = next((n for n in nums if n % 2 == 0), None)
print(first_even)  # 10
2
3
生成器找到10就停下,不会继续检查后面的元素;如果一个都没找到,返回默认值None,不会抛出StopIteration。
评论
验证登录状态...