# Python字符串为什么不可变?常用操作有哪些?
面试官问:“Python的字符串能修改吗?为什么要设计成不可变?”
多数录友能答出“不可变”,但讲不清它带来了什么。更常见的坑是以为text.replace()、text.upper()改了原字符串,结果拿着旧变量继续用。这道题要讲清两件事:不可变换来了哪些能力,以及字符串操作为什么总是返回新对象。前置知识可以先看《Python中的可变对象和不可变对象有什么区别?》。
# 简要回答
Python 3的str是不可变的Unicode字符序列。字符串创建后,不能修改其中的字符;upper()、replace()、strip()这类方法都会返回新字符串,原字符串保持不变。
不可变主要带来三点好处。第一,字符串内容不变,哈希值就稳定,所以能作为字典键和集合元素。第二,多个名字可以放心共享同一个字符串对象,不会出现一处修改、处处受影响。第三,解释器可以做缓存和复用优化,例如在CPython中会缓存字符串的哈希值,并对部分字符串做驻留(interning)。
代价是每次“修改”都要创建新对象。循环里大量拼接字符串时,推荐先把片段放进列表,最后用"".join(parts)一次生成结果。
# 详细回答
# 不可变到底限制了什么?
不可变是指字符串对象本身不能被修改,并不是变量不能重新赋值:
text = "hello"
# text[0] = "H"         # TypeError: 'str' object does not support item assignment

new_text = text.replace("h", "H")
print(text)             # hello
print(new_text)         # Hello

text = text.upper()     # 名字text重新绑定到新字符串
print(text)             # HELLO
2
3
4
5
6
7
8
9
replace()没有改动"hello"这个对象,而是返回了新字符串"Hello"。最后一行看起来像“改了text”,实际是名字text从旧对象换成指向upper()返回的新对象。
很多bug就出在这里:只写text.strip()却不接收返回值,原来的text仍然带着空格。
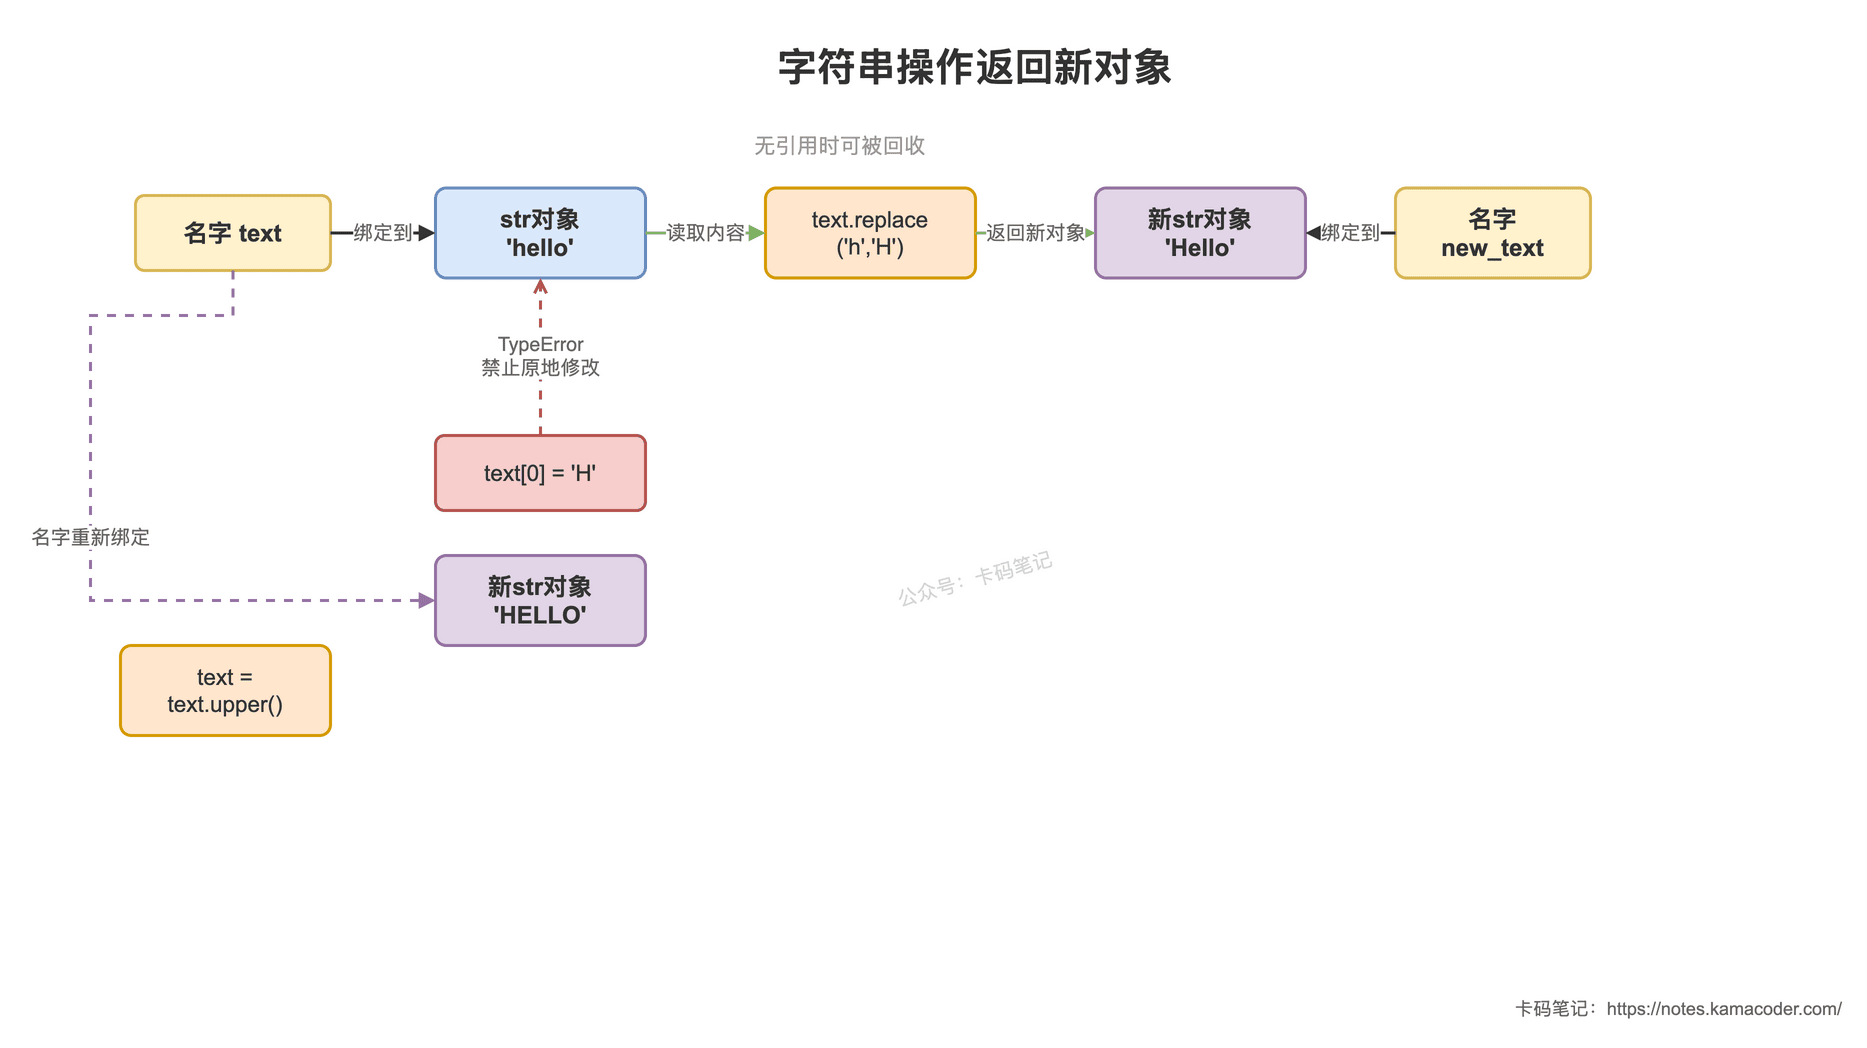
图中要看清三条路径:方法调用读取原对象、返回新对象;索引赋值试图原地修改,被直接拒绝;重新赋值只改变名字的指向,原对象本身从未变化。
# 为什么要设计成不可变?
可哈希,才能做字典键
字典和集合靠哈希值定位元素。如果键对象能在插入后被修改,它的哈希值就可能改变,字典再也找不到这个键。字符串不可变,哈希值在对象生命周期内保持稳定;在CPython中,字符串第一次计算出的哈希值还会缓存在对象里,后续直接复用。字典和集合的哈希规则在《Python字典和集合有什么区别?》中展开。
可以放心共享
两个名字指向同一个字符串,任何一方都改不了它,所以共享是安全的。函数接收字符串参数时,也不用担心被调用方偷偷改掉。
给实现留出优化空间
在CPython中,部分看起来像标识符的字符串字面量会被驻留,相同内容复用同一个对象,加快属性名、变量名等查找时的比较。这是实现优化,不是语言保证:
import sys

name = "".join(["py", "thon"])        # 运行时拼出来的字符串
print(name == "python")               # True
print(sys.intern(name) is sys.intern("python"))  # True,显式驻留后是同一对象
2
3
4
5
==比较的是内容,是业务代码该用的写法;is比较的是不是同一个对象,结果依赖实现细节。两者的区别见《is和==有什么区别?》。
# 循环拼接为什么推荐join?
每次result = result + piece都要申请新空间,把旧内容和新片段复制进去。循环拼接n次,最坏情况下总复制量接近O(n²)。
words = ["Python", "Java", "Go"]

result = ""
for word in words:
    result += word + ","       # 每轮可能创建新字符串

joined = ",".join(words)       # 先计算总长度,再一次性生成
print(result)                  # Python,Java,Go,
print(joined)                  # Python,Java,Go
2
3
4
5
6
7
8
9
在CPython中,+=拼接在某些条件下(例如旧字符串只有当前这一个引用)可以就地扩展,所以小规模测试里差距可能不明显。但这个优化依赖引用计数等实现细节,其他Python实现不一定有。拼接次数多、片段不确定时,用列表收集再join是更稳定的写法。只拼两三个固定片段,用+或f-string完全没问题。
# 常用操作和易错点
字符串方法数量很多,面试和日常更关心几类高频操作,以及它们的返回值:
line = "  name=Alice, age=25  "

clean = line.strip()                    # 'name=Alice, age=25',去两端空白
parts = clean.split(", ")               # ['name=Alice', 'age=25']
print(clean.startswith("name"))         # True
print(clean.find("age"))                # 12,找不到返回-1
print(clean.replace("Alice", "Bob"))    # name=Bob, age=25

name, age = "Alice", 25
print(f"{name} is {age}")               # Alice is 25(f-string,Python 3.6+)
print("-".join(["a", "b", "c"]))        # a-b-c
2
3
4
5
6
7
8
9
10
11
这几个方法里有三个常见坑:
find和index的失败行为不同:find找不到返回-1,index直接抛ValueError。用find时不能把-1当成合法下标,clean[-1]会取到最后一个字符。split()和split(" ")不一样:不传参数时按任意连续空白切分并忽略首尾空白;传" "时每个空格都是分隔符,会出现空字符串。join只接受字符串元素:",".join([1, 2])会报TypeError,需要先用map(str, ...)或推导式转换。
字符串也是序列,支持索引、切片和in判断。切片会返回新字符串,具体规则在《Python切片和序列解包怎么用?》中讲。
# 知识拓展
面试官可能追问:
Q1:既然字符串不可变,text += "a"为什么不报错?
因为+=对不可变对象的效果是“算出新对象,再重新绑定名字”。text换了一个对象,原来的字符串没有被修改。可以在拼接前后打印id(text)观察,但CPython的就地扩展优化可能让id看起来没变,所以不要拿id作为判断依据,理解绑定过程即可。
Q2:所有内容相同的字符串都是同一个对象吗?
不是。驻留只覆盖部分字符串,例如CPython中部分标识符形式的字面量;运行时拼接、读取文件得到的字符串通常是新对象。需要大量重复比较时可以用sys.intern()显式驻留,业务判断相等始终用==。
Q3:需要频繁修改单个字符时怎么办?
把字符串转成列表,在列表上修改,最后join回字符串,例如chars = list(text),修改后"".join(chars)。如果是不断写入文本,也可以用io.StringIO。核心思路都是:在可变容器里完成修改,最后生成一次字符串。
Q4:str和bytes有什么区别?
str是Unicode文本,bytes是原始字节,两者都不可变。文本写文件或走网络时要编码成bytes,例如"你好".encode("utf-8");读回来再用decode("utf-8")还原。Python 3不会在两者之间隐式转换,"a" + b"a"会直接报TypeError。
评论
验证登录状态...