# 为什么大模型常用 Transformer?RNN、CNN 输在哪里
前面大模型是怎么训练出来的讲了预训练这件事:把大量文本送进模型,让它不断调整参数。可一旦数据规模上来,问题就变成了:模型能不能高效处理长序列,还能把训练任务分摊到大量计算设备上?
录友面试时常被问:“RNN 也能处理文本,CNN 也能并行计算,为什么主流大语言模型大多采用 Transformer?”
有人回答:“因为 Transformer 有 Attention,能看到全文。”方向没错,但只说到了一个模块。面试官再问“CNN 也能看远处吗?”“生成时为什么还是一个 token 一个 token 地吐?”就容易答不下去。
# 简要回答
- RNN 的主要限制是序列依赖:第 个位置要等第 个位置算完,训练时很难沿序列维度充分并行;远处信息也要经过多次状态传递。
- CNN 可以并行处理序列,但普通卷积先看局部。要让相距很远的两个位置交换信息,需要叠层、扩大卷积核,或使用空洞卷积等设计。
- Transformer 的自注意力让一个位置在一层内直接聚合其他允许访问的位置的信息。训练时,各位置的计算可以组织成大规模矩阵运算,适合加速器。
- 它有代价:标准全量自注意力的注意力矩阵随序列长度 按 增长;而自回归生成仍要逐 token 进行。
真正的原因不是“Attention 比一切都强”,而是 Transformer 在信息交互路径和训练并行性上,给大规模语言建模提供了很合适的组合。
# RNN 为什么难以支撑大规模训练?
RNN(循环神经网络)读一句话时,会把上一步的隐藏状态传给下一步。比如读到“他”时,它已经把前面读过的信息压进了状态里,再结合当前输入继续计算。
这个思路很自然,但它有两个工程限制。
第一,沿序列方向必须排队。 第 20 个 token 的状态依赖第 19 个,第 19 个又依赖第 18 个。即使有很多 GPU,单条序列上的这些步骤也不能简单地同时算完。数据批次和某些计算仍可并行,但关键的时间步依赖还在。
第二,远处信息要经过较长的路径。 一句话开头的信息要影响结尾,就得经过中间许多次状态更新。LSTM、GRU 用门控机制缓解了这个问题,但没有消除逐步计算的依赖。
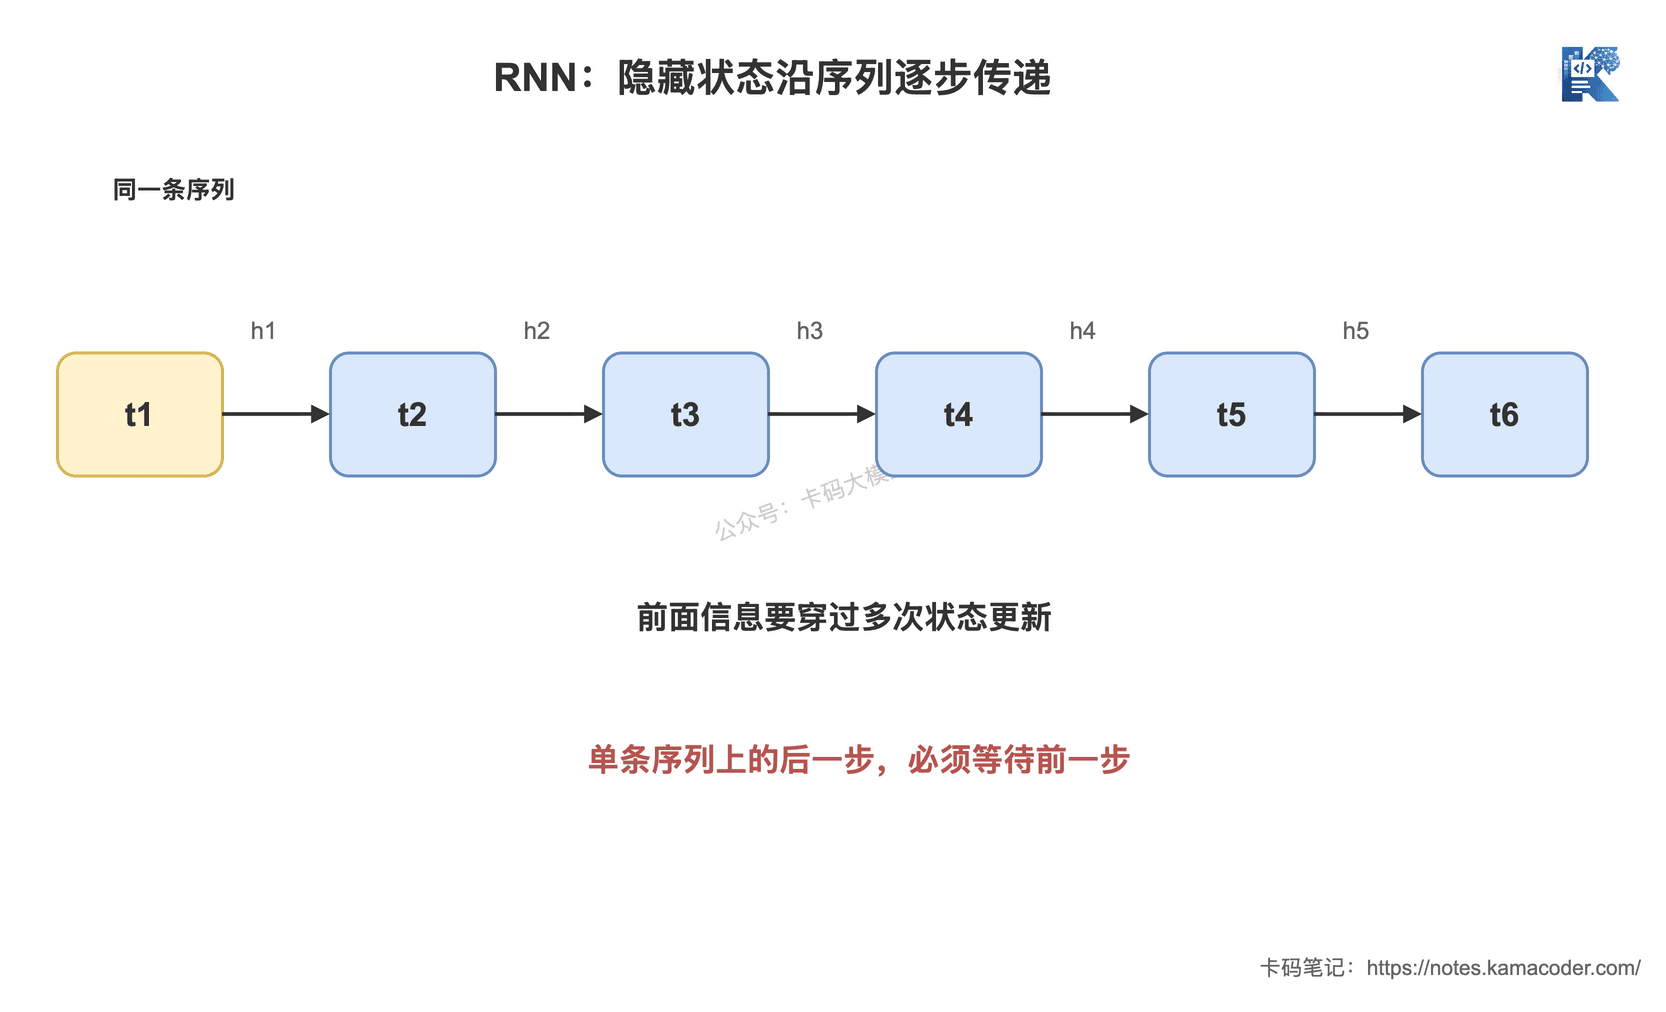
这张图回答的是:为什么单条序列上的计算必须逐步进行?箭头表示前一步的隐藏状态传给后一步;开头的信息要影响结尾,也必须经过中间的多次状态更新。RNN 并非不能处理长文本,而是当训练规模继续扩大时,这条串行链会限制吞吐。
# CNN 都能并行了,为什么还需要 Transformer?
CNN(卷积神经网络)没有 RNN 那样的逐步状态依赖。同一层的多个位置可以并行计算,这一点很重要。所以,“CNN 不适合文本,因为它不能并行”是错的。卷积序列模型也曾用于机器翻译。
它的主要取舍在信息能看多远。普通卷积每次只覆盖附近的一段,叠更多层后,远处信息才逐渐传过来。扩大卷积核、使用空洞卷积或加入注意力,都能改善这个问题,但结构也会随之变化。
假设句首交代“小王负责修改报告”,中间插入一长段项目背景,句尾才说“他第二天提交了新版”。判断“他”指谁,需要结合相隔较远的上下文。CNN 可以学这种关系;只是依靠局部卷积时,信息通常要跨越多层,才能在两个位置之间汇合。
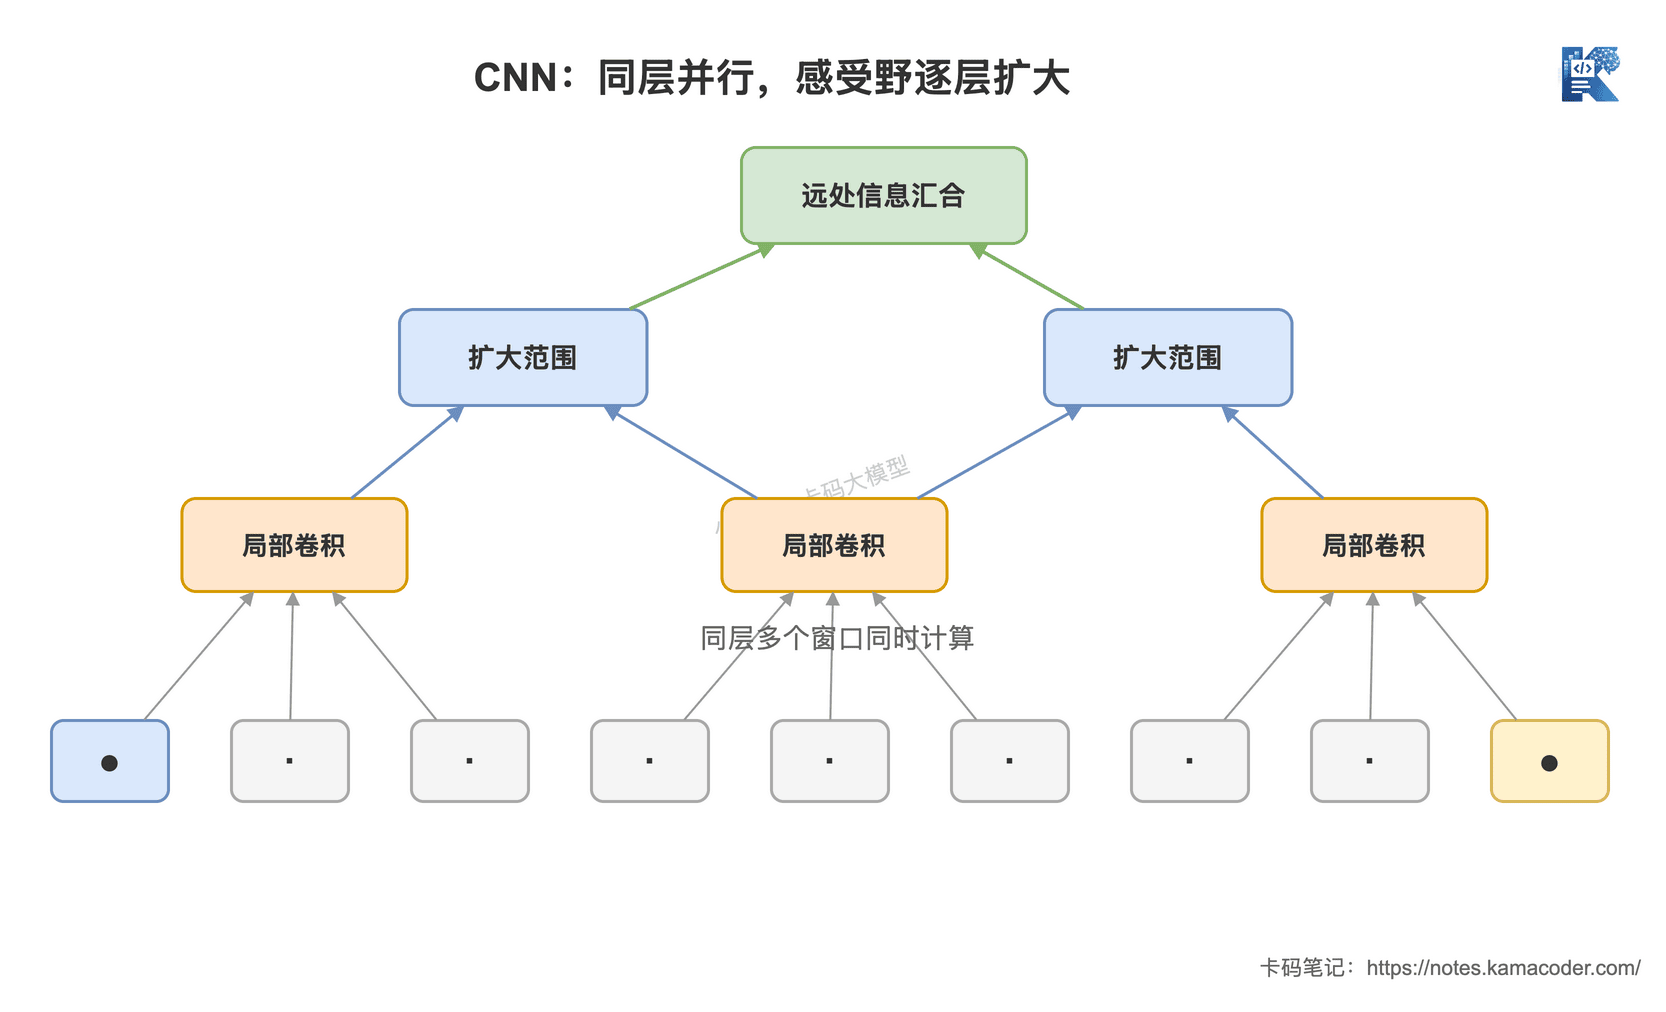
这张图回答的是:CNN 如何把远处的信息连接起来?同一层的多个局部窗口可以同时计算,但两端的信息要到更高层才汇合。图中画的是普通局部卷积的信息路径。
CNN 解决了 RNN 的串行问题,却仍要为远距离信息交互设计传播路径。
# Transformer 的自注意力改变了什么?
Transformer 不靠隐藏状态沿序列逐步传递,也不要求相距很远的 token 只能通过多层局部卷积相遇。
以刚才的“他”为例。自注意力会为这个位置计算它与其他可见位置的关系,再把相关信息按权重聚合回来。这里的“直接”指一层之内存在信息交互路径,不等于模型一定能正确判断“他”指谁。它仍要通过训练学会利用这条路径。
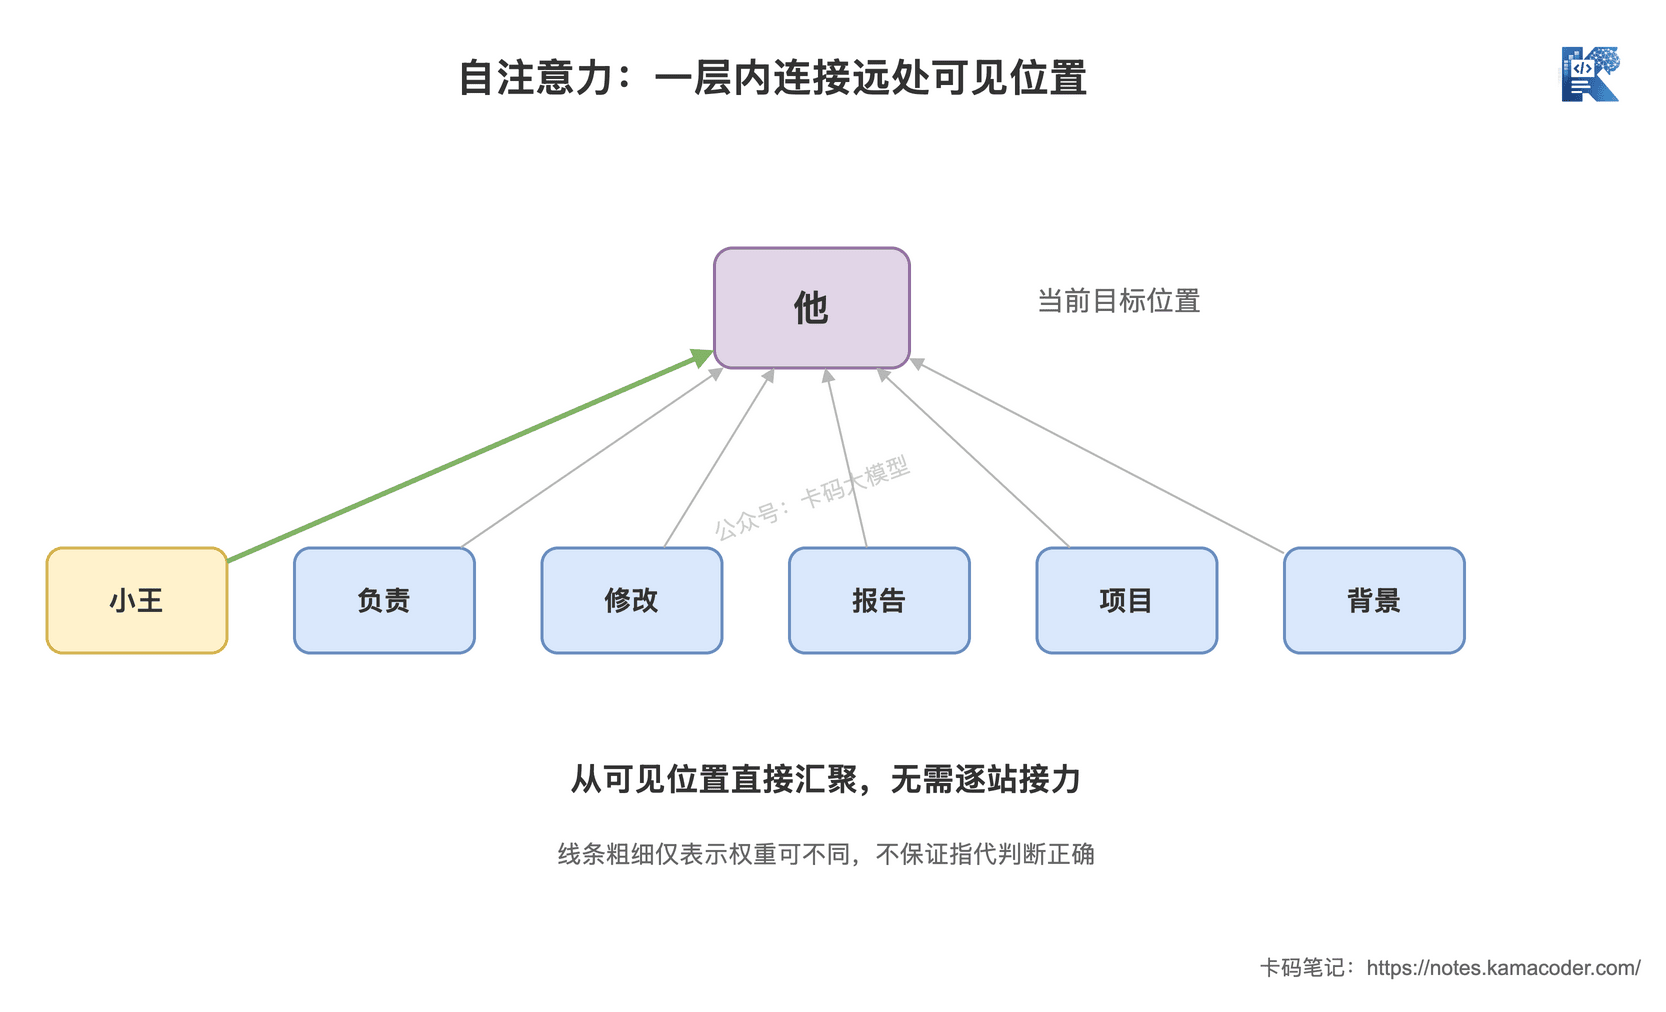
这张图回答的是:远处的“小王”怎样影响当前的“他”?自注意力允许当前目标在一层内直接汇聚前文可见位置的信息,无需逐站接力。不同连线可以有不同权重;训练时,这类关系还能组成矩阵并行计算。信息路径短,序列维度又容易并行,这才是自注意力适合大规模训练的关键。
注意“可见位置”这个限定。在 BERT 这类编码器里,一个位置通常能看两侧上下文;在 GPT 这类自回归模型里,因果掩码会挡住未来位置。它们都属于 Transformer 家族,但注意力的可见范围不同。三种常见结构可以接着看Encoder-only、Decoder-only 和 Encoder-Decoder。
# “训练能并行”为什么不等于“生成也能并行”?
这点最容易答错。
训练自回归模型时,一段已知文本已经摆在面前。我们可以一次输入整段序列,用因果掩码保证每个位置只能使用它前面的内容,然后同时计算多个位置的预测和损失。
生成时,下一枚 token 还不知道。必须先算出它,才能把它接到上下文后面,再预测下一枚。所以用户看到的输出仍是逐 token 出现。
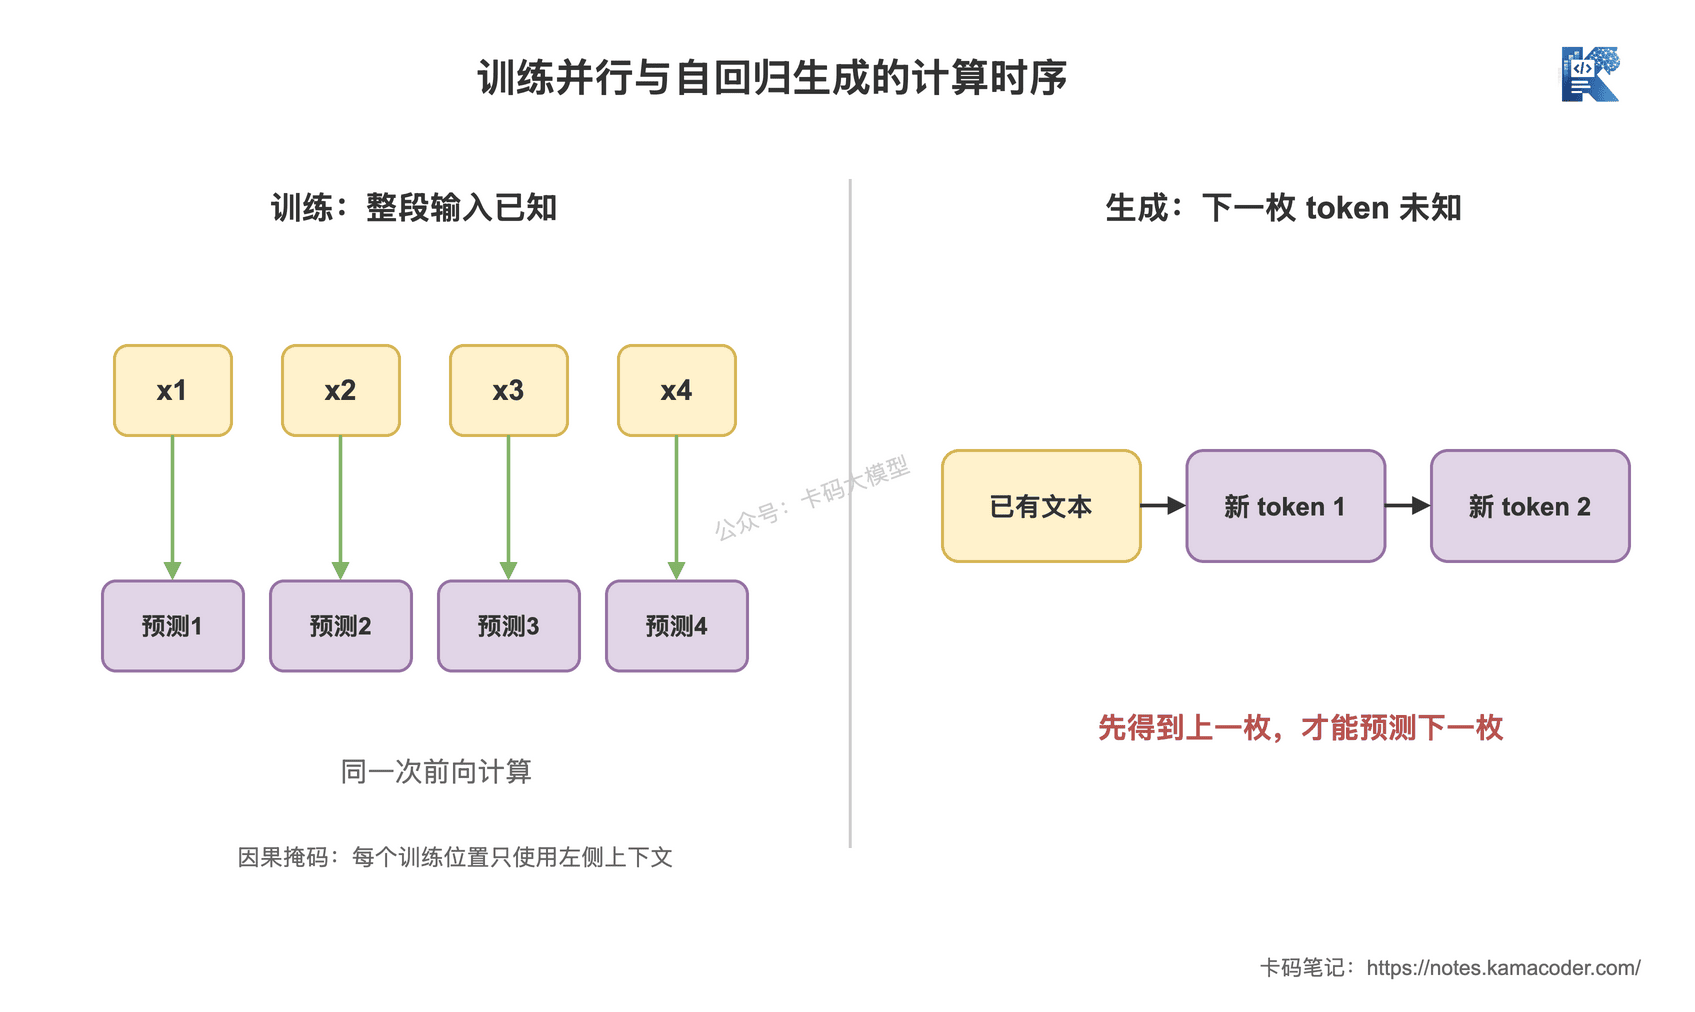
这张图回答的是:为什么训练能同时计算多个位置,而生成仍要逐个输出?训练时整段输入已知,因果掩码限制每个位置只能使用左侧上下文;生成时新 token 尚未知,必须先得到上一枚,才有下一步的输入。
Transformer 并行的是训练中已知序列各位置的计算;自回归生成跨 token 的先后依赖依然存在。 推理服务可以通过批处理、KV Cache 等方法提高效率,但不会把未知的整段答案一次性预测出来。
# 自注意力有没有短板?
有。对长度为 的序列,标准全量自注意力要考虑位置两两之间的关系,注意力分数矩阵有 个元素。序列变长时,相关计算和存储压力会迅速增大。实际实现可以通过更高效的内核、分块计算或其他注意力设计改善开销,但长上下文不是免费的。
另外,自注意力本身只处理位置间的内容关系,模型还需要位置信息来区分顺序。否则“我打你”和“你打我”无法仅凭同一组 token 判断谁先谁后。这也是位置编码存在的原因。
所以别把架构选型说成“RNN 和 CNN 完全没用”。不同任务对延迟、序列长度、设备资源的要求不同。这里只解释:为什么在大规模语言模型的主流训练方式下,Transformer 成了更常见的底座。
# 面试官继续追问,怎么答?
问:Transformer 能直接看远处,是不是就一定擅长长文本?
不是。“存在直接连接”只说明信息有机会在一层内交互,不保证模型学会找对信息,也不保证上下文无限长。长序列还会增加注意力计算和存储成本。
问:CNN 不能建模长距离依赖吗?
能。叠层、空洞卷积、扩大卷积核都可以扩大感受野。这里比较的是普通卷积和全量自注意力的默认信息路径,不能把工程上的取舍说成“能”与“不能”。
问:BERT、GPT、T5 为什么都算 Transformer?
它们都使用 Transformer 的核心组件,但组织方式和注意力可见范围不同:BERT 主要使用编码器,GPT 使用带因果掩码的解码器,T5 使用编码器和解码器。名字不同,底层有共同的结构基础。
记住这条判断线就够了:RNN 卡在时间步依赖,CNN 擅长并行但主要从局部向外传播,Transformer 用自注意力缩短信息路径,同时付出长序列成本。 想把这套架构看成具体的数据流,再读Transformer 从输入到输出。
参考论文:
- Attention Is All You Need:https://arxiv.org/abs/1706.03762
- Convolutional Sequence to Sequence Learning:https://arxiv.org/abs/1705.03122
评论
验证登录状态...