# 多模态落地:Token成本暴增怎么办?
上一篇《多模态能做什么?文档解析、图片问答、视频理解》讲了什么时候必须让模型看图片、页面或视频。
但项目上线后,录友很快会碰到另一个问题:Demo里传一张图挺便宜,接上真实用户后,账单和延迟怎么一起涨了?
常见回答是:“把图片压缩一下,换个便宜模型就行。”方向没错,但压缩文件不一定减少视觉Token;换模型也可能让答案变差、重试变多。
多模态降本的关键,是减少模型实际处理的视觉信息和重复调用,同时保住任务需要的证据。
# 简要回答
- 图片会先按模型规则缩放、切块或转成视觉表示,计费通常与处理后的分辨率、细节档位和模型有关,不是简单按图片张数计费。
- 一次用户请求可能包含多页、多图、多帧,还可能经历检索、复核、重试;要看单个业务请求背后实际送进模型多少次、多大输入。
- 先按任务降低分辨率,只把相关页面或区域送进去;只有小字、图表等证据确实需要时,再提高细节。
- 图片字节压缩主要影响上传体积和网络时间;要降视觉Token,通常得减少模型处理的像素、帧数、页面数或重复图像。
- 优化后一起看任务成功率、每个成功任务成本和P95延迟,不能只盯每次调用的Token数。
一句话:多模态成本不是“图片有多大”,而是“模型为这项任务处理了多少视觉信息、处理了几遍”。
# 详细回答
# 为什么一张图片会突然吃掉很多Token?
图片不是以文件字节数直接送进语言模型的。视觉模型会根据自身架构和输入设置,把图片缩放、切成Patch或图块,再转成内部视觉表示。
所以,同一张图在不同模型、不同清晰度档位下,Token数可能不同。高分辨率、密集小字和需要局部细节的任务,通常会让模型处理更多视觉信息。具体规则要看模型文档,不能用“每张图固定多少Token”估算整个系统。
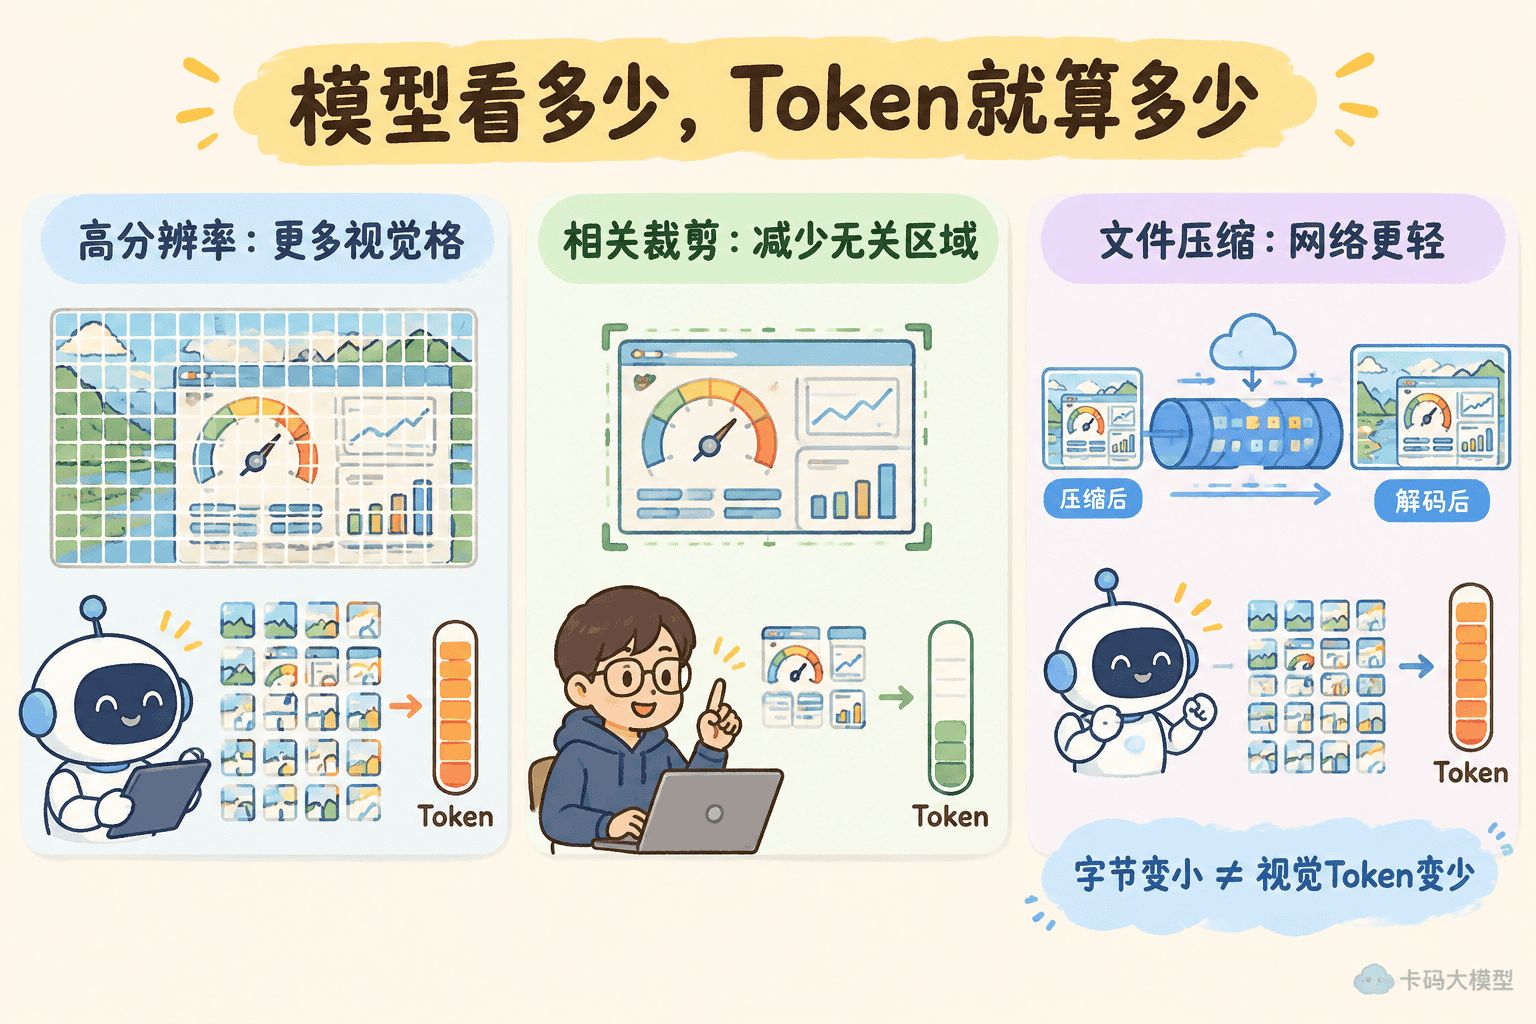
这张图回答的是:模型处理的视觉区域越多,视觉Token通常越多;压缩文件主要减轻传输,裁掉无关区域才可能减少模型要看的内容。
例如 OpenAI 的视觉输入规则会按模型和细节档位计算图像Patch或图块;Anthropic 文档也说明高分辨率视觉输入可能增加Token。Gemini则提供媒体分辨率档位,不同档位对应不同的近似Token数。本文按 2026-10-08 查询到的官方文档举例,接口规则会随模型版本变化;可对照各家的OpenAI图像成本说明 (opens new window)、Claude视觉文档 (opens new window)和Gemini媒体分辨率说明 (opens new window)。
这里还有个容易忽略的区别:**压缩图片文件大小,不等于减少模型看到的视觉Token。**把一张 4000×3000 的 JPEG 压到更小的KB数,但保留原始宽高,上传会更快,模型侧是否少算Token要看它后续的缩放和切块规则。要降低视觉Token,通常要调整实际送入的尺寸、细节档位或图像区域。
# 账单是怎么被多模态链路放大的?
不要只看“用户传了一张图”。真实请求经常是这样的:
用户问题
→ 检索出多页文档
→ 每页都送视觉模型
→ 低置信度时再裁剪、复核
→ 超时重试或交给更强模型
2
3
4
5
要是一个问题召回 8 页,每页又处理整页和两个裁剪区,光视觉输入就可能被重复扩成 24 份。视频也类似:抽帧越密,送进去的画面越多;Agent每走一步都带上旧图片,历史输入还会继续累积。
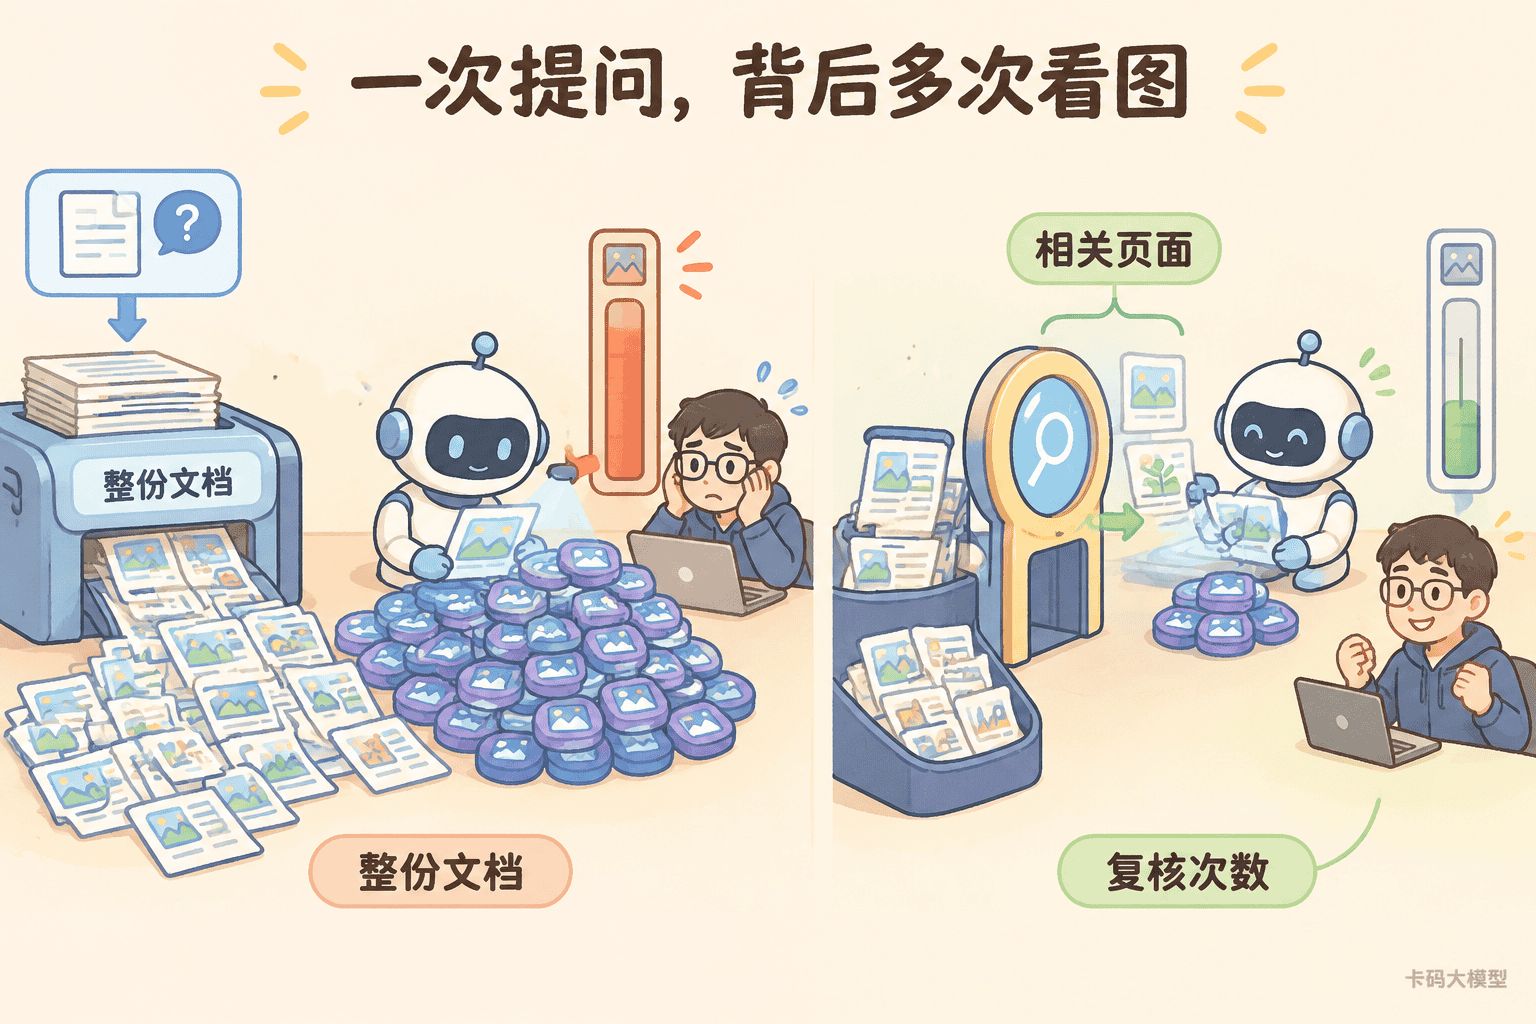
这张图回答的是:一个用户问题会在幕后扩展成多页图片、裁剪和复核调用;先检索出少量相关页面,能减少后续模型实际处理的图像数量。
可以先用这个简化公式估算趋势:
单请求视觉成本
≈ 图片/页面/帧数量 × 单份视觉输入Token × 模型输入单价
  + 文本输入与输出成本
  + 复核、重试和后续步骤成本
2
3
4
视频还可以把帧数拆开看:
单段视频输入量 ≈ 抽取帧数 × 每帧视觉Token + 音频Token + 提示词Token
这只是建立预算的近似式。不同模型的分辨率规则、音视频编码和计费项不一样,线上应优先记录接口返回的 usage,再结合供应商文档换算账单。Google的接口也提供多模态输入的Token统计方式,见Token统计文档 (opens new window)。
如果用户任务成功率是 80%,那么每个成功任务的成本还要把失败请求、重试和人工兜底算进去。只压低单次调用成本,却把成功率压低,最后未必省钱。
# 第一刀:按任务选择清晰度,不要默认最高分辨率
不是所有任务都需要看清每个像素。先问任务依赖什么证据:
| 任务 | 输入策略 | 需要保住的证据 |
|---|---|---|
| 判断照片里有没有安全帽 | 低/中分辨率先筛选 | 人和安全帽的大致形状 |
| 读取小号表格、票据字段 | 提高分辨率或只裁关键区域 | 字符和表格结构 |
| 理解整页合同的主要主题 | OCR/版面文本先筛,再看相关页 | 条款文本与页面结构 |
| 判断视频中动作先后 | 稀疏抽帧定位,再对事件片段加密 | 关键动作前后的时间关系 |
先用低成本设置跑一批有代表性的样本。如果任务质量够用,就保持;如果错误集中在小字、细节或空间关系,再只对这些请求升级清晰度。分辨率档位是质量旋钮,不是越高越专业。
# 第二刀:先找到相关页面和区域,再把它们交给模型
长文档不要每次把整份PDF逐页喂给视觉模型。先用文本检索、OCR或页面摘要找出候选页,再让模型检查少数相关页面。
图片问答也可以先判断问题类型。问“有没有戴安全帽”时,模型可能不需要接收整张高分辨率照片;问“图表中第三季度的数值是多少”时,先定位图表再裁出相关区域更合适。
但裁剪不是免费魔法:裁得太多、重叠太多,或者每个裁剪区都额外调用模型,Token会反而上升。裁剪必须减少无关区域,并把必要上下文保留下来,例如表格标题、行列标签和相邻对象。
这是上一篇《多模态大模型:图片和语音是怎么被模型“看懂”的?》里视觉切块原理的工程延伸:输入缩小了,视觉编码器要处理的内容通常也会减少;但缩得过头,关键信息也会一起消失。
# 第三刀:用分级处理代替每次都调用最贵链路
可以把一次重型调用拆成“筛选—精读”两步:
- 便宜步骤先筛选:用低分辨率视觉输入、OCR、规则或小模型判断是否存在相关内容;
- 只升级疑难样本:低置信度、字段冲突或任务确实依赖细节时,再做高分辨率裁剪或调用更强模型;
- 留下升级理由:记录哪些信号触发了复核,后续按质量和成本决定阈值。
比如发票录入先用OCR和字段规则抽取。只有金额、税号模糊或字段关系不一致时,才把原图相关区域交给视觉模型复核。
这套做法的目标不是把所有输入都压到最低,而是让高成本步骤只处理“确实需要它”的请求。阈值需要用真实样本校准,否则漏掉低置信度异常会降低准确率。
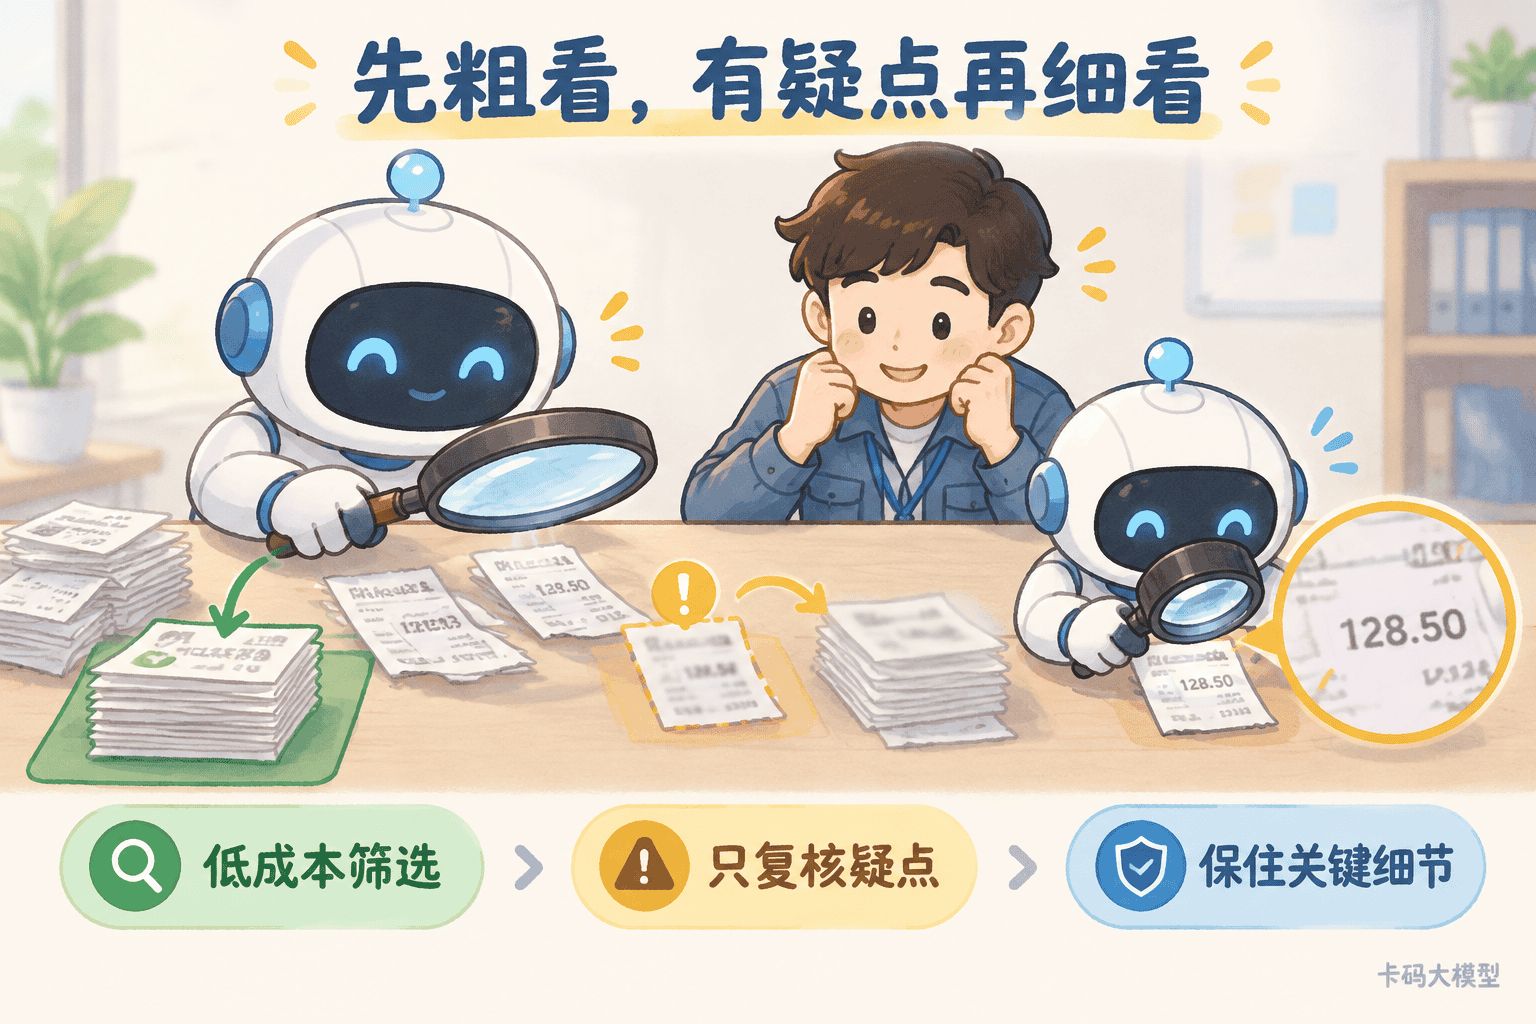
这张图回答的是:先用低成本输入筛选清楚样本,只把低置信度区域升级到高分辨率复核,既省掉普遍的高成本,也保留关键细节。
# 什么时候可以用文字描述替代原图?
如果后续任务只需要稳定的语义摘要,比如“这张图是一个室内会议场景,约十个人围桌讨论”,可以离线生成描述,检索时只把描述和少量原图证据带入上下文。
但图像描述是有损压缩。它可能漏掉精确数字、空间关系、颜色差异、文字位置或罕见细节。任务需要这些证据时,不能只用摘要回答;应保留原图、OCR结果或可回溯的裁剪区域。
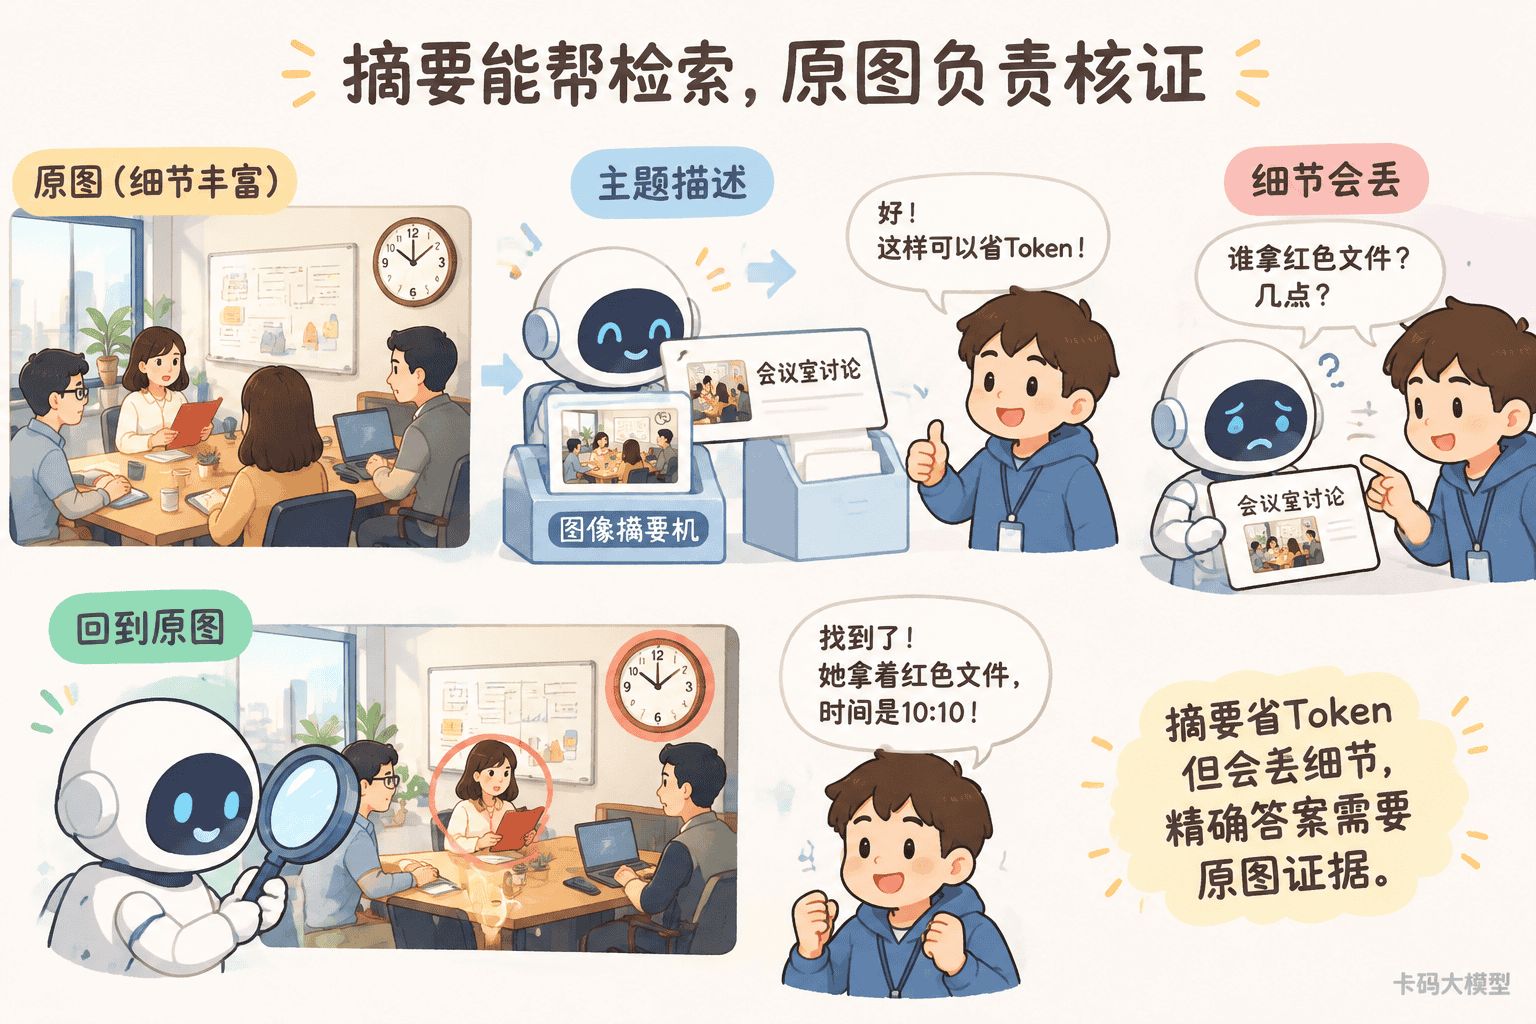
这张图回答的是:摘要卡可以便宜地帮忙找到候选图片,但数字、位置等细节可能在摘要中丢失;遇到精确问题,系统要回到原图核验。
| 下游任务 | 描述能否替代原图 | 原因 |
|---|---|---|
| 按场景主题检索图片 | 通常可以先用描述召回 | 语义大意足够筛选 |
| 读取图表具体数值 | 不可以单独替代 | 数值和坐标是关键证据 |
| 搜索商品大类 | 可以先用描述过滤 | 类别和大致属性通常足够 |
| 判断两个人谁拿着红色文件 | 不能只用普通摘要 | 需要空间关系和颜色细节 |
稳妥的做法是把描述用于召回或预筛选,最终答案仍回到原始证据验证。
# 怎么查清成本到底在哪一步暴增?
把指标从“每次模型调用”提升到“每个业务请求”,并按模态、模型、任务类型拆分:
- 请求规模:每请求图片数、页面数、视频帧数、音频时长、像素尺寸和细节档位;
- 链路放大:模型调用次数、裁剪数量、复核次数、重试次数和实际传入的历史图像数;
- 资源账单:输入视觉Token、文本Token、输出Token、各模型费用;
- 用户体验:端到端P50/P95延迟、任务成功率、人工兜底率;
- 优化结果:每个成功任务成本、质量变化、延迟变化。
重点看长尾请求。平均每个请求只传两张图,不代表没有少量请求一次塞了 80 页PDF或几十秒视频。P95/P99和成本分位数经常比平均值更早暴露问题。
优化时每次只改一类变量:分辨率、页面召回数、视频采样率、调用次数或模型档位。然后用同一批样本比较任务质量、每个成功任务成本和P95延迟,确认省下来的Token没有把错误转嫁给用户。
# 知识拓展
Q1:图片压成WebP,Token就一定少吗?
不一定。文件更小会减少上传数据量,可能改善网络耗时;模型如何缩放、切块和计量,取决于具体接口。要验证视觉Token是否下降,应看模型返回的用量,而不是只看文件KB。
Q2:裁剪图片一定比缩小整图省吗?
不一定。只发送一个相关区域通常能去掉背景和无关内容;如果裁出很多区域、重复发送原图,或裁剪后又补多轮复核,总量可能更高。要统计一条完整链路的调用与Token。
Q3:视频是不是抽帧越少越省?
账单大概率会下降,但事件也可能被漏掉。静态场景可以稀疏采样;动作顺序、短暂异常和小目标需要更密的片段。用事件召回率和时间定位误差共同找采样率。
Q4:把图片先转成描述,为什么还留原图?
描述适合低成本检索和主题筛选,但它会丢掉细节。保留原图或证据区域,才能在需要精确值、位置或审计时回查。
Q5:多模态降本面试时怎么回答?
先说成本驱动项:视觉分辨率、页/帧数量和链路重复调用;再说策略:按任务调清晰度、先检索后精读、低成本筛选后升级;最后说明验证口径:任务成功率、每个成功任务成本和P95延迟一起看。
别把“压缩图片”当成完整的降本方案。
先搞清模型实际处理了什么,再减少无关视觉信息和重复步骤,质量才能和成本一起守住。
评论
验证登录状态...