# dataclass、namedtuple和普通类有什么区别?
面试官问:"Python中dataclass、namedtuple和普通类有什么区别?"
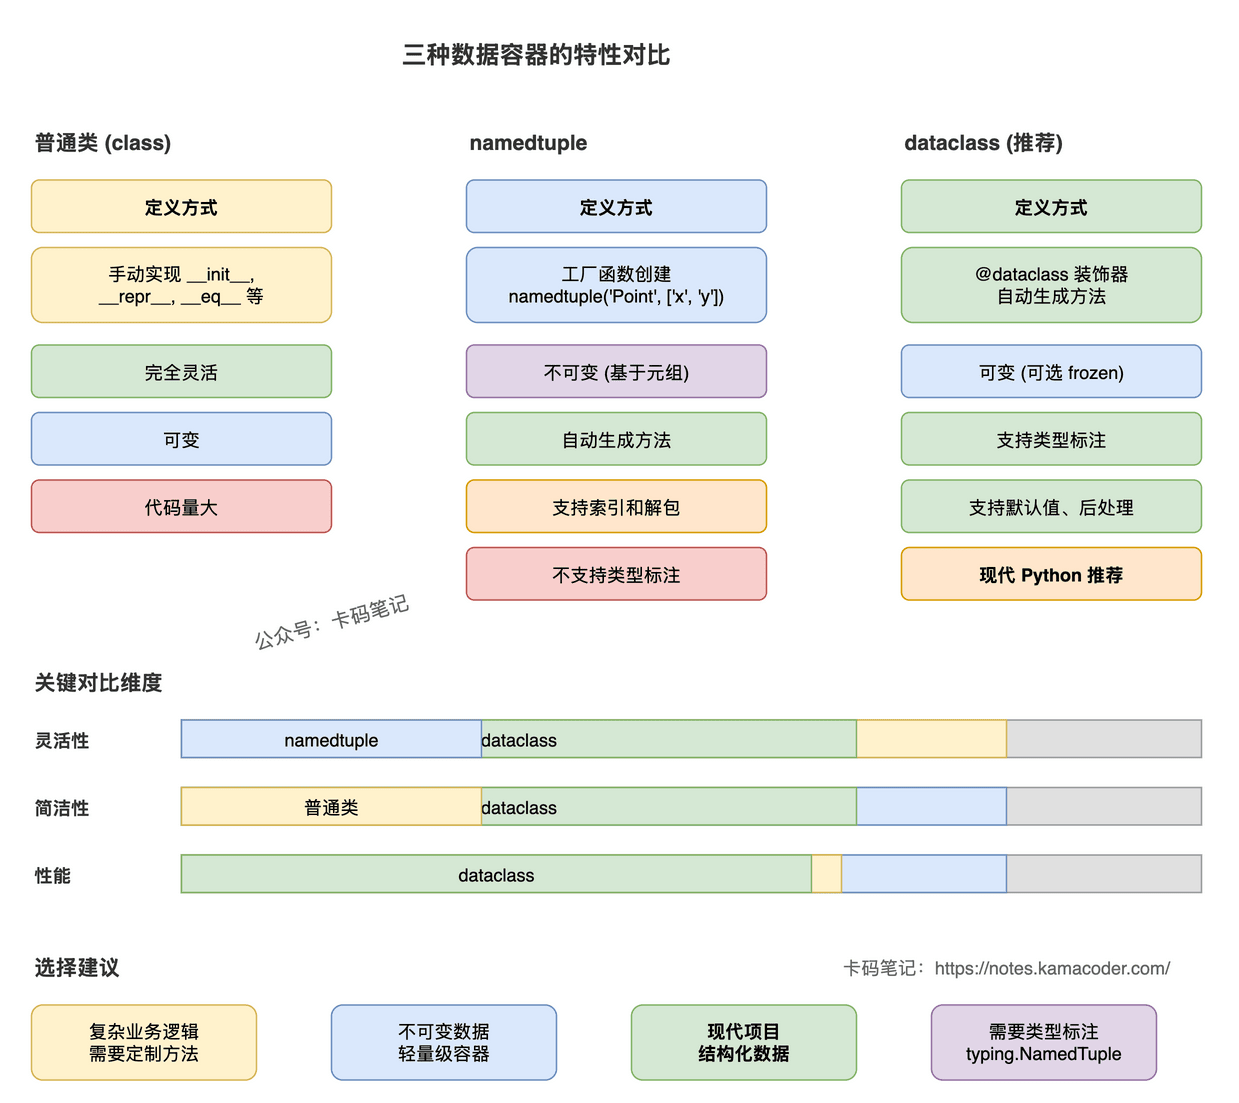
很多人会答"dataclass是简化的类",但这只是表面现象。真正要讲清楚的是:dataclass通过装饰器自动生成__init__、__repr__等方法,适合可变数据容器;namedtuple创建不可变的轻量级数据结构,支持索引和解包;普通类最灵活但需要手动实现所有方法。
# 简要回答
普通类:完全手动,需要自己写__init__、__repr__、__eq__等方法,最灵活但代码量大。
namedtuple:工厂函数创建不可变元组子类,自动提供字段访问、索引、解包、_asdict()等方法,适合简单的不可变数据。
dataclass(Python 3.7+):装饰器自动生成常用方法,支持可变和不可变(frozen),类型标注,默认值,后处理等,适合结构化数据容器。
核心区别:
| 特性 | 普通类 | namedtuple | dataclass |
|---|---|---|---|
| 定义方式 | class | 工厂函数 | @dataclass装饰器 |
| 可变性 | 可变 | 不可变 | 可变(可frozen) |
| 自动生成方法 | 无 | 有 | 有 |
| 类型标注 | 可选 | 不支持 | 支持 |
| 继承 | 支持 | 支持但受限 | 支持 |
| 性能 | 中等 | 最快(元组) | 略慢于普通类 |
# 详细回答
# 普通类的写法
手动实现所有方法:
class Point:
    def __init__(self, x, y):
        self.x = x
        self.y = y

    def __repr__(self):
        return f"Point(x={self.x}, y={self.y})"

    def __eq__(self, other):
        if not isinstance(other, Point):
            return False
        return self.x == other.x and self.y == other.y

p1 = Point(1, 2)
p2 = Point(1, 2)
print(p1)           # Point(x=1, y=2)
print(p1 == p2)     # True
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
代码量大,容易遗漏方法,修改字段需要同步更新多处。
# namedtuple的特点
使用工厂函数创建:
from collections import namedtuple

Point = namedtuple('Point', ['x', 'y'])

p1 = Point(1, 2)
print(p1.x, p1.y)   # 1 2
print(p1[0], p1[1]) # 1 2 (支持索引)
print(p1)           # Point(x=1, y=2)

# 不可变
# p1.x = 10  # AttributeError

# 解包
x, y = p1
print(x, y)  # 1 2

# 转字典
print(p1._asdict())  # {'x': 1, 'y': 2}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
优点:语法简洁,自动生成方法,不可变保证安全,内存效率高。
缺点:不支持类型标注,不能添加方法(需要继承),不可变限制了使用场景。
# dataclass的特点
使用装饰器:
from dataclasses import dataclass

@dataclass
class Point:
    x: int
    y: int

p1 = Point(1, 2)
p2 = Point(1, 2)
print(p1)           # Point(x=1, y=2)
print(p1 == p2)     # True

# 可变
p1.x = 10
print(p1)           # Point(x=10, y=2)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
@dataclass自动生成:
__init__()__repr__()__eq__()- 可选
__hash__(frozen时) - 可选
__lt__等比较方法
# dataclass的高级功能
默认值和工厂函数:
from dataclasses import dataclass, field

@dataclass
class User:
    name: str
    age: int = 18
    scores: list = field(default_factory=list)  # 避免可变默认参数陷阱

user = User("Python")
print(user)  # User(name='Python', age=18, scores=[])
2
3
4
5
6
7
8
9
10
field(default_factory=list)每次创建实例时调用工厂函数生成新列表。
不可变dataclass:
@dataclass(frozen=True)
class Point:
    x: int
    y: int

p = Point(1, 2)
# p.x = 10  # FrozenInstanceError
2
3
4
5
6
7
frozen=True让dataclass变为不可变,可以作为字典键。
后处理:
@dataclass
class Rectangle:
    width: int
    height: int
    area: int = field(init=False)  # 不在__init__中

    def __post_init__(self):
        self.area = self.width * self.height

rect = Rectangle(10, 5)
print(rect.area)  # 50
2
3
4
5
6
7
8
9
10
11
__post_init__()在__init__()之后自动调用,用于计算派生字段。
排序支持:
@dataclass(order=True)
class Student:
    name: str
    score: int

students = [Student("Bob", 85), Student("Alice", 90)]
students.sort()
print(students)  # [Student(name='Bob', score=85), Student(name='Alice', score=90)]
2
3
4
5
6
7
8
order=True自动生成__lt__、__le__等比较方法,按字段顺序比较。
# 性能对比
内存占用和访问速度:
import sys
from collections import namedtuple
from dataclasses import dataclass

Point1 = namedtuple('Point1', ['x', 'y'])

@dataclass
class Point2:
    x: int
    y: int

class Point3:
    def __init__(self, x, y):
        self.x = x
        self.y = y

p1 = Point1(1, 2)
p2 = Point2(1, 2)
p3 = Point3(1, 2)

print(sys.getsizeof(p1))  # 约56字节 (元组)
print(sys.getsizeof(p2.__dict__))  # 约104字节 (字典)
print(sys.getsizeof(p3.__dict__))  # 约104字节 (字典)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
namedtuple内存最小,因为基于元组,不需要__dict__。
dataclass和普通类使用字典存储属性,内存占用相似。
# 继承和扩展
namedtuple继承:
from collections import namedtuple

Point = namedtuple('Point', ['x', 'y'])

class Point3D(Point):
    def __new__(cls, x, y, z):
        obj = super().__new__(cls, x, y)
        obj.z = z  # 实际不推荐,会失去不可变性
        return obj
2
3
4
5
6
7
8
9
namedtuple继承比较复杂,通常不推荐。
dataclass继承:
@dataclass
class Point:
    x: int
    y: int

@dataclass
class Point3D(Point):
    z: int

p = Point3D(1, 2, 3)
print(p)  # Point3D(x=1, y=2, z=3)
2
3
4
5
6
7
8
9
10
11
dataclass继承自然,子类自动包含父类字段。
# 知识拓展
Q1: 什么时候用namedtuple,什么时候用dataclass?
用namedtuple:
- 数据不可变,需要作为字典键或集合元素。
- 需要轻量级数据结构,内存敏感。
- 需要元组的特性(索引、解包)。
- Python 3.6及以下版本。
用dataclass:
- 数据需要修改。
- 需要类型标注,提高可读性和工具支持。
- 需要默认值、后处理等高级功能。
- 需要继承和扩展。
- Python 3.7+的现代项目。
Q2: dataclass和attrs库有什么关系?
attrs是第三方库,提供类似dataclass的功能,但功能更强大。dataclass借鉴了attrs的设计,成为标准库的一部分。attrs支持更多功能(验证、转换、钩子),但需要额外安装。标准库项目优先用dataclass,复杂需求考虑attrs。
Q3: 为什么namedtuple不支持类型标注?
namedtuple设计早于类型标注(Python 3.5),使用工厂函数而非类定义。Python 3.6+引入了typing.NamedTuple支持类型标注:
from typing import NamedTuple

class Point(NamedTuple):
    x: int
    y: int

p = Point(1, 2)
2
3
4
5
6
7
这是推荐的现代写法,结合了namedtuple和类型标注。
Q4: dataclass的性能开销在哪里?
@dataclass装饰器在类定义时(不是实例化时)生成方法,开销发生在导入模块时。实例化和方法调用的性能与手写类相当,略慢于namedtuple(因为namedtuple基于C实现的元组)。
Q5: 可以混用dataclass和自定义方法吗?
可以。dataclass只生成缺失的方法,自定义的方法不会被覆盖:
@dataclass
class Point:
    x: int
    y: int

    def distance(self):
        return (self.x ** 2 + self.y ** 2) ** 0.5

    def __repr__(self):
        return f"<Point {self.x}, {self.y}>"  # 覆盖自动生成的

p = Point(3, 4)
print(p.distance())  # 5.0
print(p)  # <Point 3, 4>
2
3
4
5
6
7
8
9
10
11
12
13
14
这让dataclass兼具简洁和灵活。
评论
验证登录状态...