# 可迭代对象和迭代器有什么区别?
面试官问:"Python中的可迭代对象和迭代器有什么区别?"
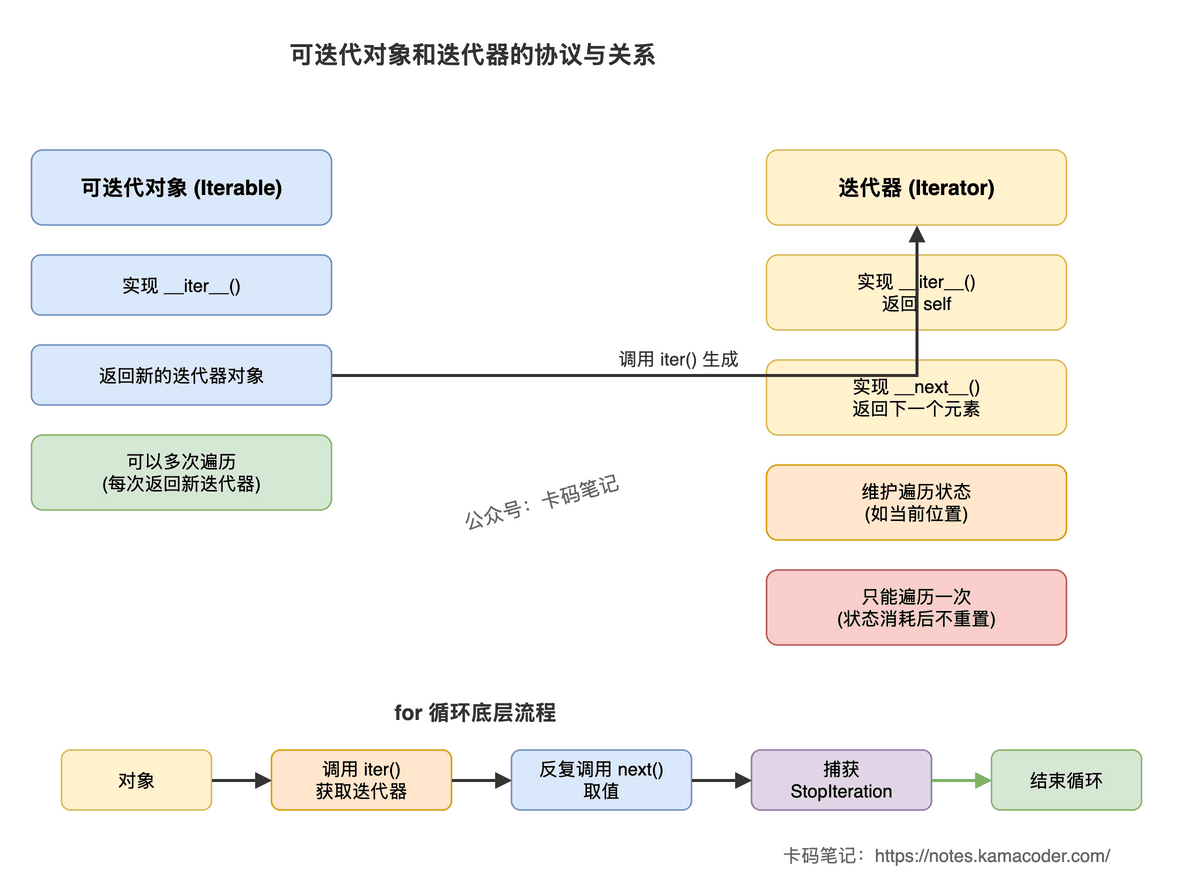
很多人会答"能遍历的就是可迭代对象",但这个说法不够准确。真正要讲清楚的是:可迭代对象可以返回迭代器,迭代器负责实际遍历并保存状态。二者分工不同,混淆它们会导致"为什么迭代器只能遍历一次"这类疑惑。
# 简要回答
可迭代对象(Iterable) 是实现了__iter__()方法的对象,每次调用__iter__()会返回一个新的迭代器。列表、元组、字符串、字典、集合都是可迭代对象。
迭代器(Iterator) 是同时实现了__iter__()和__next__()方法的对象。__iter__()返回自己,__next__()负责返回下一个元素,没有元素时抛出StopIteration异常。
核心区别是状态保持:迭代器内部维护遍历状态,消耗后不会重置;可迭代对象本身不保存遍历状态,每次调用__iter__()都能拿到一个新的迭代器。
for循环的底层过程是:先对可迭代对象调用iter()获取迭代器,然后反复调用next()取值,直到捕获StopIteration。
# 详细回答
# 可迭代对象只负责生产迭代器
一个对象只要实现了__iter__()方法,就是可迭代对象。这个方法应该返回一个迭代器:
class Course:
    def __init__(self, names):
        self.names = names

    def __iter__(self):
        return iter(self.names)  # 返回列表的迭代器

course = Course(["Python", "Java", "Go"])
for name in course:
    print(name)
# 输出: Python Java Go
2
3
4
5
6
7
8
9
10
11
Course对象是可迭代对象,每次for循环会调用__iter__()拿到一个新迭代器。
# 迭代器同时负责状态和取值
迭代器必须同时实现__iter__()和__next__():
class CourseIterator:
    def __init__(self, names):
        self.names = names
        self.index = 0  # 维护当前位置

    def __iter__(self):
        return self  # 返回自己

    def __next__(self):
        if self.index >= len(self.names):
            raise StopIteration
        value = self.names[self.index]
        self.index += 1
        return value

it = CourseIterator(["Python", "Java"])
print(next(it))  # Python
print(next(it))  # Java
print(next(it))  # StopIteration
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
CourseIterator是迭代器,内部用self.index保存遍历位置。一旦消耗完,self.index不会自动重置,所以无法再次遍历。
# for循环如何工作
for循环的底层逻辑等价于:
courses = ["Python", "Java"]
iterator = iter(courses)  # 调用 __iter__()
while True:
    try:
        item = next(iterator)  # 调用 __next__()
        print(item)
    except StopIteration:
        break
2
3
4
5
6
7
8
iter()和next()是内置函数,分别调用对象的__iter__()和__next__()方法。
# 可以多次遍历 vs 只能遍历一次
可迭代对象可以多次遍历,因为每次调用__iter__()都会返回新的迭代器:
courses = ["Python", "Java"]
for name in courses:
    print(name)
# 可以再次遍历
for name in courses:
    print(name)  # 仍然能输出
2
3
4
5
6
迭代器只能遍历一次,因为状态消耗后不会自动恢复:
courses = ["Python", "Java"]
it = iter(courses)
for name in it:
    print(name)
# 再次遍历
for name in it:
    print(name)  # 不会输出任何内容
2
3
4
5
6
7
第二次for循环时,it的内部状态已经指向末尾,直接抛出StopIteration。
# 迭代器本身也是可迭代对象
迭代器实现了__iter__()返回自己,所以迭代器本身也是可迭代对象:
courses = ["Python", "Java"]
it = iter(courses)
print(iter(it) is it)  # True
2
3
这就是为什么迭代器也可以直接用在for循环中。但这不意味着可以多次遍历,因为状态不会重置。
# 知识拓展
Q1: 列表、字符串是可迭代对象还是迭代器?
列表、字符串、元组、字典、集合都是可迭代对象,但不是迭代器。它们实现了__iter__()返回迭代器,但没有__next__()方法:
courses = ["Python"]
print(hasattr(courses, "__iter__"))  # True
print(hasattr(courses, "__next__"))  # False
2
3
Q2: 如何判断一个对象是可迭代对象还是迭代器?
使用collections.abc模块的抽象基类:
from collections.abc import Iterable, Iterator

courses = ["Python"]
it = iter(courses)

print(isinstance(courses, Iterable))  # True
print(isinstance(courses, Iterator))  # False
print(isinstance(it, Iterable))      # True
print(isinstance(it, Iterator))      # True
2
3
4
5
6
7
8
9
所有迭代器都是可迭代对象,但可迭代对象不一定是迭代器。
Q3: 为什么要区分可迭代对象和迭代器?
分离职责。可迭代对象只负责数据存储和迭代器工厂,不保存遍历状态;迭代器只负责遍历和状态管理。这样设计让可迭代对象可以被多次独立遍历,同时也允许手动控制迭代器的遍历过程。
Q4: 文件对象是可迭代对象还是迭代器?
文件对象既是可迭代对象也是迭代器。它实现了__iter__()返回自己,也实现了__next__()逐行读取。因此文件只能遍历一次:
f = open("data.txt")
for line in f:
    print(line)
# 再次遍历不会输出任何内容
for line in f:
    print(line)
2
3
4
5
6
Q5: 自定义迭代器时,为什么__iter__()要返回self?
这是迭代器协议的约定。返回self是为了让迭代器本身也可以用在for循环中。如果不返回自己,for循环无法正常工作。
评论
验证登录状态...