# Python如何管理内存?引用计数和垃圾回收是什么?
面试官问:"Python如何管理内存?引用计数和垃圾回收是什么?"
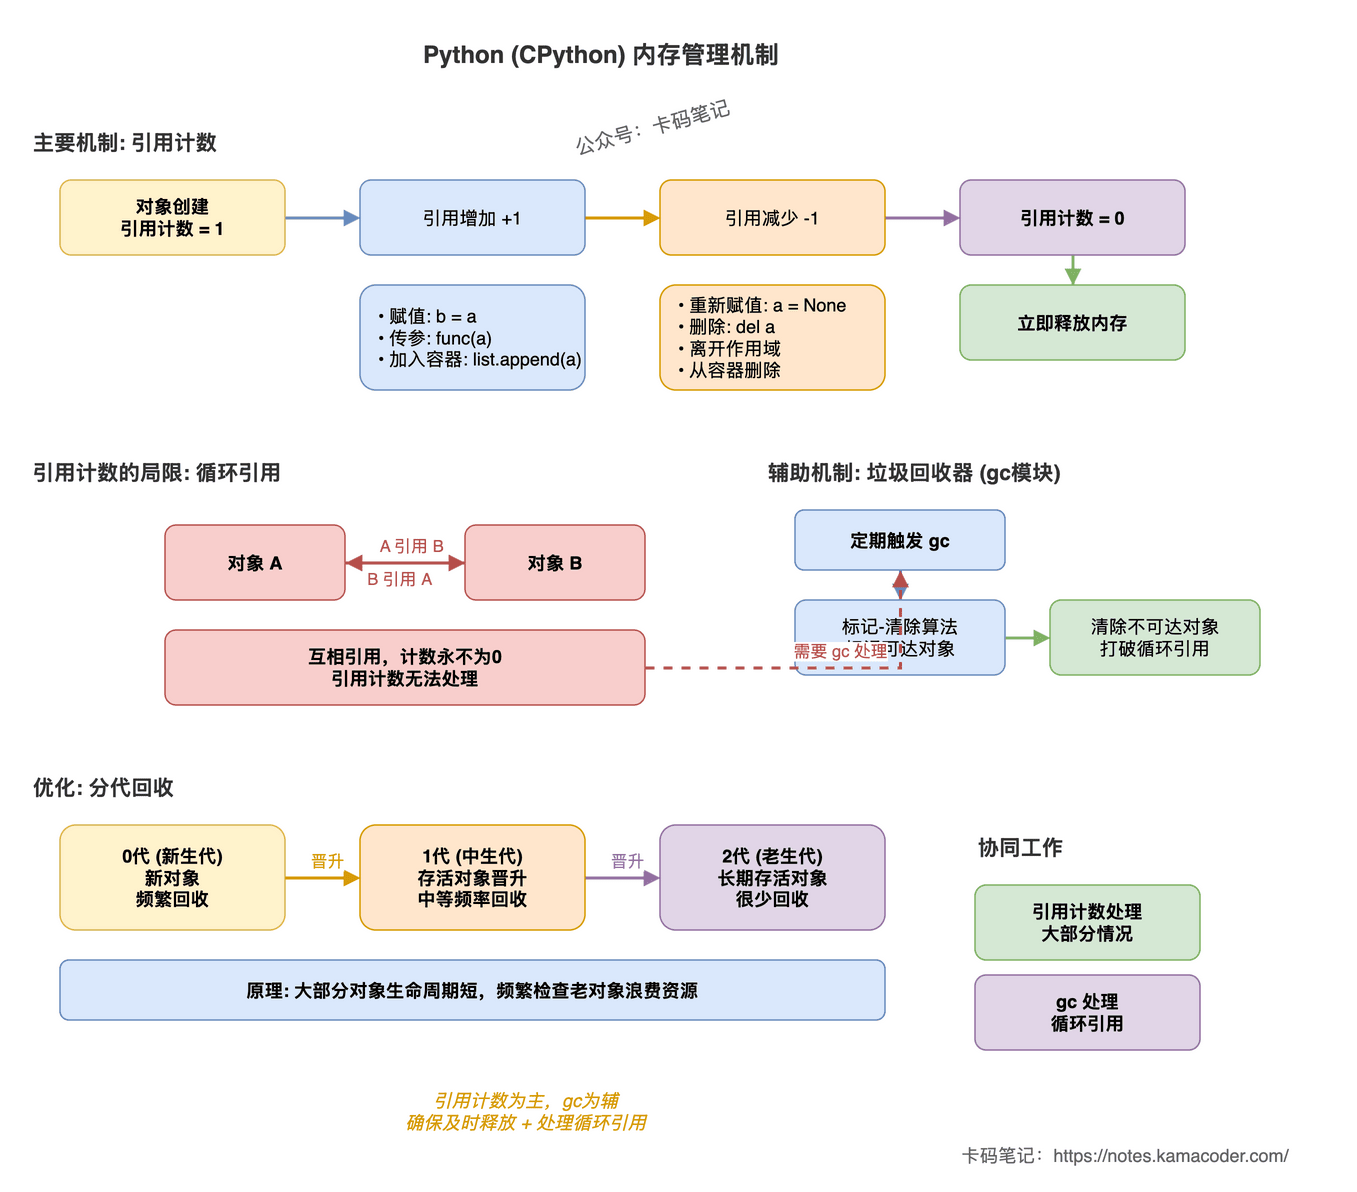
很多人会答"Python有自动垃圾回收",但这只是笼统说法。真正要讲清楚的是:Python主要使用引用计数管理内存,引用计数为0时立即释放;垃圾回收器(gc模块)用标记-清除和分代回收处理引用计数无法解决的循环引用问题。
# 简要回答
Python内存管理在CPython中采用引用计数为主,垃圾回收为辅的机制。
引用计数(Reference Counting):
- 每个对象维护一个引用计数器,记录有多少引用指向它。
- 引用增加:赋值、传参、加入容器时计数+1。
- 引用减少:变量重新赋值、离开作用域、从容器删除时计数-1。
- 计数为0时,对象立即释放。
优点:释放及时,内存回收确定性强。
缺点:无法处理循环引用(两个对象互相引用,计数永远不为0)。
垃圾回收器(gc模块):
- 使用标记-清除(Mark-Sweep) 算法检测循环引用。
- 采用分代回收(Generational GC) 优化:对象分为0代、1代、2代,新对象在0代,存活久的晋升,老对象检查频率低。
- 定期或内存压力大时触发,找出循环引用并打破,释放内存。
协同工作:引用计数处理绝大多数情况,垃圾回收器处理循环引用这种特殊情况。
# 详细回答
# 引用计数的工作原理
每个对象有一个ob_refcnt字段记录引用数:
import sys

a = []
print(sys.getrefcount(a))  # 2 (a本身 + getrefcount的参数)

b = a  # 引用+1
print(sys.getrefcount(a))  # 3

del b  # 引用-1
print(sys.getrefcount(a))  # 2
2
3
4
5
6
7
8
9
10
注意:sys.getrefcount()会临时增加一次引用(参数传递),所以结果比实际多1。
引用计数增加的场景:
obj = []          # 创建,计数=1
other = obj       # 赋值,计数=2
container = [obj] # 加入容器,计数=3
func(obj)         # 传参(参数期间),计数临时+1
2
3
4
引用计数减少的场景:
obj = None        # 重新赋值,原对象计数-1
del obj           # 删除名字,计数-1
container.clear() # 从容器删除,计数-1
# 离开作用域,局部变量自动删除,计数-1
2
3
4
# 循环引用问题
引用计数无法处理循环引用:
class Node:
    def __init__(self):
        self.ref = None

a = Node()
b = Node()
a.ref = b  # a引用b
b.ref = a  # b引用a

# 删除外部引用
del a
del b

# a和b互相引用,计数都是1,无法释放
# 这时需要垃圾回收器介入
2
3
4
5
6
7
8
9
10
11
12
13
14
15
两个对象互相引用,即使外部没有引用,计数也不为0,形成内存泄漏。
# 垃圾回收器的标记-清除
gc模块使用标记-清除算法检测循环引用:
- 标记阶段:从根对象(全局变量、栈帧等)出发,遍历所有可达对象并标记。
- 清除阶段:未被标记的对象就是不可达对象(垃圾),释放它们的内存。
import gc

class Node:
    def __init__(self, name):
        self.name = name
        self.ref = None

a = Node("A")
b = Node("B")
a.ref = b
b.ref = a

# 查看待回收对象
print(gc.get_count())  # (阈值前各代对象数)

del a
del b

# 手动触发垃圾回收
collected = gc.collect()
print(f"回收了 {collected} 个对象")
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
# 分代回收机制
Python将对象分为三代,优化回收效率:
- 0代(新生代):新创建的对象,回收频率最高。
- 1代(中生代):经历过一次0代回收仍存活的对象。
- 2代(老生代):经历过1代回收仍存活的对象,回收频率最低。
原理:大部分对象生命周期很短(临时变量),少数对象长期存活(全局对象)。频繁检查老对象浪费资源。
import gc

# 查看各代的阈值和对象数
print(gc.get_count())    # (0代计数, 1代计数, 2代计数)
print(gc.get_threshold()) # (700, 10, 10) 默认阈值

# 0代对象数超过700触发0代回收
# 0代回收10次触发1代回收
# 1代回收10次触发2代回收
2
3
4
5
6
7
8
9
回收触发:
- 0代对象数超过阈值(默认700),触发0代回收。
- 0代回收10次,触发1代回收。
- 1代回收10次,触发2代回收。
# 手动控制垃圾回收
import gc

# 禁用自动垃圾回收
gc.disable()

# ... 执行一些操作

# 手动触发垃圾回收
gc.collect()

# 重新启用
gc.enable()

# 查看gc是否启用
print(gc.isenabled())  # True

# 获取所有被gc跟踪的对象
objects = gc.get_objects()
print(len(objects))
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
性能敏感的场景可以禁用gc,在合适时机手动回收。
# 弱引用避免循环引用
使用weakref创建不增加引用计数的引用:
import weakref

class Node:
    def __init__(self, name):
        self.name = name

a = Node("A")
b = weakref.ref(a)  # 弱引用,不增加a的引用计数

print(b())  # <__main__.Node object>
print(b().name)  # A

del a
print(b())  # None (原对象已释放)
2
3
4
5
6
7
8
9
10
11
12
13
14
弱引用常用于缓存、观察者模式等,避免循环引用导致的内存泄漏。
# 常见内存泄漏场景
1. 全局容器不断添加对象:
cache = []

def process(data):
    cache.append(data)  # 对象永远不会释放
2
3
4
2. 循环引用:
class Parent:
    def __init__(self):
        self.child = None

class Child:
    def __init__(self, parent):
        self.parent = parent  # 循环引用
2
3
4
5
6
7
3. 闭包捕获大对象:
def create_func():
    large_data = [0] * 1000000
    def inner():
        return large_data[0]  # 闭包保持large_data引用
    return inner
2
3
4
5
解决方法:
- 及时清理容器,使用有界缓存(如LRU)。
- 用弱引用打破循环。
- 闭包只捕获必要的数据。
# 内存优化技巧
1. 使用__slots__减少内存:
class Point:
    __slots__ = ['x', 'y']  # 不使用__dict__
    def __init__(self, x, y):
        self.x = x
        self.y = y

# 节省约一半内存
2
3
4
5
6
7
2. 生成器代替列表:
# 占用大量内存
data = [x * 2 for x in range(1000000)]

# 惰性求值,占用很少内存
data = (x * 2 for x in range(1000000))
2
3
4
5
3. 及时释放大对象:
large_data = load_large_file()
process(large_data)
del large_data  # 显式删除
gc.collect()    # 可选:立即回收
2
3
4
# 知识拓展
Q1: 为什么CPython使用引用计数而不是纯垃圾回收?
引用计数的优点:
- 释放及时,内存回收确定性强(析构函数立即调用)。
- 实现简单,不需要暂停程序扫描(Stop-The-World)。
- 适合C扩展集成(C代码可以手动控制引用计数)。
缺点是需要额外处理循环引用,但Python用gc模块弥补了这个缺陷。
Q2: 其他Python实现(PyPy、Jython)也用引用计数吗?
不一定。引用计数是CPython的实现选择,不是Python语言规范。PyPy使用纯垃圾回收(标记-清除+分代),Jython依赖JVM的垃圾回收器。不能依赖引用计数的确定性析构来管理资源,应该用上下文管理器(with语句)。
Q3: 如何调试内存泄漏?
使用工具:
tracemalloc标准库:跟踪内存分配。objgraph:可视化对象引用关系,找出循环引用。memory_profiler:按行分析内存使用。gc.get_objects():获取所有对象,分析未释放的对象。
import tracemalloc

tracemalloc.start()
# ... 执行代码
snapshot = tracemalloc.take_snapshot()
top = snapshot.statistics('lineno')
for stat in top[:10]:
    print(stat)
2
3
4
5
6
7
8
Q4: del语句会立即释放内存吗?
del只是删除名字,减少引用计数。如果还有其他引用,对象不会释放。只有引用计数为0时,对象才立即释放(CPython)。
a = [1, 2, 3]
b = a
del a  # 删除名字a,但对象仍被b引用
print(b)  # [1, 2, 3]
2
3
4
Q5: Python的内存不会返还给操作系统吗?
部分是的。CPython使用内存池管理小对象,释放的内存会保留在内存池中供后续分配使用,不一定立即返还给操作系统。大对象(通常>512KB)直接用系统allocator,释放后会返还系统。这是性能优化,避免频繁的系统调用。
评论
验证登录状态...