# 生成器是什么?yield为什么能节省内存?
面试官问:"Python中的生成器是什么?yield为什么能节省内存?"
很多人会答"生成器就是用yield的函数",但这只是表面现象。真正要讲清楚的是:生成器是一种特殊的迭代器,通过yield暂停和恢复函数执行,实现惰性求值,只在需要时才计算下一个值。
# 简要回答
生成器(Generator) 是一种特殊的迭代器,可以通过两种方式创建:
- 生成器函数:包含
yield关键字的函数。调用时不执行函数体,而是返回一个生成器对象。 - 生成器表达式:类似列表推导式,但使用圆括号
()。
yield的工作机制:函数执行到yield时暂停并返回值,保存当前状态;下次调用next()时从暂停位置继续执行,直到遇到下一个yield或函数结束。
为什么节省内存:生成器采用惰性求值,只在需要时计算一个值并立即返回,不会一次性把所有结果存入内存。处理大数据集时,内存占用可以从O(n)降到O(1)。
# 详细回答
# 生成器函数的基本用法
普通函数使用return返回后结束,生成器函数使用yield返回后暂停:
def count_up(n):
    i = 0
    while i < n:
        yield i
        i += 1

gen = count_up(3)
print(next(gen))  # 0
print(next(gen))  # 1
print(next(gen))  # 2
print(next(gen))  # StopIteration
2
3
4
5
6
7
8
9
10
11
调用count_up(3)不会立即执行函数体,而是返回一个生成器对象。每次调用next()时,函数从上次暂停的位置继续执行,直到遇到下一个yield。
# yield如何暂停和恢复
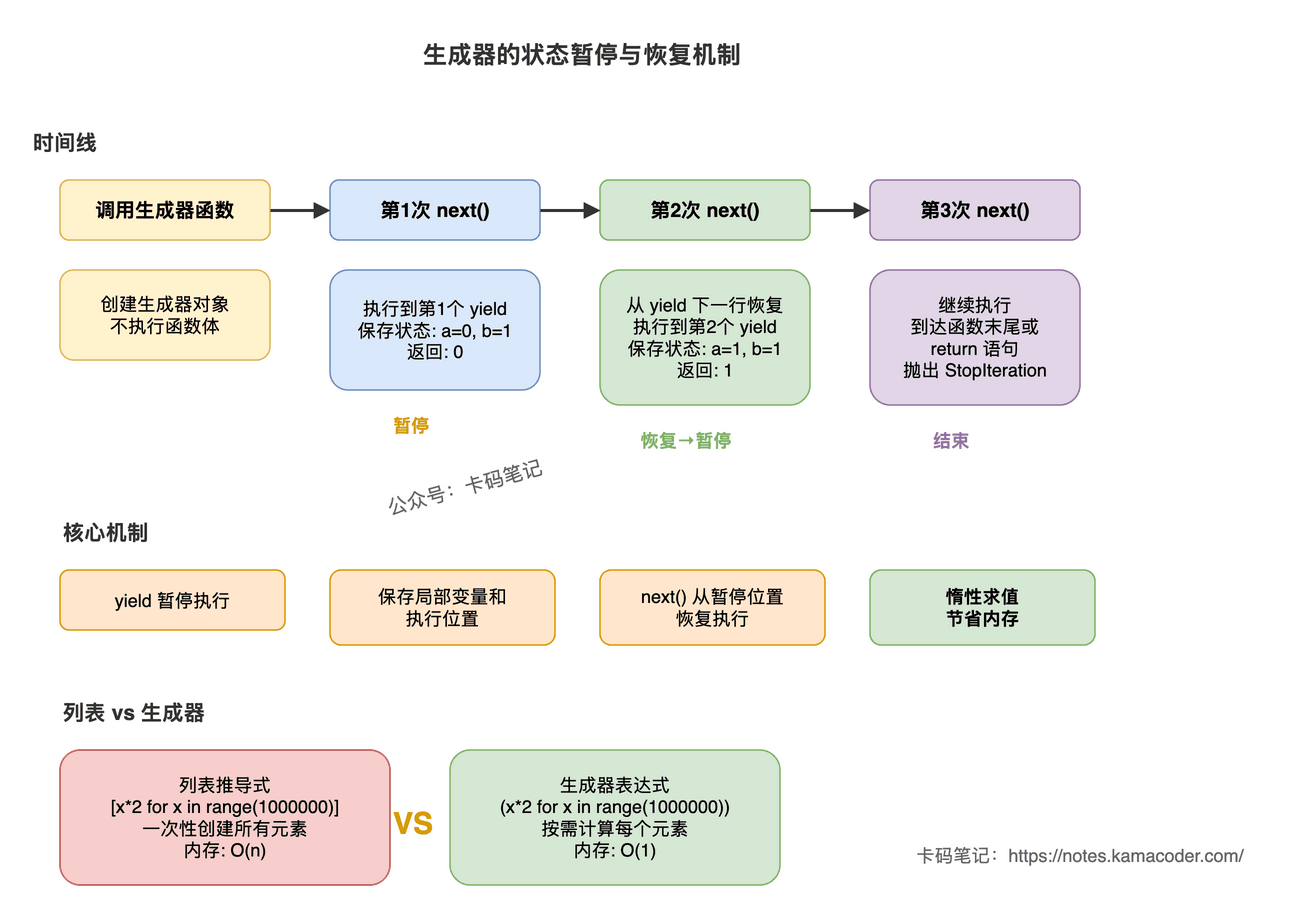
生成器函数的执行状态保存在生成器对象中,包括局部变量、指令指针和调用栈:
def fibonacci(n):
    a, b = 0, 1
    count = 0
    while count < n:
        yield a
        a, b = b, a + b
        count += 1

fib = fibonacci(5)
print(next(fib))  # 0, a=0, b=1保存
print(next(fib))  # 1, a=1, b=1保存
print(next(fib))  # 1, a=1, b=2保存
2
3
4
5
6
7
8
9
10
11
12
每次yield后,变量a、b、count的值都会保存在生成器对象内部。下次调用next()时,从yield的下一行继续执行。
# 惰性求值如何节省内存
对比列表和生成器处理100万个数字:
# 列表推导式: 一次性创建100万个元素
numbers_list = [x * 2 for x in range(1000000)]
# 内存占用约 8MB (每个整数约8字节)

# 生成器表达式: 只保存当前计算状态
numbers_gen = (x * 2 for x in range(1000000))
# 内存占用约 几百字节 (只保存生成器对象和状态)
2
3
4
5
6
7
使用生成器时:
numbers_gen = (x * 2 for x in range(1000000))
for num in numbers_gen:
    print(num)
    if num > 100:
        break  # 只计算了前51个,后面的不会计算
2
3
4
5
生成器只在for循环需要下一个值时才计算一次,计算完立即返回。循环提前结束时,后续的值永远不会被计算。
# 生成器表达式 vs 列表推导式
语法只差一个括号,但行为完全不同:
# 列表推导式: 立即计算所有值
squares_list = [x**2 for x in range(5)]
print(squares_list)  # [0, 1, 4, 9, 16]

# 生成器表达式: 返回生成器对象
squares_gen = (x**2 for x in range(5))
print(squares_gen)   # <generator object>
print(list(squares_gen))  # [0, 1, 4, 9, 16]
2
3
4
5
6
7
8
如果只需要遍历一次,生成器表达式更高效;如果需要多次访问或随机访问,必须使用列表。
# 生成器是一次性的
生成器是迭代器,消耗后不会重置:
gen = (x for x in range(3))
print(list(gen))  # [0, 1, 2]
print(list(gen))  # [] 已经消耗完
2
3
如果需要多次遍历,必须重新创建生成器或改用列表。
# yield from委托子生成器
yield from可以把生成器委托给另一个可迭代对象:
def sub_gen():
    yield 1
    yield 2

def main_gen():
    yield from sub_gen()
    yield 3

gen = main_gen()
print(list(gen))  # [1, 2, 3]
2
3
4
5
6
7
8
9
10
等价于:
def main_gen():
    for value in sub_gen():
        yield value
    yield 3
2
3
4
yield from简化了嵌套生成器的写法,在递归生成器中很常用。
# 知识拓展
Q1: 生成器和迭代器有什么区别?
生成器是迭代器的一种实现方式。迭代器可以通过类实现__iter__()和__next__()方法,也可以通过生成器函数实现。生成器的优势是写法简洁,不需要手动管理状态:
# 迭代器写法
class Counter:
    def __init__(self, n):
        self.n = n
        self.i = 0
    def __iter__(self):
        return self
    def __next__(self):
        if self.i >= self.n:
            raise StopIteration
        self.i += 1
        return self.i

# 生成器写法
def counter(n):
    i = 0
    while i < n:
        i += 1
        yield i
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
Q2: 什么时候应该用生成器?
- 处理大数据集或无限序列(日志流、传感器数据)。
- 只需要遍历一次,不需要随机访问或多次遍历。
- 需要流式处理,边产生边消费(数据管道)。
- 递归或状态机场景,用
yield比用类管理状态更清晰。
Q3: 生成器一定比列表快吗?
不一定。生成器节省内存,但不一定更快:
- 如果需要多次遍历,生成器需要重新计算,列表只需一次计算。
- 如果数据量小,列表的访问速度更快(连续内存,CPU缓存友好)。
- 如果计算逻辑复杂,生成器每次调用都要执行一遍。
生成器的优势是空间,不是时间。
Q4: 为什么生成器函数调用后不立即执行?
如果立即执行,函数会运行到第一个yield或结束,无法实现惰性求值。延迟执行让生成器在需要时才开始计算,这是惰性求值的前提。
Q5: 可以用return结束生成器吗?
可以。return会结束生成器并抛出StopIteration,返回值会作为异常的value属性:
def gen():
    yield 1
    return "done"
    yield 2  # 永远不会执行

g = gen()
print(next(g))  # 1
try:
    next(g)
except StopIteration as e:
    print(e.value)  # done
2
3
4
5
6
7
8
9
10
11
普通for循环会忽略返回值,但在生成器委托(yield from)中可以捕获。
评论
验证登录状态...