# GPT-6 Astra来了,你去年攒的AGENTS.md和Skills可能该删了
前段时间写 GPT-5.6发布后,Superpowers已经没必要学了? 时,我给出的建议是:先让模型直接做,真的做不好,再补一个最小Skill。
现在 OpenAI 又专门发了一篇文章,标题叫《Rethinking skills and prompts for GPT-6 Astra》。
这次说得更直接。
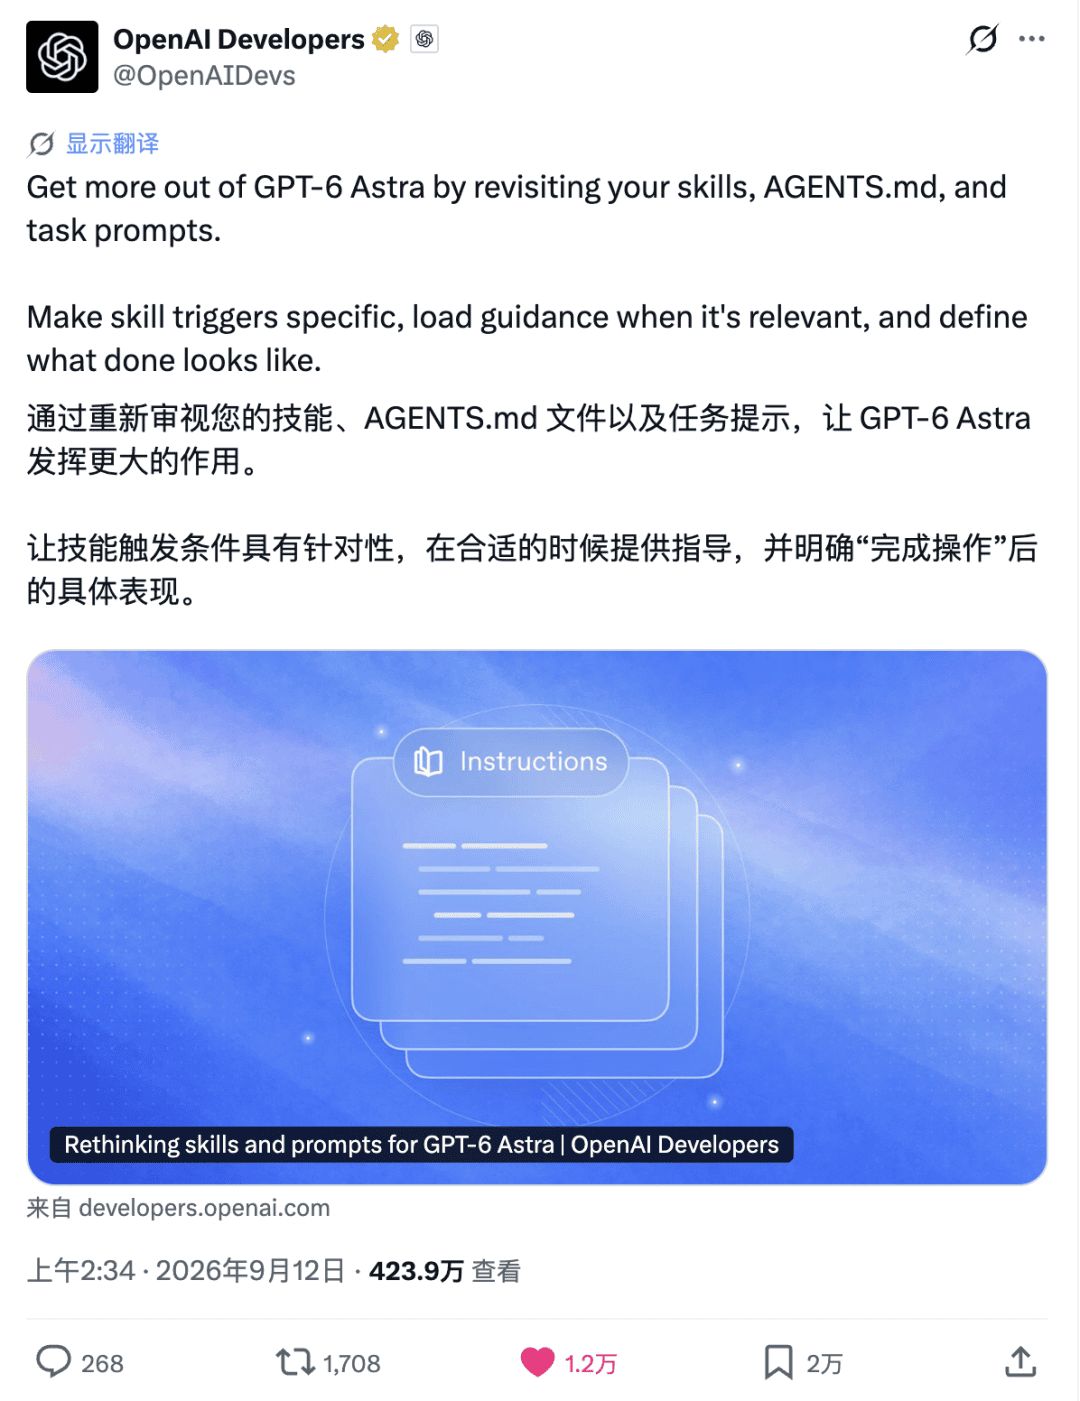
官方提醒开发者:GPT-6 Astra 上线后,应该重新检查项目里的 Skills、AGENTS.md 和任务提示词,避免上下文越堆越肿。
过去一年,我们为了让 Coding Agent 少犯错,写了很多规则:先读什么、再做什么、每一步怎么汇报、什么时候测试、什么情况下必须停下来问。
这些规则当时可能真有用。
但模型已经换代,旧规则不会自动过期,只会继续占上下文、抢注意力,甚至和新模型的原生能力打架。
所以这篇不聊 Astra 的跑分和价格,那些内容可以看 GPT-6 Astra正式发布。
这篇只做一件事:把你过去积累的 AGENTS.md、Skills 和任务提示词,重新检查一遍。
# 不是全删,而是重新分工
很多录友看到“精简提示词”,容易走到另一个极端:模型这么强了,是不是规则都不用写了?
不是。
模型能力变强,减少的是“教模型如何像一个聪明人做事”的说明;项目事实、组织经验和安全边界仍然需要保留。
可以先用这张表判断:
| 指令类型 | 建议 | 原因 |
|---|---|---|
| 项目目录、构建命令、发布约定 | 保留 | 这是模型不可能凭空知道的项目事实 |
| 数据迁移、制品生成、外部系统操作 | 保留 | 需要确定性脚本和真实工具 |
| 删除、付款、上线、权限变更边界 | 保留 | 风险边界不能靠模型猜 |
| “先认真思考”“不要犯错” | 删除 | 太泛,几乎没有可执行信息 |
| 每个任务都强制读完整仓库文档 | 改写 | 小任务也支付了不必要的上下文成本 |
| 每个任务都走同一套十步流程 | 改写或删除 | 容易压住模型自己的判断 |
| 真实失败案例沉淀出的检查项 | 保留并定期复测 | 这是有证据的组织经验 |
一句话:事实留下,边界留下,经过验证的经验留下;重复常识和流程仪式先删。
# 第一轮检查Skill:先看它会不会乱触发
Skill 的正文不是最先加载的,但它的名称和描述通常会进入模型上下文,帮助模型判断要不要使用。
问题就出在这里。
很多 Skill 的描述写得特别长,触发范围还特别宽。Skill 一多,描述可能被压缩;不同 Skill 又容易互相争抢任务,模型最后反而不知道该选谁。
OpenAI 原文举了一个数据库 Skill 的例子。
不好的写法是:
用于数据库、查询、模型或持久化相关任务。
这几乎意味着项目里碰到数据就触发。
更好的写法是:
用于新增或修改数据库迁移,或审查迁移上线方案。
能力没变,边界清楚了。
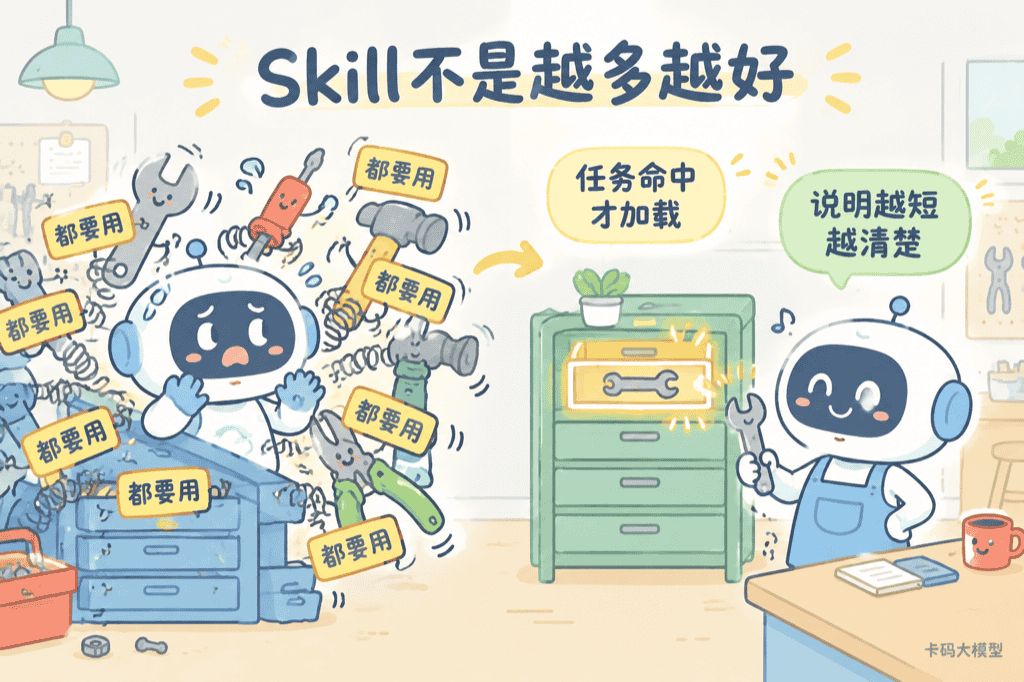
检查每个 Skill 时,我建议连续问四个问题:
- 它到底在什么动作发生时触发? 不要只写一个宽泛领域。
- 它是否把多个完全不同的工作流塞在一起? 如果是,根文档应该只做路由。
- 它是否强迫模型提前阅读当前任务用不到的材料? 用到再加载,才叫渐进式披露。
- 它是在提供项目能力,还是把“先计划、再检查”写成了长篇教程? 后者很可能已经过时。
理想的 Skill 根文档应该像酒店前台。
它负责判断你要去哪、把你指向正确房间;不是把所有房间里的东西一次性搬到大堂。
还有一个容易忽略的问题:同一个仓库可能同时被 Astra、Sol、Luna 或其他模型使用。
某条规则也许能帮旧模型稳定输出,却可能把 Astra 限制得太死。不要因为某个模型曾经犯过一次错,就给所有模型永久加一道流程。
# 第二轮检查AGENTS.md:全局规则每次都要交税
AGENTS.md 最大的价值,是把仓库里的长期约定告诉 Agent。
它最大的问题也在这里:只要模型进入这个仓库,里面的规则就可能生效。
所以 AGENTS.md 里每多一条全局要求,所有任务都要为它交一次注意力税。
最典型的旧写法是:
每次修改前,必须阅读 architecture.md、database.md 和 deployment.md。
改一个错别字,也要先读三份文档。
更合理的是按任务路由:
修改服务边界时读取 architecture.md;
修改数据库结构时读取 database.md;
准备部署时读取 deployment.md。
2
3
这不是少给模型上下文,而是只在上下文真正有用时再给。
接着检查那些“模型行为提醒”。
过去我们常写:修改后必须测试、失败后必须继续修、完成前必须自检。OpenAI 提到,Astra 已经更倾向于主动验证,同一套强调可能带来重复测试。
但 Astra 又可能对“任务应该做到多远”更谨慎,做到第一个可运行版本就回来等你确认。
因此比“永远多测几遍”更有效的写法,是把权限和终点一起讲清楚:
本地测试只使用一次性数据,不访问生产环境。
可以直接运行相关测试、修复本次改动引入的失败,并重新验证,无需逐步询问。
2
这段话提供了三个真正有用的信息:测试环境安全、允许继续修复、授权范围只覆盖本次改动。
# 第三轮检查任务提示词:别规定仪式,要定义结果
任务提示词最常见的问题,是把操作步骤写得很满,完成标准却很模糊。
例如:
先分析,列计划,等我确认;再逐个读文件,一次只改一个;
每一步都解释,最后简单检查一下。
2
模型会严格执行这套仪式,但你真正想要什么、什么算完成,仍然没有说清楚。
可以改成:
修复登录页在移动端无法提交的问题。
保持现有接口和桌面端交互不变;不要改认证协议。
完成后在移动端视口复现并验证,运行相关测试,修复本次改动造成的失败。
交付修改文件、根因和验证结果;涉及生产密钥或线上变更时停止并询问。
2
3
4
一个好任务提示词,优先写四件事:
- 目标:最终要解决什么问题。
- 硬约束:哪些接口、行为和数据不能动。
- 决策边界:哪些动作可以自主推进,哪些必须询问。
- 完成证据:看到什么结果,才算真的完成。
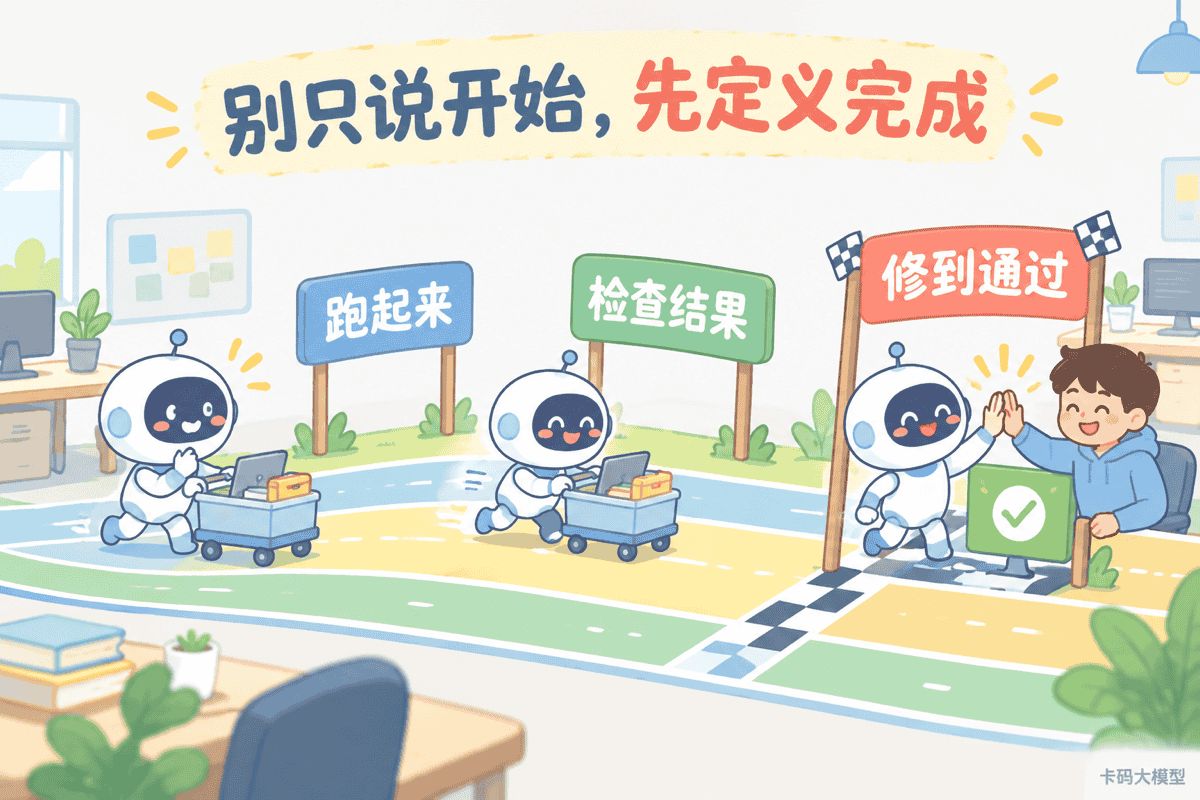
这里尤其要检查“先做一版给我看看”这种话。
如果你真的只想要草稿,没有问题;如果你期待 Agent 把功能跑起来、检查结果、修到通过,就应该把这条终点线写进任务。
模型越听话,含糊的停止条件越容易让它提前停。
# 别凭感觉删,用真实任务做一次对照
指令审计不是比谁的文件更短。
最稳妥的方法,是从最近一个月的任务里挑几类真实样本:小修改、常规功能、跨文件重构、高风险操作各选几个。
然后对照三组结果:
| 版本 | 做法 | 重点观察 |
|---|---|---|
| 当前版 | 使用现有全部规则 | 成功率、耗时、Token、人工打断次数 |
| 精简版 | 删除通用提醒和重复流程 | 是否更快,是否出现新的稳定错误 |
| 最小补丁版 | 只补回有失败证据的规则 | 能否用更少上下文恢复质量 |
不要因为一条规则“看起来很专业”就留下它。
也不要因为 Astra 某次做对了,就立刻删除所有安全约束。
看失败样本,看成本,看返工次数。
如果删掉一段 300 行的流程后,结果没有变差,甚至更好了,那 300 行就不是资产,而是债务。
# 现在就可以做的清理顺序
如果仓库里的规则已经很多,不用一天全部重写。按这个顺序最省事:
- 先列出所有
AGENTS.md、Skill 描述和常用任务模板。 - 标出重复规则、互相冲突的规则,以及“所有任务都必须”的规则。
- 把 Skill 描述改成具体动作触发,拆掉过宽的领域词。
- 把长 Skill 根文档改成路由,细节放进按需读取的参考文件。
- 把
AGENTS.md里的“每次都读”改成“什么任务读什么”。 - 给安全的本地流程明确授权,减少没有必要的逐步确认。
- 给任务模板补上验收证据和停止条件。
- 用真实任务回归,只有出现稳定退化时才补回规则。
OpenAI 这篇文章最重要的提醒,不是“GPT-6 Astra 不需要 Prompt”。
而是:Prompt、Skill 和 AGENTS.md 都是代码之外的系统资产,也会过时,也需要重构。
模型升级后,别只忙着换模型名。
先把去年给旧模型装上的辅助轮,检查一遍。
# 资料来源
- OpenAI Developers:Rethinking skills and prompts for GPT-6 Astra:https://developers.openai.com/blog/rethinking-skills-and-prompts-for-gpt-6-astra
评论
验证登录状态...