# GPT-6 Sol、Luna与Claude Opus 5.5同日发布:最强和最划算,这次不是一个答案
9 月 22 日,OpenAI 和 Anthropic 把三款模型挤在同一天发布了。
OpenAI 推出 GPT-6 Sol、GPT-6 Luna,Anthropic 推出 Claude Opus 5.5。
一个把价格直接砍半,一个把综合能力推到独立榜单第一。录友最关心的问题也很自然:Claude Opus 5.5 是不是全面赢了?GPT-6 Sol 和 Luna 还值不值得用?
先说我的结论:
- 要最高的综合能力、长时间自主干活,先试 Opus 5.5;
- 要高频 AI 编程和 Agent 跑量,Sol 的成本更容易接受;
- 要分类、抽取、批处理和便宜 Worker,Luna 才是这次最狠的产品;
- 最难任务仍应把 GPT-6 Astra 和 Claude Fable 5.1 放进评测,不要只在这三款里选。
# 三款模型,一张表先看明白
| 项目 | GPT-6 Sol | GPT-6 Luna | Claude Opus 5.5 |
|---|---|---|---|
| API 模型名 | gpt-6-sol | gpt-6-luna | claude-opus-5-5 |
| 输入价格 / 百万 Token | 2 美元 | 0.10 美元 | 4 美元 |
| 输出价格 / 百万 Token | 10 美元 | 0.50 美元 | 20 美元 |
| 缓存读取 / 百万 Token | 0.20 美元 | 0.01 美元 | 0.20 美元 |
| 上下文窗口 | 105 万 | 105 万 | 100 万 |
| 最大输出 | 128K | 128K | 128K |
| 默认定位 | 编程与复杂 Agent | 高频、聚焦任务 | 长链路编程与知识工作 |
这张表已经把三家的思路说透了。
Opus 5.5 卖上限,Sol 卖能力与成本的平衡,Luna 卖规模。
# GPT-6 Sol:不是小号Astra,而是便宜的日常主力
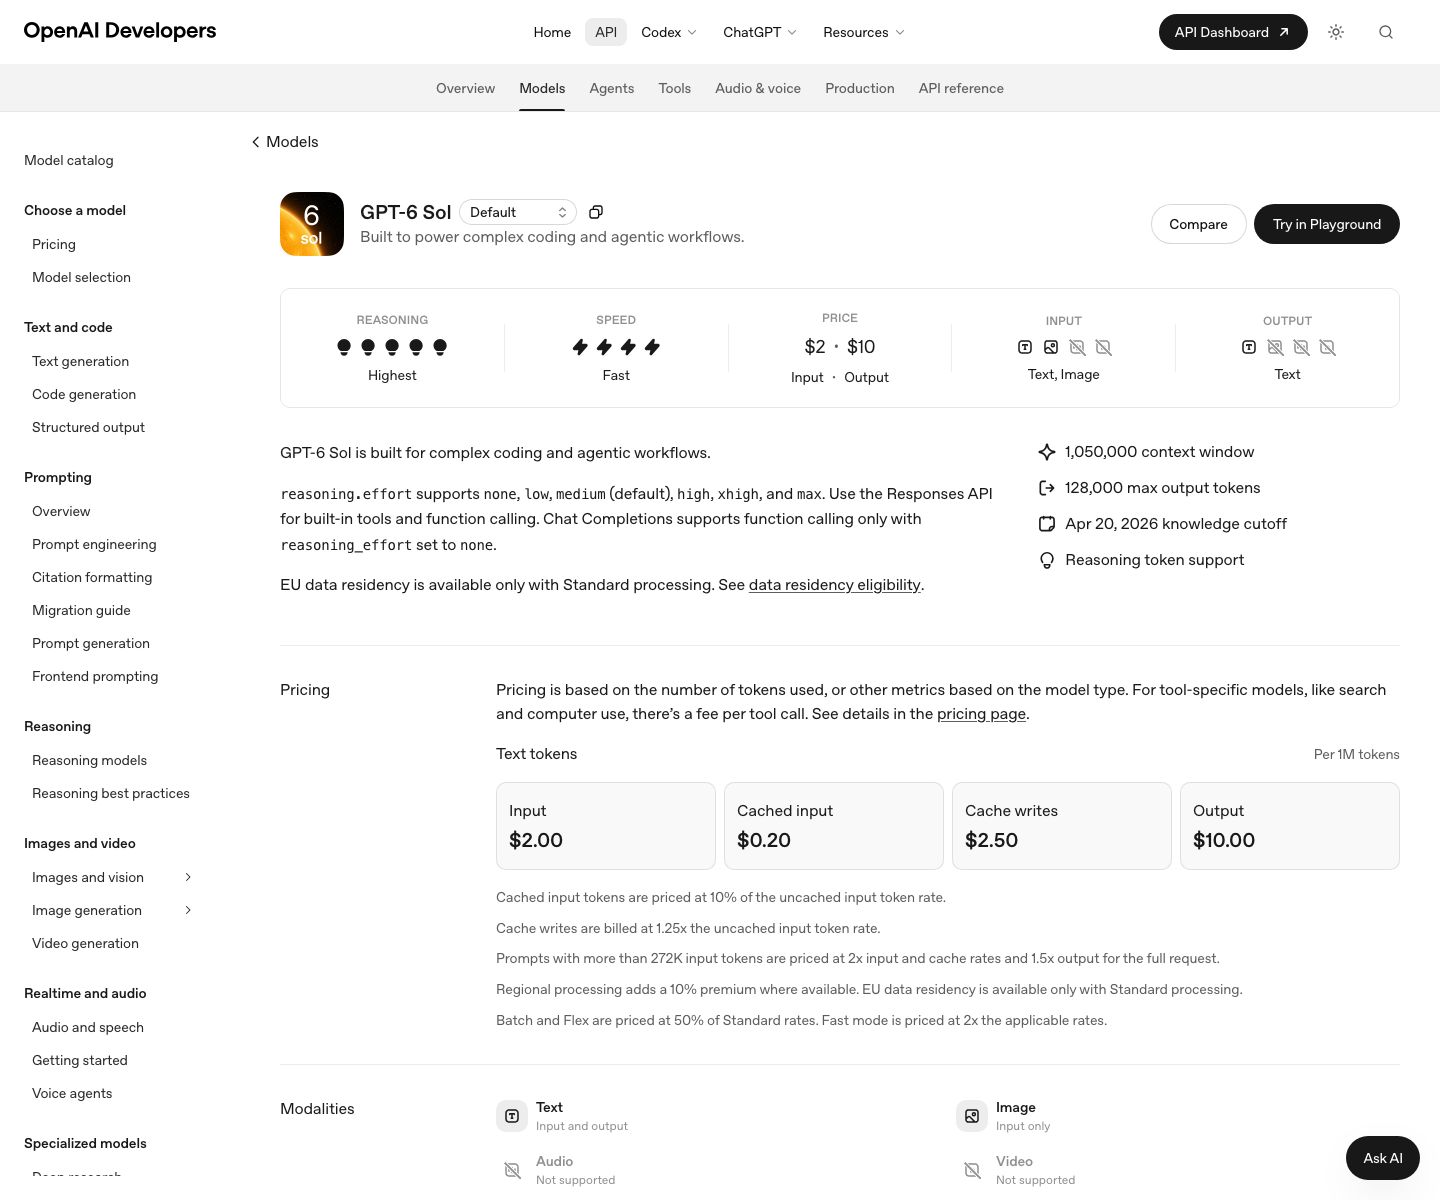
截图说明:OpenAI 官方模型页列出了 GPT-6 Sol 的 105 万上下文、128K 最大输出,以及 2 / 10 美元的标准 API 价格。
GPT-6 Sol 的输入、输出价格都是 GPT-5.6 Sol 发布优惠价的一半。它支持从 none 到 max 的推理档位,也保留了网页搜索、文件搜索、函数调用和电脑操作等工具能力。
OpenAI 给出的几个数字很亮眼:
- AutomationBench:Sol xhigh 得到 33.2%,高于 Claude Opus 5 max 的 26.9%,单任务成本只有后者约 9%;
- DeepSWE 1.1:Sol max 得到 68.8%,距离 Claude Fable 5 xhigh 的 69.9% 只差 1.1 个百分点,单任务成本约低 80%;
- OSWorld 2.0:Sol xhigh 得到 60.5%,与 Opus 5 medium 的 60.3% 接近,成本约低 80%;
- OpenAI 的内部事实性评测中,Sol 的错误数约为 GPT-5.6 Sol 的一半。
但这里有个非常重要的细节:OpenAI 对比的是 Opus 5 和 Fable 5.1,不是同日发布的 Opus 5.5。
所以“Sol 用十分之一价格击败 Claude”这句话不能直接成立。它能证明 Sol 的性价比很强,不能证明它打赢了 Opus 5.5。
# GPT-6 Luna:五毛钱输出,真正来抢批处理市场
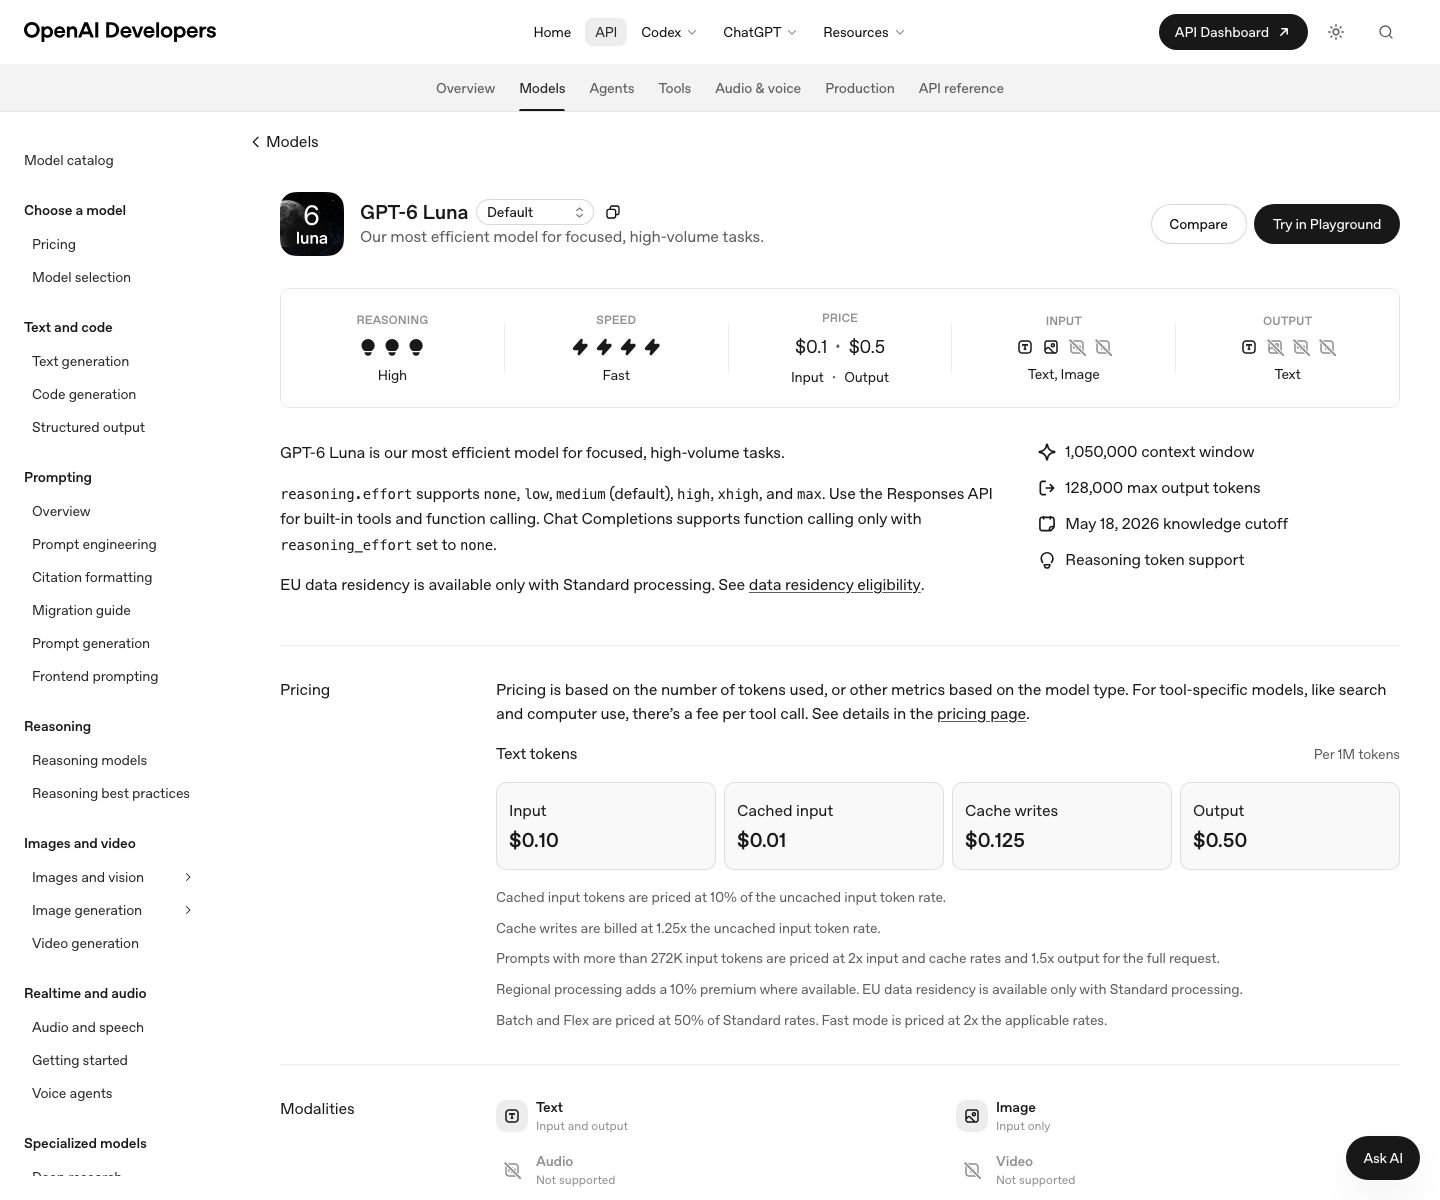
截图说明:GPT-6 Luna 的输入只要 0.10 美元、输出 0.50 美元,缓存读取低至 0.01 美元,同时仍保留 105 万上下文。
Luna 最值得看的不是“比 Sol 弱多少”,而是它已经便宜到可以改变架构。
在 OpenAI 的 DeepSWE 1.1 评测里,Luna max 得到 66.6%。它接近 Opus 5、Fable 5 的中等推理档位,但单任务成本分别低 93% 和 96%。在电脑操作评测里,Luna max 也能以约十分之一成本超过 GPT-5.6 Sol medium。
它适合做这些工作:
- 大量日志、工单、评论的分类与抽取;
- 多 Agent 系统里的搜索、整理、初审 Worker;
- 大批量代码扫描、测试生成和低风险修复;
- 先用 Luna 跑第一遍,失败或低置信度任务再升级到 Sol、Opus 5.5 或 Astra。
不过别被“0.10 / 0.50 美元”冲昏头。OpenAI 对超过 272K 输入的长上下文请求,会对整次请求提高费率:输入和缓存按两倍、输出按 1.5 倍计费。窗口很大,不代表每轮都该塞满。
# Claude Opus 5.5:能力登顶,价格反而降了
截图说明:Anthropic 在 9 月 22 日正式发布 Claude Opus 5.5,这是 Claude 5.5 家族的第一款模型。
Opus 5 的价格是 5 / 25 美元,Opus 5.5 降到了 4 / 20 美元。缓存读取从 0.50 美元降到 0.20 美元。
Anthropic 的说法是:单价降 20%,再叠加更少的 Token 和工具调用,典型任务的总成本比 Opus 5 低约 40%,输出速度快 30% 以上。
它不是单纯降价版。
- FrontierCode 1.1:默认 medium 就得到 54.6%,超过官方列出的其他模型;
- GDPval-AA 2.1:max 得到 1846 Elo,Fable 5.1 为 1735,Opus 5 为 1708;
- 一次内部研究测试里,Opus 5.5 有 16 / 18 份报告通过“数字与引用不能编造”的严格门槛,Fable 5.1 和 Opus 5 都没有通过;
- 外部早期用户反复提到,它做长迁移、跨仓库任务时步骤更少,更会委派子 Agent,也更愿意自己验证结果。
独立评测也支持“能力更强”这个方向。Artificial Analysis v4.3.2 中,Opus 5.5 max 得到 58 分,排名第一;Sol max 是 48,Luna max 是 37。
但代价同样明显:该榜单估算的平均单任务成本,Opus 5.5 max 是 5.98 美元,Sol max 是 1.06 美元,Luna max 只有 0.07 美元。并且 Opus 5.5 在整套评测里生成了 2.6 亿输出 Token,明显比 Sol 的 7700 万更“能想也能写”。
最高分不等于最高性价比。
# 网上首批评价:Opus更强,Sol更快,Luna更像架构组件
发布才一天,任何“长期结论”都不可信。但把官方早期客户、独立榜单和开发者社区放在一起,已经能看到几个重复出现的信号。
第一,Opus 5.5 的好评集中在长链路任务。有人把它当协调多个会话的总控,也有人反馈复杂任务从 38 次提示、4 天,缩短到 11 次提示、3 小时。它的优势不是某一段代码写得更花,而是少返工、能持续推进、解释更清楚。
第二,Sol 的评价明显更分裂。有盲测认为 Opus 5.5 是整体最强,Sol 则在清晰写作、PRD 和价格上讨喜;也有开发者用同样提示做 5 个小型 SaaS,Sol 总耗时 43 分钟、Opus 5.5 为 77 分钟,Sol 总分更高,但 Opus 赢下 5 局里的 4 局设计分。
第三,社区对 Luna 的兴奋点主要是价格。Artificial Analysis 测得 Luna max 为 157 Token / 秒,单任务成本约 0.07 美元。它未必适合做最终架构师,但很适合当永远不会心疼 Token 的执行层。
这些实测都要加三个限制:样本很小、Codex 与 Claude Code 的 Harness 不同、推理档位也未必完全对齐。首日体感可以帮你决定先测谁,不能替代自己的回归集。
# 还有一个容易写错的开放范围
截至发布公告:
- GPT-6 Sol、Luna 已进入 ChatGPT Work 和 Codex,覆盖 Plus、Pro、Business、Enterprise、Edu;
- Free 和 Go 用户可以在桌面端使用 Luna;
- OpenAI API 已提供
gpt-6-sol与gpt-6-luna; - 发布时两款模型还没有进入普通 Chat 对话入口,官方说会逐步开放;
- Claude Opus 5.5 已在 Claude 全平台、API、AWS、Google Cloud 和 Microsoft Azure 上线。
所以你的 ChatGPT 里没看到 Sol,不一定是账号问题。先确认自己打开的是 Work、Codex 还是普通 Chat。
# 三款模型到底怎么选
| 你的任务 | 优先选择 | 原因 |
|---|---|---|
| 大仓库迁移、复杂审计、长时间无人值守 | Claude Opus 5.5 | 当前综合能力和长链路反馈最好 |
| 高频 Claude Code、关键代码审查 | Claude Opus 5.5 medium 起步 | 默认档已经很强,别一上来就 max |
| 日常 Codex、功能开发、持续跑 Agent | GPT-6 Sol | 能力够强,成本约为 Opus 5.5 的一半单价 |
| 分类、抽取、批处理、子 Agent Worker | GPT-6 Luna | 价格低一个数量级,适合大规模调用 |
| 最难科研、电脑操作、失败代价极高 | GPT-6 Astra / Fable 5.1 | 仍然要为能力上限买单 |
| 生产选型 | 三款都跑自己的任务集 | 比较成功一次的总成本,不只看 Token 单价 |
我的建议是,把 Agent 做成升级链路:Luna 先跑,Sol 扛主力,失败再交给 Opus 5.5 或 Astra。
这次真正发生的变化,不是又多了三个模型名。
而是最强模型在降价,便宜模型开始能做过去旗舰才能做的事。接下来拉开差距的,不是谁背得出更多跑分,而是谁能把任务分级、失败回退、缓存和验收真正接进系统。
# 资料来源
OpenAI:GPT-6 Sol与Luna官方发布页:https://openai.com/index/introducing-gpt-6-sol-and-luna/
OpenAI Developers:GPT-6 Sol模型规格:https://developers.openai.com/api/docs/models/gpt-6-sol
OpenAI Developers:GPT-6 Luna模型规格:https://developers.openai.com/api/docs/models/gpt-6-luna
Anthropic:Claude Opus 5.5官方发布页:https://www.anthropic.com/claude-opus-5-5
Claude Platform:模型规格与价格:https://platform.claude.com/docs/en/models/overview
Artificial Analysis:GPT-6 Sol独立评测:https://artificialanalysis.ai/models/gpt-6-sol
Artificial Analysis:GPT-6 Luna独立评测:https://artificialanalysis.ai/models/gpt-6-luna
Artificial Analysis:Claude Opus 5.5独立评测:https://artificialanalysis.ai/models/claude-opus-5-5
Lenny's Newsletter:三款模型盲测:https://www.lennysnewsletter.com/p/opus-55-vs-gpt-6-sol-which-model
Reddit AI Coders:五个SaaS应用对比实测:https://www.reddit.com/r/AI_Coders/comments/1wnop9d/
评论
验证登录状态...