# Jev正式开放:这个模型不陪你聊天,只负责替软件做决定
前面写 GPT-6 Astra 时,我们聊的是模型怎样操作电脑、调用工具,把一条长任务真正做完。
Jev 走的是另一条路。
它不写文章,不生成代码,也不跟你聊天。它只做一件事:读取软件当前的状态,对一组明确的问题给出可以直接写进代码的答案。
2026 年 9 月 15 日,TypeSafe AI 发布首个 System One 模型 Jev,先以 Early Access 形式邀请候补名单里的开发者。9 月 20 日,TypeSafe 宣布取消候补名单,所有人都可以进入官方控制台使用。
截图说明:TypeSafe AI 官方发布页封面。团队没有把 Jev 定位成另一个聊天机器人,而是把它称为给软件使用的“机器原生智能”。
这两天围绕 Jev 的宣传很猛:70—500ms、40—200 倍速度、输出 Token 免费、“零幻觉”。
先别急着上头。
Jev 真正值得看的,不是它把某个聊天模型打趴了,而是它干脆放弃了聊天模型最擅长的自由文本。
# 正式开放,不是开源
这里的“开放”指公众可以注册 TypeSafe 控制台、调用托管 API,也可以通过 Vercel AI Gateway 使用 typesafe-ai/jev。
它不是开源模型。
TypeSafe 没有公开 Jev 的权重、模型架构和 RLCD 训练配方,也不能把它下载到本地部署。官方当前提供的是托管服务和 Python、JavaScript SDK。
基础信息如下:
| 项目 | Jev 1.13 |
|---|---|
| 正式模型 ID | jev-1.13.0 |
| 稳定别名 | jev-latest |
| API | POST /v1/systemone |
| 输入 | 仅文本,支持字符串、JSON 对象和文本数组 |
| 上下文 | 每次请求 64K Token;state 加最长问题不超过 32K |
| 官方价格 | 输入 0.042 美元 / 百万 Token,输出免费 |
| 官方延迟口径 | 70—500ms |
| 当前限制 | 不支持图片、音频、视频,不生成自由文本 |
截至 9 月 22 日,Vercel AI Gateway 还在做限时免费活动,页面注明优惠在 9 月 25 日结束。这不等于 Jev 长期免费,正式跑生产还是按 TypeSafe 的标准价做预算。
# 它和LLM的差别,不只是“返回JSON”
普通 LLM 的工作方式是一个 Token 接一个 Token 地生成文本。即便你要求 JSON,模型本质上仍在“写一段字符串”,应用拿到后还要解析、校验、重试。
Jev 的接口完全不同。
你先给它一份 state,再把可能的答案空间写进问题。模型不会临场编一段话,而是在这些答案里做选择、打分或输出概率。
截图说明:TypeSafe 官方的并行决策演示。Jev 一次评估多道问题,不需要像生成式模型一样逐 Token 输出长文本。
官方提供三种问题类型:
| 类型 | 你在问什么 | 返回什么 |
|---|---|---|
| Choice | “这些选项里该选哪个?” | 选中的选项、每个选项的概率、置信度 |
| Score | “它处在这套等级的什么位置?” | 分数、各等级概率、置信度 |
| Noul | “这个判断成立吗?” | 为真的概率,范围 0—1 |
比如客服工单进来后,可以同时问三件事:该交给哪个部门、是否紧急、用户有多生气。
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

state = "支付接口持续返回 500,线上订单已经无法处理。"

with TypeSafeClient(model="jev-latest") as client:
    result = client.system_one(
        state=state,
        questions={
            "department": Choice(
                instructions="应该由哪个团队处理?",
                criteria={
                    "billing": "支付或订阅问题",
                    "technical": "接口、系统或集成故障",
                    "sales": "售前与价格咨询",
                },
            ),
            "urgent": Noul(instructions="这条工单是否紧急?"),
            "severity": Score(
                instructions="故障严重程度如何?",
                criteria=["轻微", "影响部分用户", "阻断核心业务"],
            ),
        },
    )
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
程序拿到的不是“我认为应该交给技术团队”这句话,而是固定类型的值和概率。后面是自动转给技术组,还是低置信度时交给人工,由你的代码决定。
所以 Jev 更像一组带概率的智能 if,不是一个缩小版 ChatGPT。
# 这东西最适合放在Agent的哪一层
Jev 不负责把整项任务做完,它适合站在关键岔路口。
例如一个编程 Agent 修完 Bug 后,要决定下一步是继续改、重新跑测试、向用户追问,还是停止;一个客服系统要判断工单归属和优先级;一个内容平台要决定放行、拦截还是送人工复核。
这些任务有三个共同点:答案范围能提前定义,调用频率很高,而且判断一旦拖到几秒,整条工作流都会变慢。
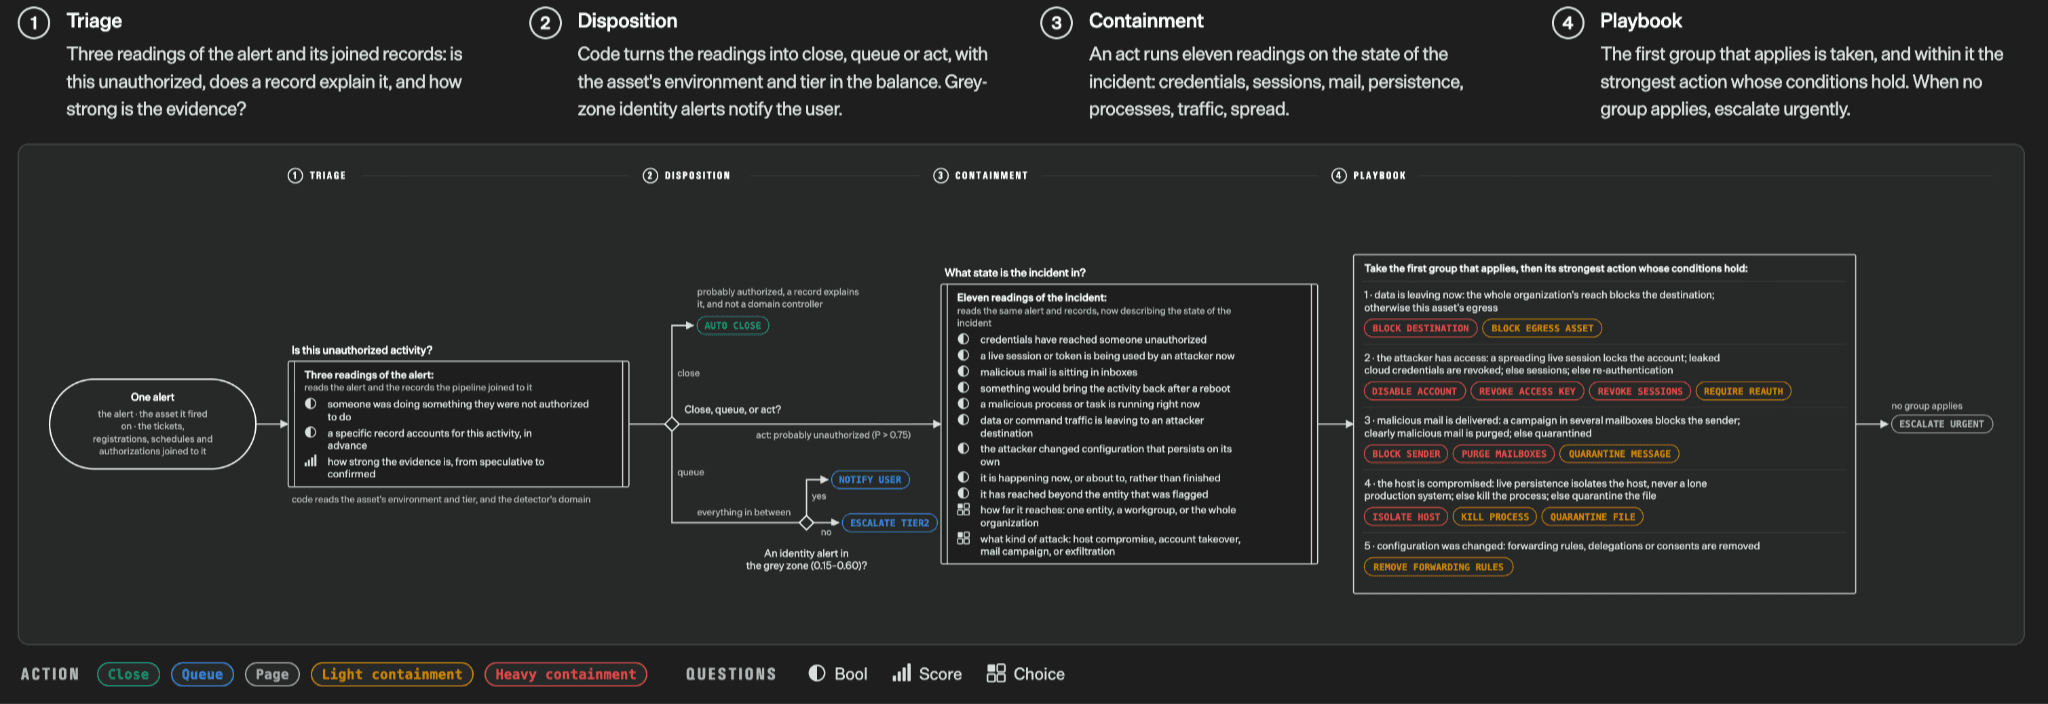
截图说明:TypeSafe 官方展示的安全告警处置工作流。Jev 负责分诊、评分和选择,真正的动作、阈值与执行顺序仍由代码控制。
这张图把边界画得很清楚:模型做判断,代码做编排。
传统 Agent 喜欢把所有逻辑都塞进一条 Prompt,让大模型自己想、自己选工具、自己解释。灵活是灵活,但一条链路里只要连续做十几次判断,延迟、成本和偶发跑偏都会被放大。
Jev 的思路是把复杂判断拆成原子问题,并行问完,再由代码组合。
这和 Codex Record & Replay 代表的“让 Agent 学会操作软件”并不冲突。前者教 Agent 怎么做,Jev 更像是在每个路口帮它决定接下来该走哪条路。
# 194倍快、445倍便宜,先看脚注
TypeSafe 在四套内部工作流评测中,报告 Jev 最多比对比 LLM 快 193.6 倍、便宜 444.6 倍。
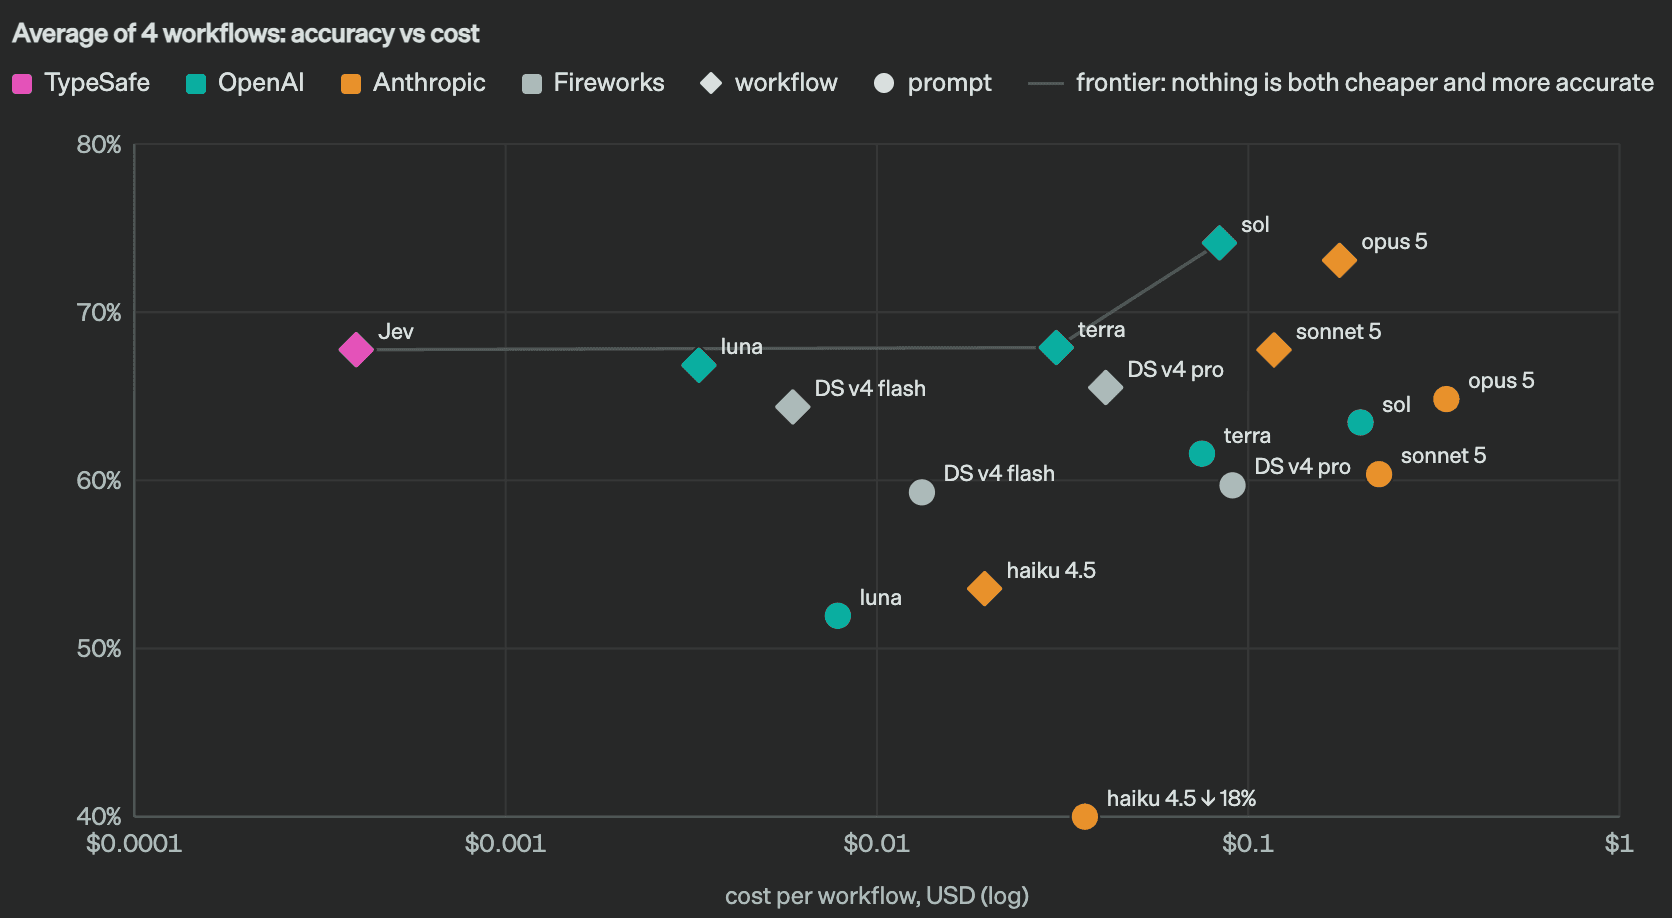
截图说明:TypeSafe 官方工作流评测的平均结果。横轴为单次工作流成本,纵轴为相对参考答案的准确率,Jev 位于左上方的成本—准确率前沿。
图确实很漂亮,但几个限定条件不能省:
- 这是 TypeSafe 自己设计并执行的工作流评测,不是独立第三方榜单;
- 参考答案取 GPT-6 Astra 与 Claude Fable 5.1 概率的平均值,不是真实世界的绝对真值;
- 官方自己也承认,193.6 倍和 444.6 倍很可能处于真实收益的高端;
- Jev 放弃了文本生成,只在适合自己的封闭决策题上比较。
这组数据能证明“高频、窄答案空间的判断没必要每次都调用旗舰 LLM 写一段话”,但不能证明 Jev 的综合能力超过 GPT-6 Astra 或 Claude Fable 5.1。
Vercel 给出的另一个数据更接近真实采用情况:Jev 上线 AI Gateway 24 小时内,被近 13% 的付费团队调用,成为该平台历史上采用最快的新模型。
新鲜感会带来试用,能不能留在生产环境,还要看一个月后的调用量和真实误判成本。
# “零幻觉”这句话,千万别按字面理解
TypeSafe 宣传 Jev “Zero Hallucinations”,官方图里结构化输出错误率和工具调用错误率也都是 0%。
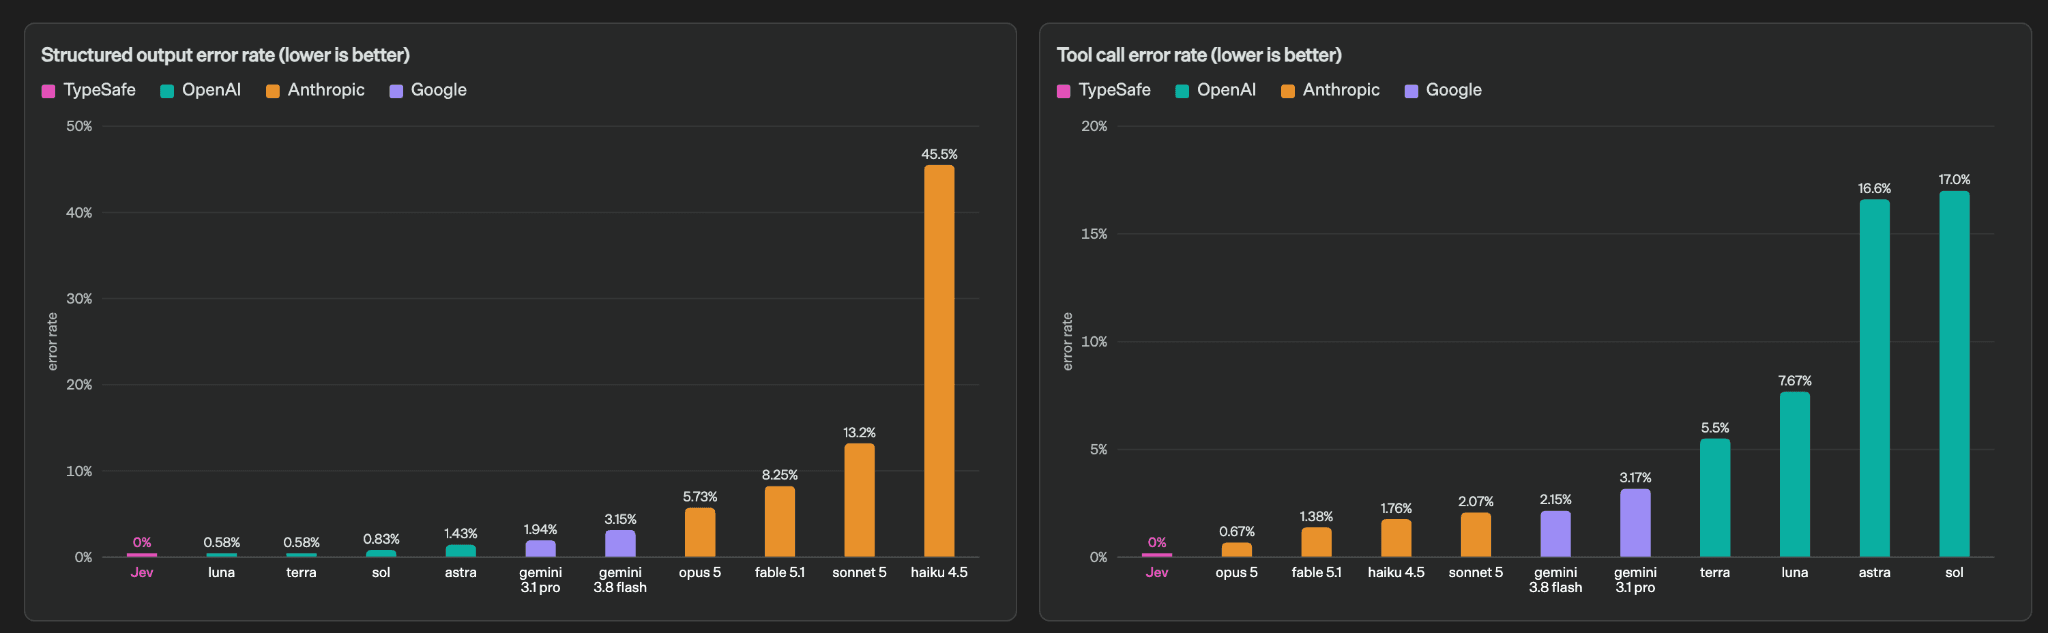
截图说明:TypeSafe 官方对比的是结构化输出和工具调用是否越过规定类型。Jev 的输出空间预先固定,因此不会生成 Schema 之外的值。
这里的 0%,准确说是:它不会返回类型之外的答案。
如果你只允许 billing、technical、sales 三个选项,Jev 不会突然返回一段散文,也不会造出第四个 marketing。从类型系统角度看,这确实消灭了一类幻觉。
但它完全可能在三个合法选项里选错。
官方文档甚至专门列了 jev-1.13 的已知毛边:
- 容易按字面理解,问题写得含糊就会答偏;
- 不擅长计数、数学、精确数值和日期比较,这些应该交给代码;
- 状态里无关信息太多时,准确率会下降;
- 多层间接推理、双重否定和提示注入会让它更不稳定;
- 英语是主要训练语言,中文等语言能用,但需要自己评测;
- 不会生成文本,需要写解释、代码或回复时仍要调用生成式模型。
所以更靠谱的生产写法是:高置信度自动执行,中间区域送更强模型复核,低置信度或高风险操作交给人。
类型正确不等于事实正确,概率也不等于承诺。
# Jev、Astra、Fable、DeepSeek怎么选
这几类模型不是同一把尺子上的竞争对手。
| 你的任务 | 优先选择 | 原因 |
|---|---|---|
| 写文章、代码、分析报告 | GPT-6 Astra / Claude Fable 5.1 / DeepSeek V4 | 需要自由文本生成和长链路推理 |
| 操作电脑、浏览器、终端完成复杂任务 | GPT-6 Astra 等 Agent 模型 | Jev 不直接操作界面,也不会规划完整长任务 |
| 工单分类、风险评分、意图路由 | Jev | 输出空间固定,快、便宜、可直接进代码 |
| Agent 选择下一工具或是否继续 | Jev + 生成式模型 | Jev 做路由,生成式模型负责真正执行 |
| 数学、日期、精确规则 | 普通代码 | 能确定计算的事,不该交给概率模型 |
| 中文核心生产流程 | 先做自己的标注集评测 | 官方明确说英语表现最好,不能照搬英文结果 |
我对 Jev 的判断是:它不会替代 LLM,但很可能从 LLM 手里拿走大量“根本不需要写字”的调用。
过去我们让大模型先生成一段文本,再费劲把文本变回程序能用的值。Jev 直接从状态走到决策,把中间那段文字删掉了。
这件事看起来没有“会写诗、会操作电脑”那么炸裂,却更像真实软件需要的能力。
能确定的交给代码,需要判断的交给 Jev,需要创造和推理的再交给大模型。
边界划清楚,Agent 才能又快又稳。
# 资料来源
TypeSafe AI:Introducing System One Models & Jev:https://typesafe.ai/blog/introducing-system-one-models-and-jev
TypeSafe AI:Jev 公开访问公告:https://x.com/typesafeai/status/2101786156572823624
TypeSafe AI Docs:Introduction:https://docs.typesafe.ai/introduction
TypeSafe AI Docs:Models:https://docs.typesafe.ai/models
TypeSafe AI Docs:Jev 1.13 jaggedness:https://docs.typesafe.ai/model-jaggedness/jev-1.13
TypeSafe AI API:https://api.typesafe.ai/docs
Vercel:Jev is the fastest-adopted model in AI Gateway history:https://vercel.com/blog/ai-gateway-jev-model-launch
Vercel AI Gateway:Jev model:https://vercel.com/ai-gateway/models/jev
评论
验证登录状态...