# GPT-6.1 Terra来了:价格只有Astra十分之一,日常Agent该换主力了?
想开通会员体验新模型的录友,充值方法看这里:ChatGPT充值教程:国内怎么开通Plus?
前面聊 GPT-6.1 Sol 时,我最关心的是:复杂任务的主力模型,能不能再便宜一点。
现在,OpenAI 又往下压了一档。
GPT-6.1 Terra 正式发布,标准 API 输入每百万 Token 1 美元,输出 5 美元。
输入、输出单价都是 Sol 的一半、GPT-6 Astra 的十分之一。它的重点是看图、操作电脑,以及把日常工作更快地做完。
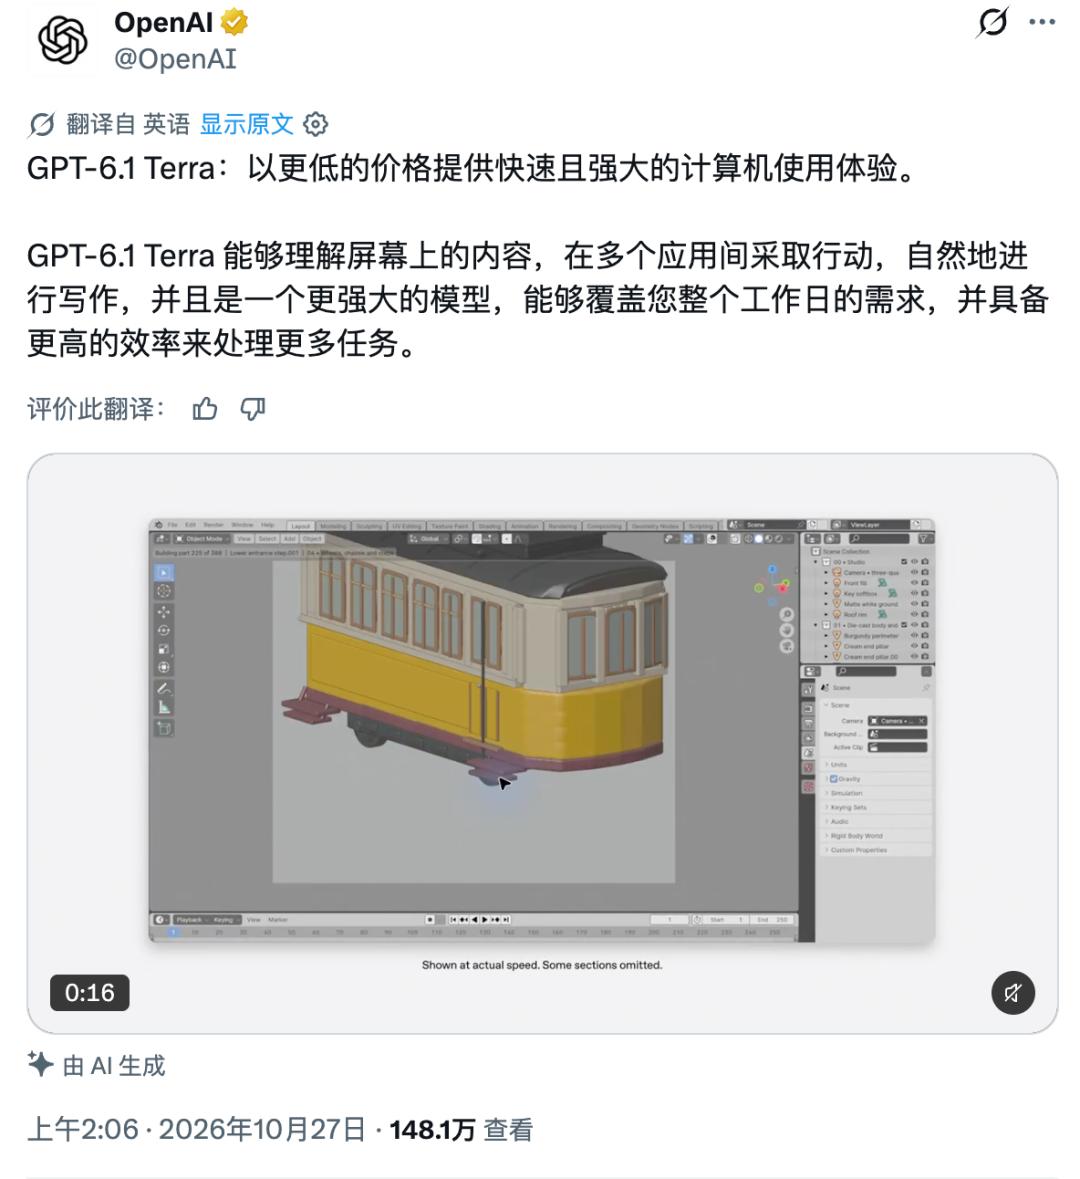
本文配图均直接引用自录友提供的 36氪报道 (opens new window),图片权利归原作者及相关权利人所有;价格、规格和入口另核对了 OpenAI 官方资料。
我对 Terra 的判断很直接:它值得放进日常 Agent 的候选名单,尤其是大量重复、结果容易检查的任务。
至于最难的架构设计、跨模块重构,先保留 Sol 和 Astra,拿真实项目测完再决定。
# 先算价格:同样的Token,账单差多少?
下面是官方标准 API 价格,单位为美元/百万 Token,适用于单次输入不超过 272K Token 的请求。
| 模型 | 输入 | 缓存读取 | 输出 |
|---|---|---|---|
| GPT-6.1 Terra | 1 | 0.05 | 5 |
| GPT-6.1 Sol | 2 | 0.10 | 10 |
| GPT-6 Astra | 10 | 1 | 50 |
| GPT-6 Luna | 0.10 | 0.01 | 0.50 |
假设一批任务总共消耗 100 万非缓存输入 Token、20 万输出 Token,不计工具费用:Terra 是 2 美元,Sol 是 4 美元,Astra 是 20 美元。
对每天只问几句话的录友,这点差价感知不强。但如果一个 Agent 每次执行要循环十几轮,还要同时跑多个任务,单价差距就会被放大。
不过,每个 Token 便宜,不代表每个任务一定便宜。
同一个需求,模型会走多少步、返工几次、最后能不能验收,都会影响账单。做模型选型,应该比较“完成一个合格任务的总费用”。
还有两个计费细节别漏:缓存读取价不等于缓存写入价;单次输入超过 272K Token,整次请求的输入和缓存费率翻倍,输出费率变成 1.5 倍。工具调用也可能产生额外费用。具体见 官方价格表 (opens new window)。
# 看懂屏幕后,能不能把事情做完?
Terra 的一个主要方向,是把视觉推理和电脑操作连接起来。
比如做电商运营,你给它一份供应商产品图册,让它找出对应的商品,检查配图,再更新商品信息。中间既要识别图片,也要操作网页和表单。
再比如检查一组宣传图:文字有没有被裁掉,标题位置是否一致,哪些素材需要返工。最后交付一份修改清单,并把文件整理好。
这些都是官方文档给出的应用方向。对录友来说,它们比“模型能认出图片里有什么”更接近日常工作。
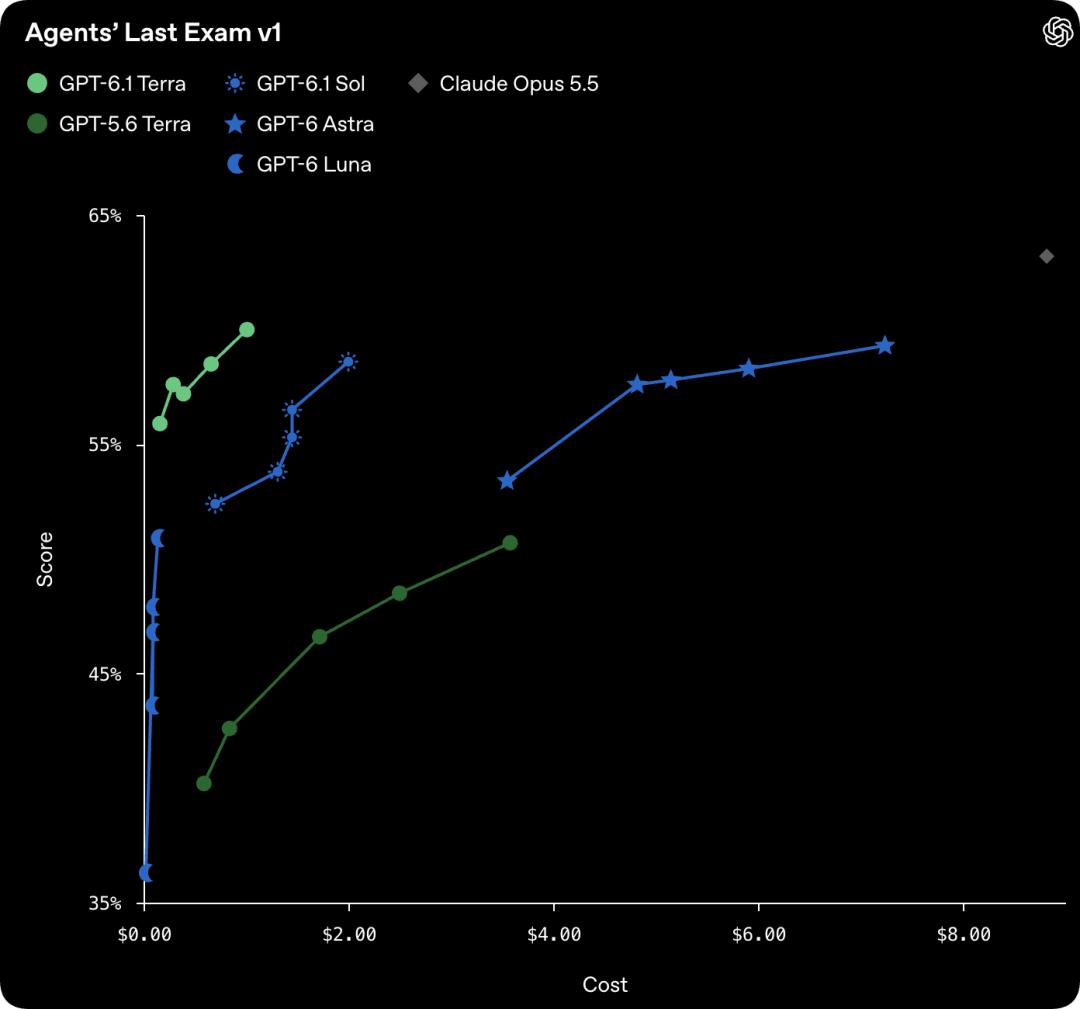
根据 OpenAI 发布说明 (opens new window),在 Agents’ Last Exam 专业任务评测中,Terra 的 medium 档比 GPT-5.6 Terra 高 15 个百分点,任务成本约为三分之一;该评测中的任务完成速度超过 Astra、6.1 Sol 的 3 倍。
这里要看清楚:这是指定评测环境下的结果,不能直接理解成你所有任务都能快 3 倍。
实际做电脑操作,页面加载、应用响应、弹窗和工具权限都可能拖慢流程。一个模型生成文字很快,也可能卡在某一步操作上。
如果准备把 Terra 接进业务,我建议先挑一条能明确验收的流程:例如从十张产品图里匹配商品编号,生成待更新清单,再核对编号和图片是否一一对应。
先把这条流程跑通,再增加跨应用操作。每一步有没有做对,要能查得出来。
# 编程也在进步,但别只盯着“翻倍”
官方公布的 Terminal-Bench 4.0 成绩中,Terra 在最高推理档位的解决率是 50.3%,上一代公开成绩为 21.5%。这项基准侧重命令行环境中的编程任务。
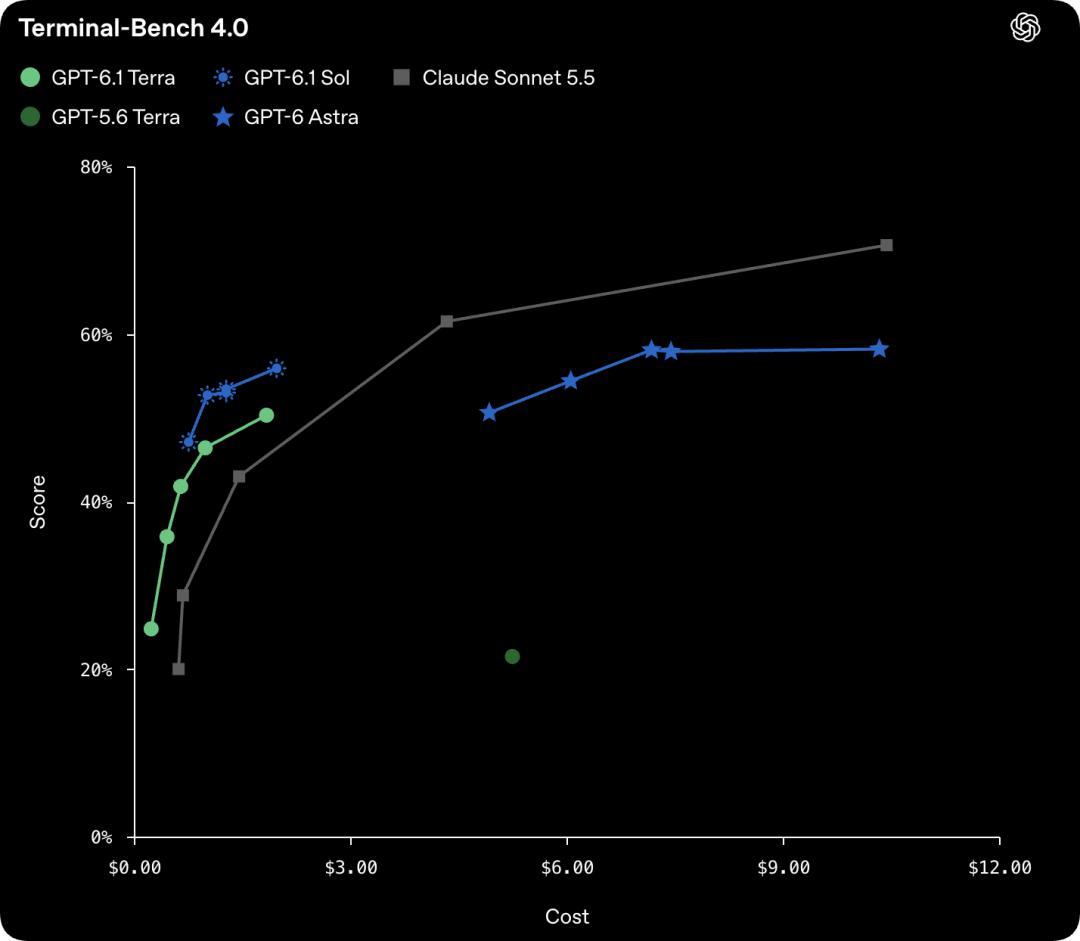
“成绩翻倍”值得关注,但它不等于你修 Bug 的成功率也会翻倍。不同仓库的依赖、测试覆盖和需求清晰度,差别很大。
我的建议是先把 Terra 用在边界清楚的活上:根据报错修一个小问题、按既定规则改一批文件,或者给已有逻辑补测试。验收标准越明确,越容易看出便宜模型能不能胜任。
如果任务涉及复杂设计取舍,或者需要理解多个模块之间的历史约束,就把同一份需求交给 Sol、Astra 一起测。
评估时至少记录三件事:首次交付是否通过、人工返工花了多久、总费用是多少。
# 错误率下降,仍然要留住核对环节
在 OpenAI 内部的高难度事实性评测中,low 档错误率从上一代的 53.6% 降到 16.7%,Terra 的 max 档为 4.3%。这些数字只对应这套测试。
对业务的实际意义,是我们可以进一步测试它处理资料的可靠性;不能把 4.3% 当成所有回答的通用错误率。
举个例子,做发票录入时,字段都填上了,只能说明流程走完了。金额、小数点、币种、供应商和发票号能否对应原图,才决定结果能不能用。
让模型附上原始图片或文档位置,再核对关键字段,通常比要求它“仔细一点”更有用。
# 105万上下文,开发者接入要注意什么?
按照 官方模型文档 (opens new window),主要规格如下:
| 项目 | GPT-6.1 Terra |
|---|---|
| API模型名 | gpt-6.1-terra |
| 上下文窗口 | 1,050,000 Token |
| 最大输入/输出 | 922,000/128,000 Token |
| 输入/输出形式 | 文本、图片输入;文本输出 |
| 推理档位 | none、low、medium、high、xhigh、max |
| 默认推理档位 | medium |
| 工具调用入口 | Responses API |
它支持 Computer Use、Web Search、File Search、Code Interpreter、MCP 等工具。模型能调用哪些工具,与应用实际有没有接入、账号有没有权限,是两回事。
迁移时尤其注意:如果原来通过 Chat Completions 调工具,需要把对应请求迁到 Responses API。 官方建议先从 medium 开始,再判断更高推理档位带来的质量提升是否值得增加耗时和 Token。
上下文长,也别把整个项目无差别塞进去。先检索相关文件、保留必要截图,既能减少费用,也方便定位它到底看了什么。
# 已进入Work和Codex,普通Chat里还没有
据 ChatGPT 官方更新说明 (opens new window),Terra 已向 Plus、Pro、Business、Enterprise 和 Edu 套餐的 ChatGPT Work、Codex 开放。
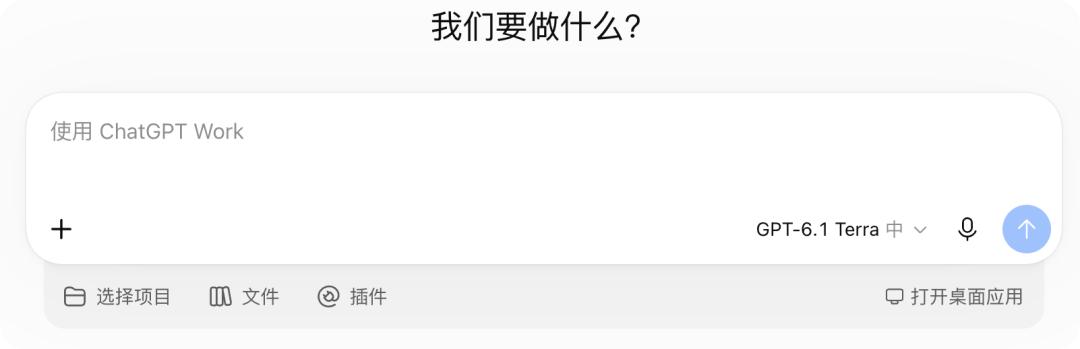
桌面端或网页版 Work 可以在 Advanced 的模型列表中选择 Terra,移动端 Work 也支持。普通 Chat 暂不可用,企业工作区还受管理员设置和开放情况影响。
所以,充值之前先确认自己要用的入口,别把“套餐支持”理解成所有对话窗口都能选到。
# Terra、Sol、Astra和其他模型怎么分工?
下面是我的测试顺序建议,不代表每个模型在所有任务上都一定胜出。
| 你的任务 | 优先测试的方向 |
|---|---|
| 图片检查、商品匹配、重复网页操作 | Terra,重点核对识别与操作结果 |
| 日常开发、跨文件修改 | Terra与Sol对照,比较返工成本 |
| 复杂软件工程、研究和设计取舍 | Sol、Astra,以及现有Claude Opus方案 |
| 高频简单分类、抽取 | 更便宜的Luna或现有小模型 |
| 有自部署要求、大批量处理 | 将DeepSeek、GLM等方案纳入独立评估 |
关于 Claude Opus、GLM 和 DeepSeek,之前的文章可以作为理解各条产品路线的背景;实际选型要用当前可用版本重新测试。
我更愿意让便宜模型先处理容易验收的任务,遇到反复失败或高难度环节,再升级模型。这样是否省钱,取决于升级条件和失败成本,不能只看一张单价表。
# 国内怎么充值ChatGPT会员?
想在 Work 或 Codex 里体验 Terra 的录友,可以参考 ChatGPT充值教程:国内开通Plus的方法与注意事项。
ChatGPT 会员订阅与 OpenAI API 独立计费。 如果你准备在自己的程序里调用 gpt-6.1-terra,开通 Plus 不等于获得 API 余额。
先拿一项每天都要做的小工作试试。能稳定交付、少返工,Terra 的低价才真正有意义。
# 资料来源
- OpenAI发布说明:https://openai.com/index/introducing-gpt-6-1-terra/
- OpenAI模型规格:https://developers.openai.com/api/docs/models/gpt-6.1-terra
- OpenAI API价格:https://developers.openai.com/api/docs/pricing
- ChatGPT开放范围与入口:https://learn.chatgpt.com/docs/whats-new/october-26-30-2026
- OpenAI接入与迁移指南:https://developers.openai.com/api/docs/guides/latest-model
评论
验证登录状态...