# DeepSeek V4.1 Flash新版发布:故宫、赛车、传送门,许愿就能做?
前面写 DeepSeek V4-Flash正式版时,重点还是 Agent 跑分和编程工具接入;后来测 Vision-Exp,它又补上了看图的能力。
这次,DeepSeek 直接拿出了四个完整项目的展示:故宫 3D 建模、网页版赛车、Godot 版《传送门2》,还有一段从史前走到现代的 3D 场景。
10 月 17 日,DeepSeek 发布 V4.1-Flash-1017 (opens new window),把这次更新叫作“许愿式编程一键成真”。
这次官方网页端、App 和 API 都已同步升级,模型权重也开放了。 和之前只更新 API 的那次不同,这回直接打开官方产品就能体验新版。
录友们可以关注三件事:做项目的能力、完成任务的成本,以及搜索工具开始单独算钱。
本文图片和动图均直接引用这篇官方公告,案例是官方展示,不是卡哥实测。
# 跑分涨了,但没有每一项都第一
先看官方对比表。
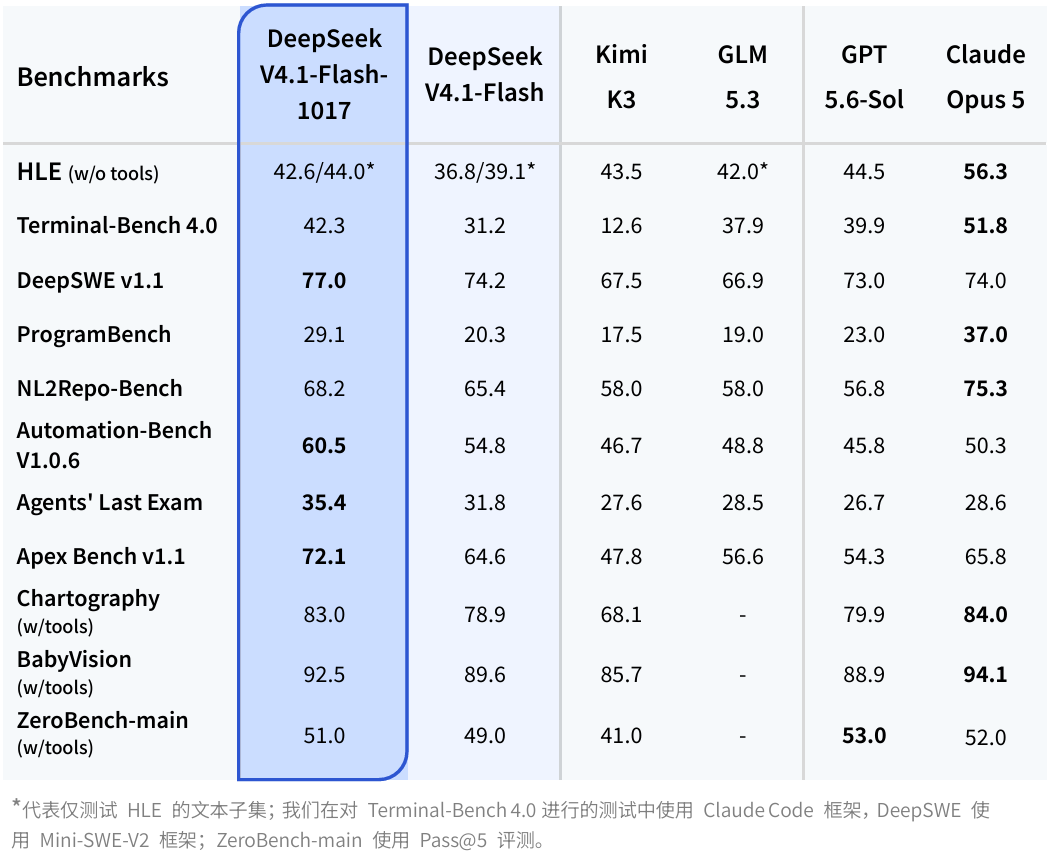
对比上一版 V4.1 Flash,几个和编程、Agent 相关的变化很直观:
| 基准 | 上一版 V4.1 Flash | V4.1-Flash-1017 | 增加分数 |
|---|---|---|---|
| Terminal-Bench 4.0 | 31.2 | 42.3 | 11.1 |
| DeepSWE v1.1 | 74.2 | 77.0 | 2.8 |
| ProgramBench | 20.3 | 29.1 | 8.8 |
| NL2Repo-Bench | 65.4 | 68.2 | 2.8 |
| Automation-Bench V1.0.6 | 54.8 | 60.5 | 5.7 |
| Agents’ Last Exam | 31.8 | 35.4 | 3.6 |
这里说的增加是分数差,比如 42.3 - 31.2 = 11.1,别直接写成“提升了 11.1%”。
新版在表内的 DeepSWE、Automation-Bench、Agents’ Last Exam 和 Apex Bench 上拿到了最高分。但 Terminal-Bench、ProgramBench、NL2Repo 等项目,仍然是 Claude Opus 5 更高。
所以,“这次进步明显”有依据,“全面超过所有模型”就说过头了。
还有个容易漏掉的脚注:这些分数背后,用的评测框架和口径并不完全一样。 Terminal-Bench 4.0 使用 DeepSeek Code 框架,DeepSWE 使用 Mini-SWE-V2;HLE 带星号的成绩只测文本子集,ZeroBench-main 则使用 Pass@5。
读表时先看任务、框架和采样口径。也别拿这里的 Terminal-Bench 4.0,直接减去旧文章里 Terminal Bench 2.1 的成绩,算跨版本涨幅。
# 更值得看的是:做完一个任务,要花多少钱
这次我更关注第二张图。
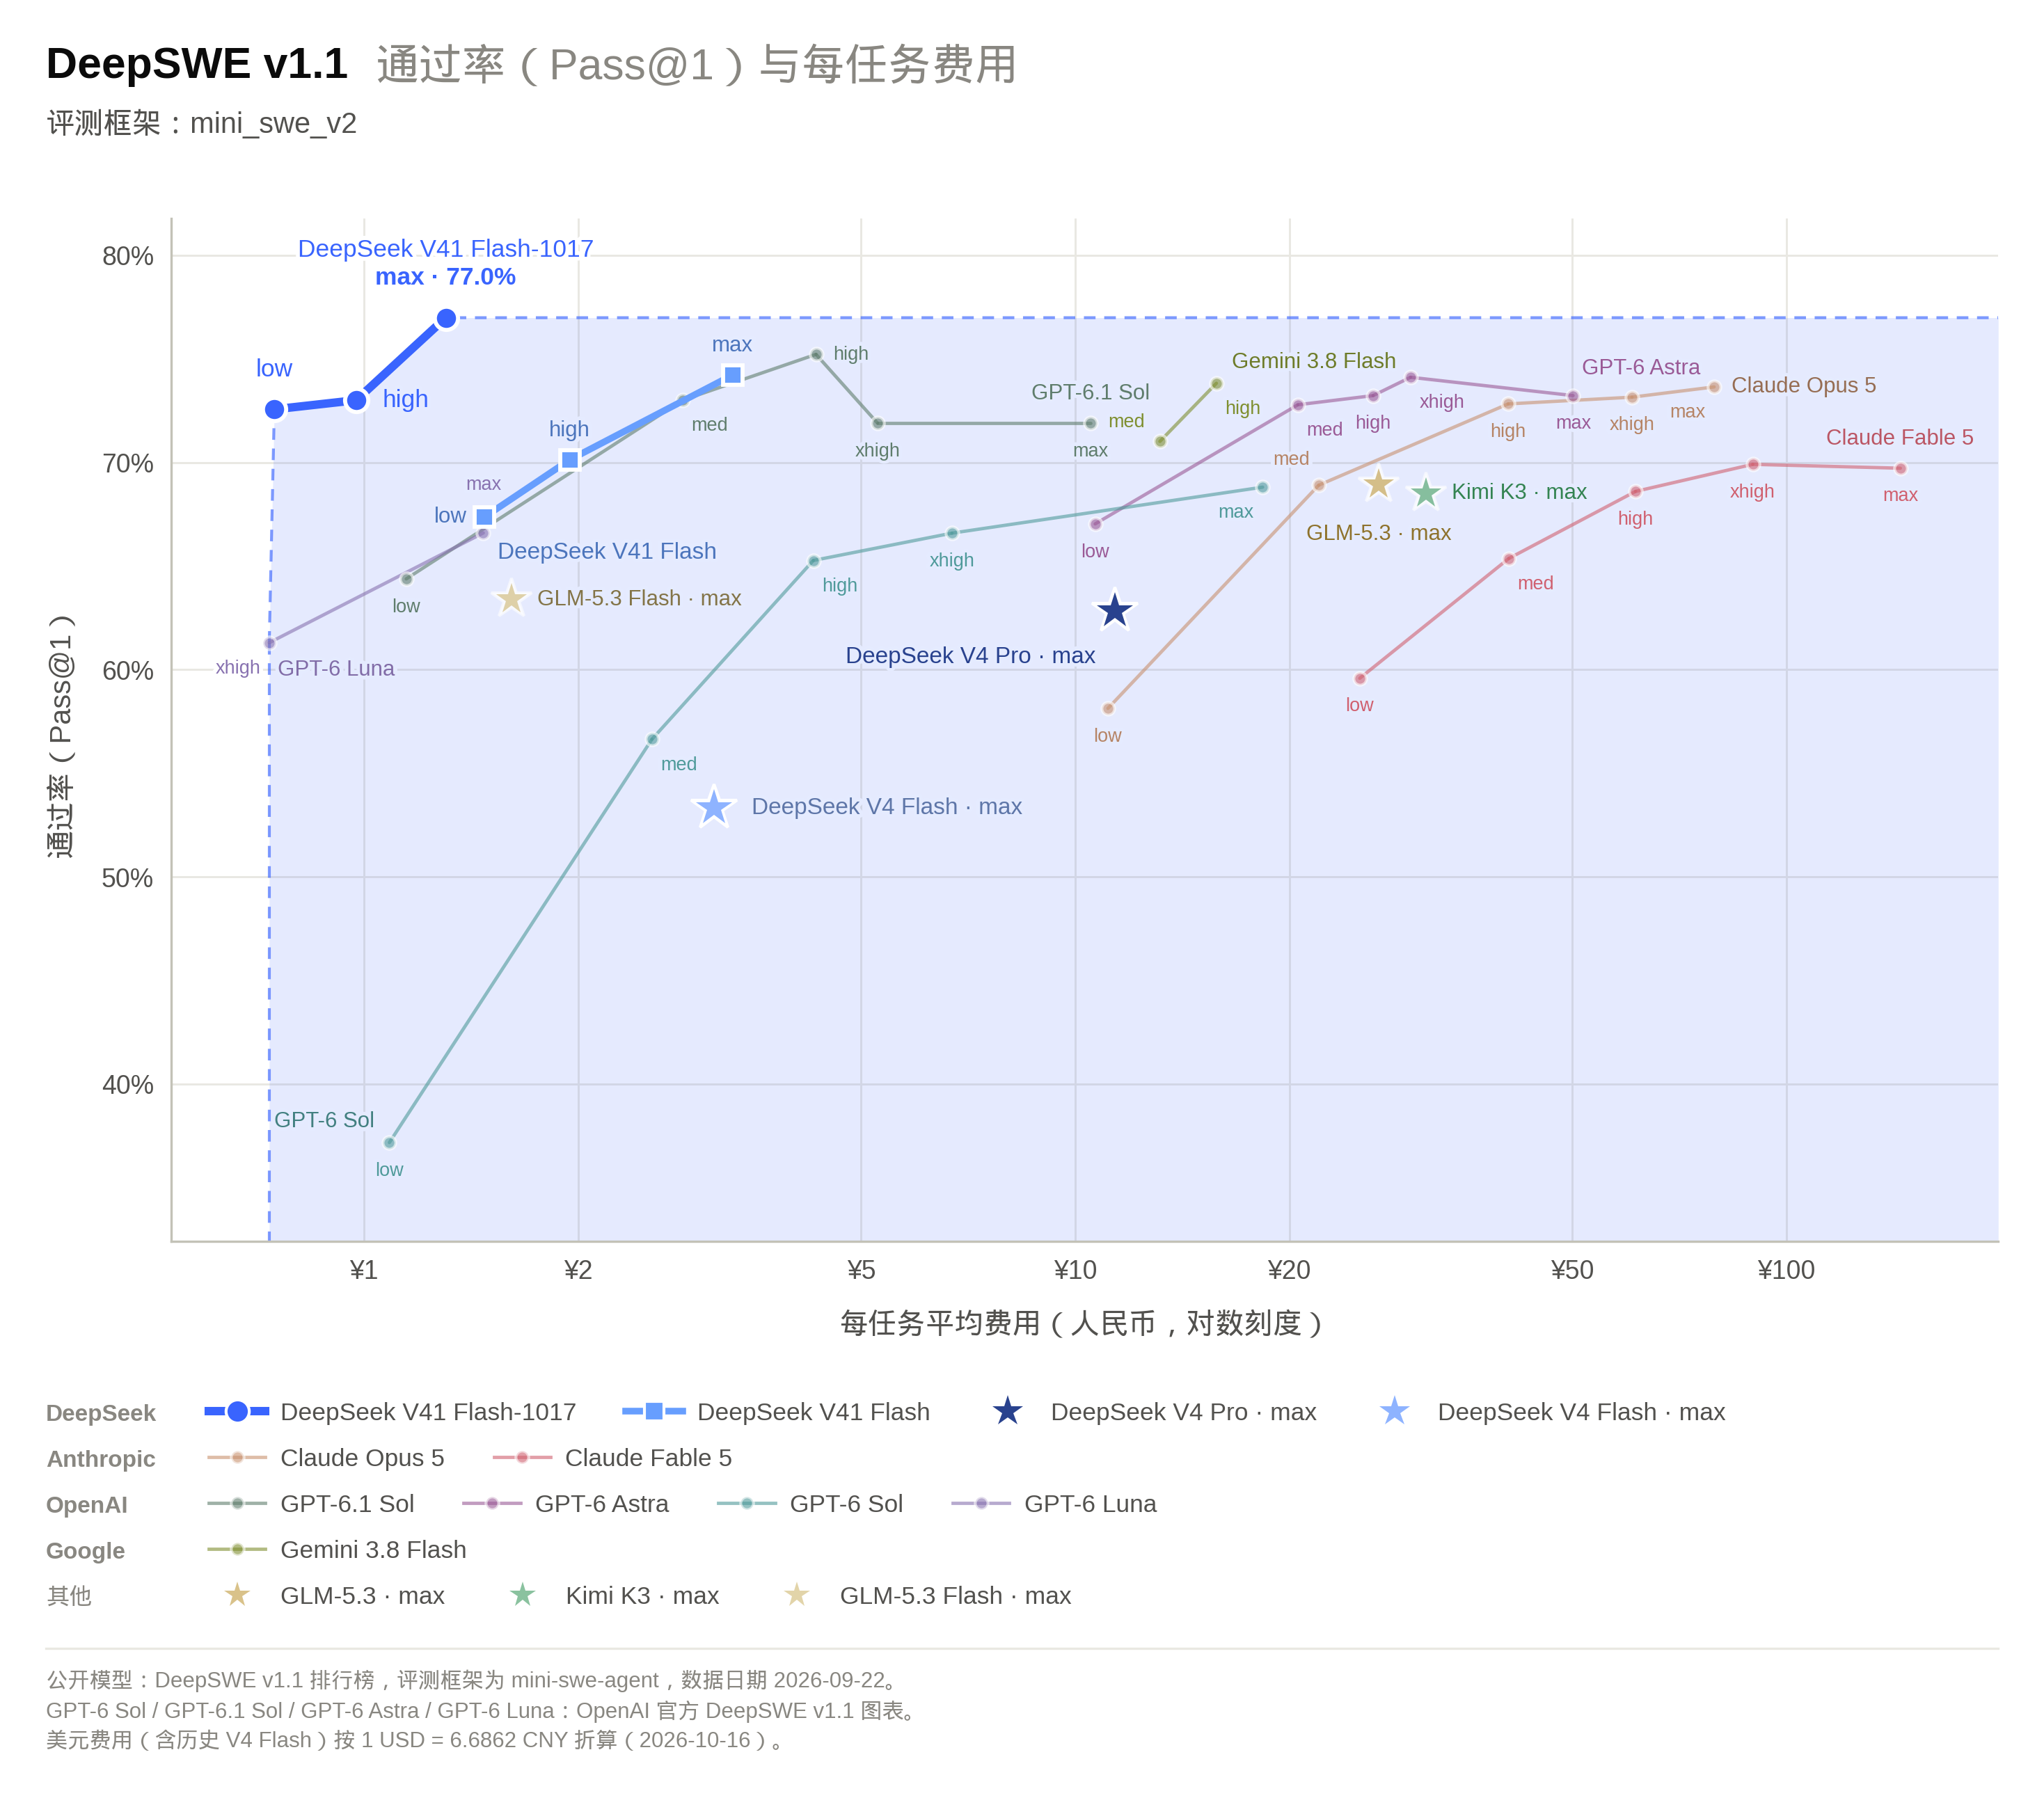
横轴是每个任务的平均费用,越靠左越便宜;纵轴是 DeepSWE v1.1 的 Pass@1,通过率越高越好。同一张图里,越靠左上方越有吸引力。
新版 max 档达到 77.0%,费用落在约 1 元到 2 元之间。上一版 V4.1 Flash 的 max 档是 74.2%,位置则在约 3 元附近。
官方还表示,新版缩短了任务运行时间和输出长度,并针对 DeepSeek Harness、腾讯 CodeBuddy、WorkBuddy 做了优化。
这就是公告里“性能—费用帕累托改进”想表达的事:在官方测试中,任务完成得更好,同时花得更少。
但这张图展示的是任务费用,不能据此认定模型的 Token 单价降了。少输出一些 Token、少走几轮弯路,都可能降低一项任务的总成本。
另外,横轴是对数刻度,不能按图上的距离直接算价格倍数。图中部分竞品数据还有各自的来源日期,美元费用按 10 月 16 日汇率换算;它适合看官方这次的比较结果,不代表今天每个产品、每种任务的实时账单。
对于批量跑 Agent 的录友,这个方向很实在:一次任务少折腾几轮,省下来的就是等待时间和调用费用。
# 四组动图,看看“许愿式编程”到底在展示什么
官方说,这次通过基于自反馈的强化学习(RL)训练,增强了模型从零构建完整项目的能力,尤其是游戏开发和 3D 建模。
下面四个案例都在 DeepSeek Harness 环境中完成。按照公告描述,使用的提示词和素材参考较少,交互轮次也很短。
# 故宫3D建模
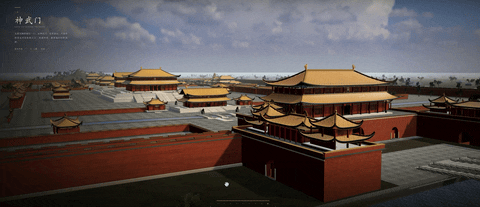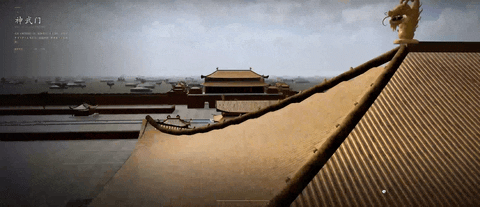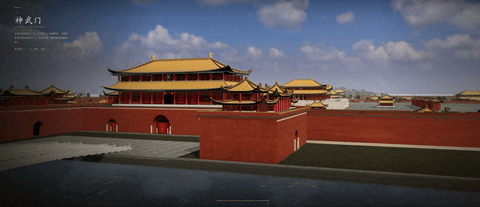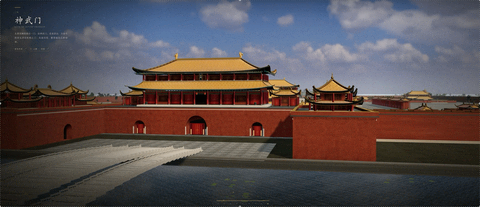
这个例子展示的是建筑场景。对于这类任务,验收要看空间布局、建筑比例和整体风格能不能统一,做出一个场景比拼出几个单独物体更难。
# 网页版赛车游戏
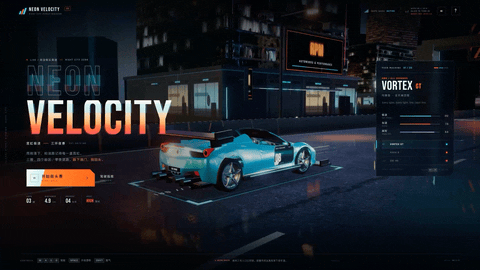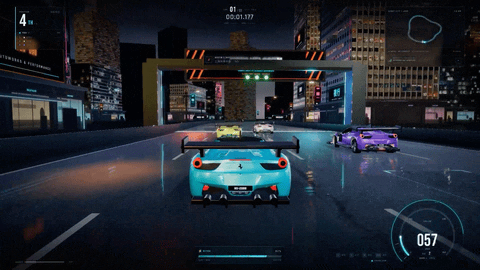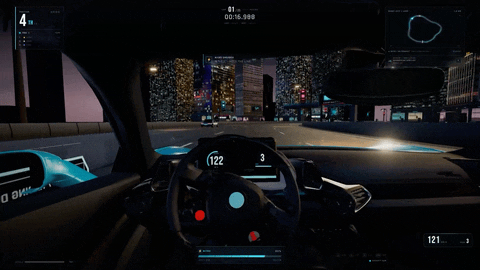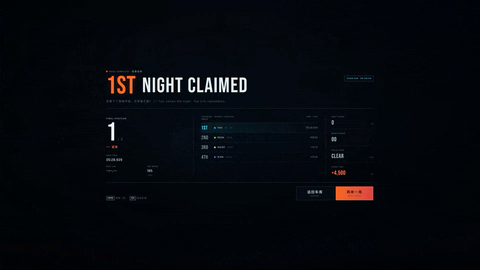
做游戏也比生成一张页面截图多了几道关:画面要动,操作要响应,游戏规则要跑起来。官方把这类可交互项目放进展示,明显是在强调从界面生成走向完整功能。
# Godot版《传送门2》复刻
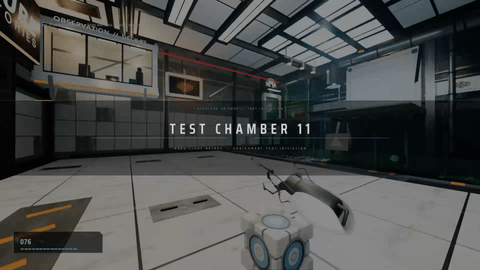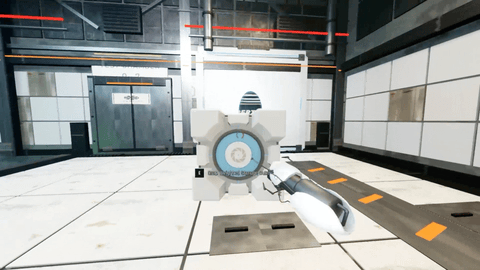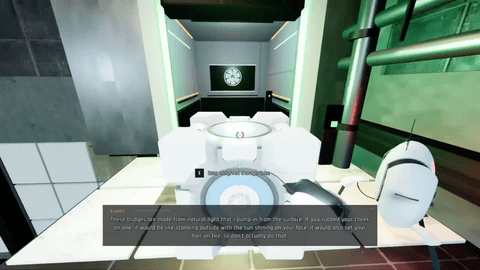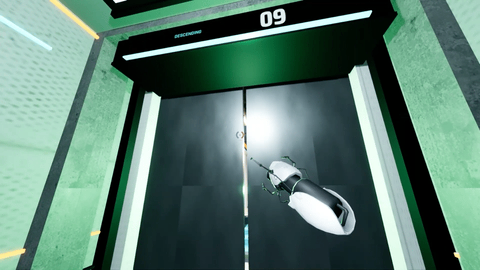
这组使用 Godot 引擎。它展示了模型在游戏引擎项目中的开发效果,但“复刻效果”不等于完成了原作的全部关卡、资源和玩法,别把演示范围放大。
# Valley of Ages时代演进场景
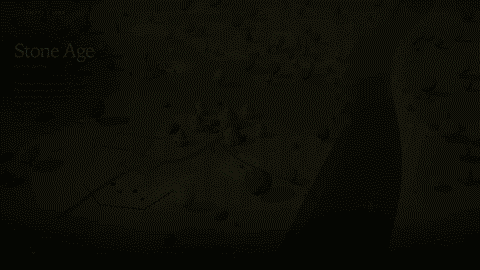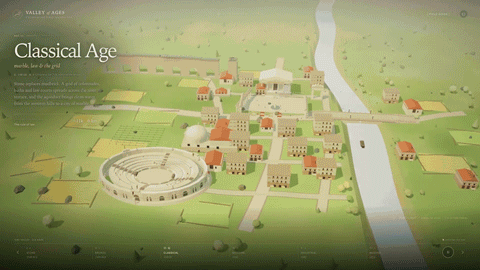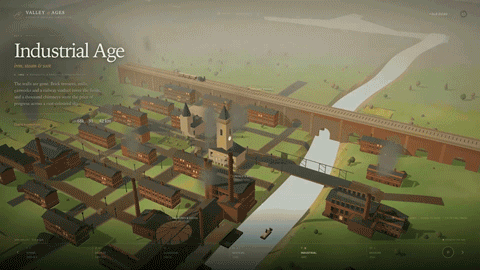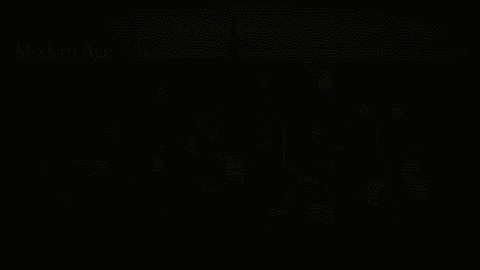
这组通过 3D 场景动态展现从史前到现代的发展历程。比起单个模型,它更强调多个阶段之间的场景组织和动态表达。
四个案例看完,能理解官方为什么强调“完整项目”了。
不过,公告没有完整列出这四次任务的提示词、交互记录、耗时和费用。动图能展示最终效果,不能直接证明任意一句需求都能一次做成。
真要拿它干活,还是得写清楚交互、运行环境和验收条件。比如赛车项目,至少明确转向、碰撞、重开这些行为,再实际试玩。
# Search和Fetch开放,11月1日有一笔费用要留意
这次还有一个和 Agent 成本直接相关的更新:DeepSeek 正式开放自研搜索能力,新增 Search 和 Fetch 接口。
按官方使用指南 (opens new window),两者分工很清楚:
| 接口 | 做什么 | 价格 |
|---|---|---|
| Search | 按搜索词查网页,返回结构化结果 | 每千次成功请求 5 元 |
| Fetch | 抓取单个网页,返回 Markdown 正文 | 每千次成功请求 5 元 |
换算下来,一次计费请求是 0.005 元。假设某个任务发生 20 次计费 Search 和 40 次计费 Fetch,工具费就是 60 × 0.005 = 0.3 元,还要另算模型调用费用。
计费按请求次数算,Search 一次返回多少条结果不改变单次价格。请求失败、搜索无结果或抓取不到正文,不计费。
重点是生效范围和时间。
官方提醒:在 DeepSeek Harness、Claude Code、Codex 中使用 DeepSeek API 时,已经会通过服务端工具调用访问 Search/Fetch。这部分调用当前尚未计费,将于北京时间 2026 年 11 月 1 日 00:00开始按次收费。
这条过渡安排指的是上述服务端工具调用,别理解成所有 Search/Fetch 请求都能免费用到 11 月。
如果你在批量跑联网 Agent,预算里就得加上搜索和抓取次数。模型少输出了,工具调用却变多了,最后的总账仍要一起看。
# 现在怎么用,怎么选
想直接体验,可以从已更新的官方网页端或 App 开始。
想复现编程案例,官方建议把 DeepSeek Harness 升级到 0.2.1-rc.1 或以上版本。安装和基本操作可以参考前面的 Harness教程,版本要求以本次公告为准。
模型权重也已经发布,Hugging Face 和 ModelScope 都有下载入口。需要自部署的团队,可以进一步评估部署资源和实际吞吐。
至于和 Claude、GLM、Kimi 怎么选,我建议先拿同一份真实任务比三件事:能否验收、多久做完、总共花了多少。
想批量生成交互原型、做小型游戏和 3D 项目,可以把新版 Flash 放进候选;任务量大,尤其值得比较它减少输出和交互轮次后的总成本。复杂仓库改动,则要结合自己的测试结果,不能只凭这一张官方跑分表把原来的主力模型全换掉。
先让它完成一个你能亲自验收的小项目。“许愿”有没有成真,跑起来就知道了。
# 资料来源
- DeepSeek官方发布公告及本文图片、动图:https://api-docs.deepseek.com/zh-cn/news/news261017/
- DeepSeek网页搜索与抓取指南:https://api-docs.deepseek.com/zh-cn/guides/search/
- Hugging Face模型权重:https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017
- ModelScope模型权重:https://modelscope.cn/models/deepseek-ai/DeepSeek-V4.1-Flash-1017
评论
验证登录状态...