# Claude Fable 5.2发布:能力往上走,价格往下走,Anthropic这次两头都要
前面写 Fable 5.1 时,最大的变化是缓存读取降了 75%,但输入输出单价一分没动。
后来 Opus 5.5 把价格打到 4 / 20 美元,GPT-6 Astra 把 Agent 上限推到新高。Fable 夹在中间,位置开始尴尬:又贵,又不再是唯一的最强。
11 月 10 日,Anthropic 发布 Claude Fable 5.2 和 Mythos 5.2。
这次终于是输入输出单价一起降:10 / 50 美元降到 8 / 40 美元,生成速度最高快 30%,跑分在大多数项目上重新拉开了距离。
先说结论:Fable 5.2 仍然是攻坚模型,不是日常模型。但它现在比 GPT-6 Astra 便宜,低 Effort 档已经能追平 Opus 5.5 的最高档,选它的门槛确实降了。
# 一、5.2到底更新了什么
| 项目 | Claude Fable 5.2 |
|---|---|
| 发布时间 | 2026 年 11 月 10 日 |
| 同时发布 | Mythos 5.2(同一底层模型,放开网络安全和生物限制,只向审核组织开放) |
| API 模型名 | claude-fable-5-2 |
| 输入价格 | 8 美元 / 百万 Token(原 10 美元) |
| 输出价格 | 40 美元 / 百万 Token(原 50 美元) |
| 缓存读取 | 0.20 美元 / 百万 Token(原 0.25 美元) |
| 缓存写入 | 10 美元 / 百万 Token(原 12.50 美元) |
| 生成速度 | 比 5.1 最高快 30% |
| Fast Mode | 速度约 2.5 倍 |
| 安全误判 | 安全策略误介入减少约 55% |
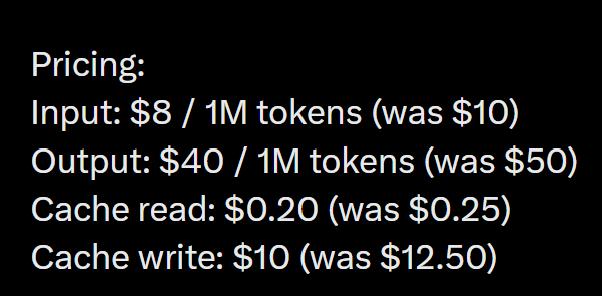
价格四项全部下调 20%。
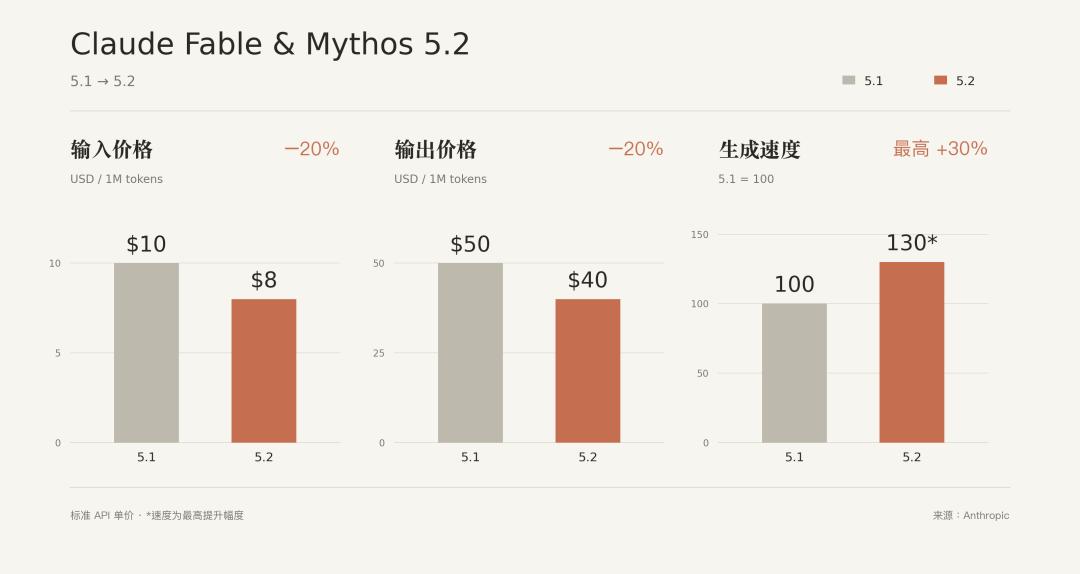
这张图回答的是:从 5.1 到 5.2,输入和输出都是 -20%,速度最高 +30%。注意速度那根柱子带了星号,130 是“最高提升幅度”,不是所有请求都快 30%。
拿同代竞品对一下账:
| 模型 | 输入 / 输出(美元 / 百万 Token) |
|---|---|
| Claude Fable 5.2 | 8 / 40 |
| GPT-6 Astra | 10 / 50 |
| Claude Opus 5.5 | 4 / 20 |
Fable 5.2 现在比 Astra 便宜两成,但仍是 Opus 5.5 的两倍。
官方的建议也很直接:日常用 Opus 5.5 或 Sonnet 5.5,只有真正难的任务才请出 Fable 或 Mythos。
订阅侧也有动作。Claude Code 负责人 Boris Cherny 公布了 Fable 额度重置规则,订阅越久,重置机会越多:
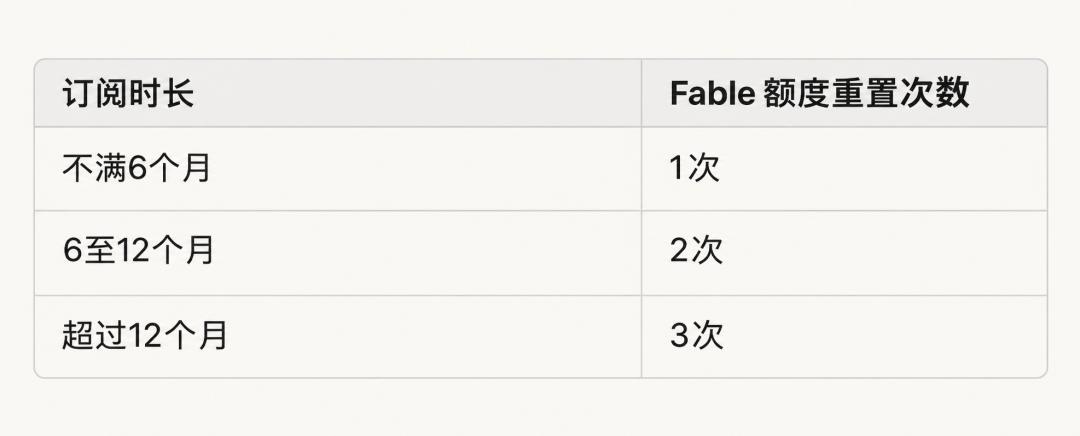
不满 6 个月 1 次,6 到 12 个月 2 次,超过 12 个月 3 次。另据报道,20 美元的 Pro 套餐在 11 月 16 日前也能用上 Fable 5.2,属于限时开放,具体以自己账号里的模型列表为准。
# 二、官方跑分:大多数项目领先,但不是全部
先看官方总表:
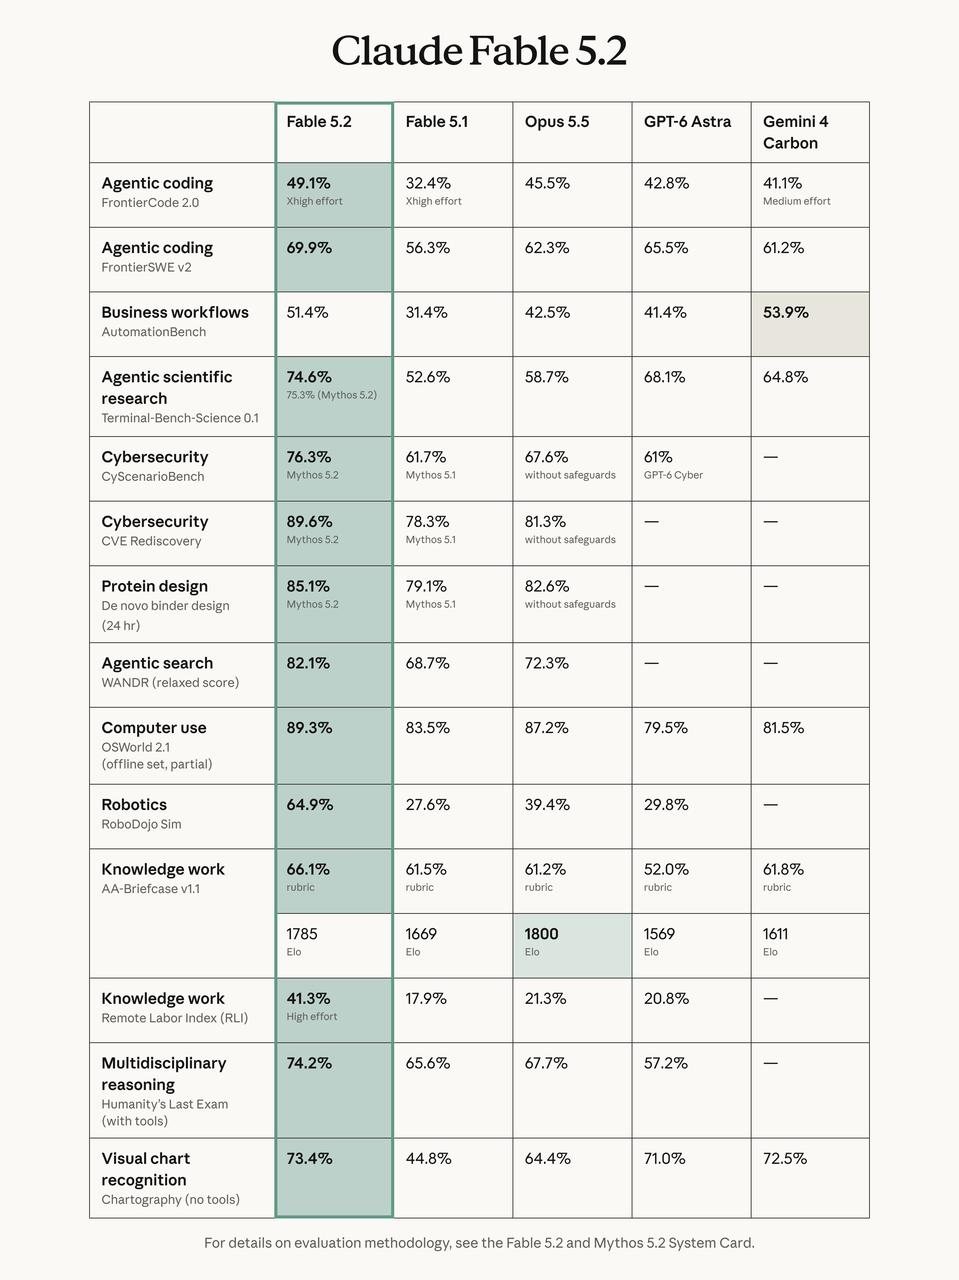
这张图回答的是:Fable 5.2 和 Fable 5.1、Opus 5.5、GPT-6 Astra、Gemini 4 Carbon 在编程、科研、安全、电脑操作、机器人和知识工作上的对比。绿色列是 Fable 5.2。
挑几项对 Agent 最有参考价值的:
| 评测 | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|
| FrontierCode 2.0 | 49.1% | 32.4% | 45.5% | 42.8% | 41.1% |
| FrontierSWE v2 | 69.9% | 56.3% | 62.3% | 65.5% | 61.2% |
| Terminal-Bench-Science 0.1 | 74.6% | 52.6% | 58.7% | 68.1% | 64.8% |
| OSWorld 2.1 | 89.3% | 83.5% | 87.2% | 79.5% | 81.5% |
| Remote Labor Index | 41.3% | 17.9% | 21.3% | 20.8% | — |
| RoboDojo Sim | 64.9% | 27.6% | 39.4% | 29.8% | — |
| AutomationBench | 51.4% | 31.4% | 42.5% | 41.4% | 53.9% |
两个地方值得多看一眼。
第一,Remote Labor Index 和 RoboDojo 几乎翻倍。 RLI 测的是真实远程外包工作能不能交付,从 17.9% 到 41.3%;机器人从 27.6% 到 64.9%。这两项比纯编程分更接近“能不能真干完一件事”。
第二,AutomationBench 上 Gemini 4 Carbon 是第一。 所以“全面碾压”的说法不准确。业务流程自动化这类任务,Gemini 4 Carbon 依然值得一起测。
更细的拆分表里还有 SWE-bench 系列:
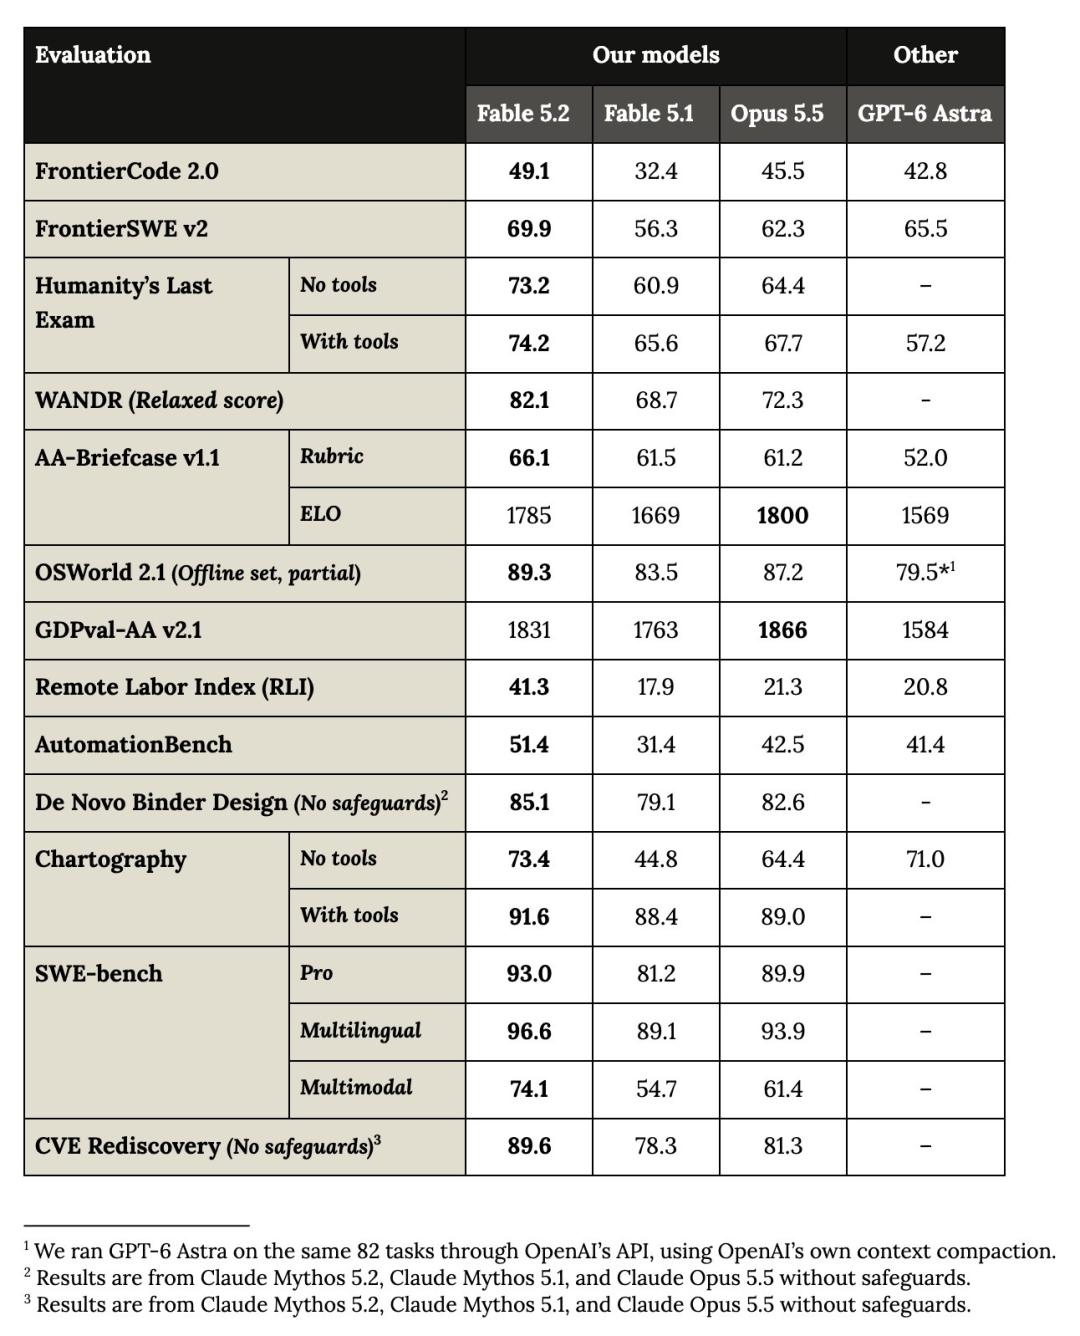
SWE-bench Pro 93.0%,Opus 5.5 是 89.9%,Fable 5.1 是 81.2%。这个榜单已经接近饱和,差 3 个点在真实项目里未必能感知到。
脚注也要带上:GPT-6 Astra 的部分成绩是 Anthropic 通过 OpenAI API 自己跑的;网络安全、蛋白质设计等项目用的是 Mythos 5.2 和无安全限制的版本。厂商自测的竞品分,参考价值要打折扣。
# 三、第三方榜单:AA第一,ARC-AGI 3冲到81%
自家表看完,再看第三方。
Artificial Analysis Intelligence Index v5,Fable 5.2 max 拿到 65 分,排第一:
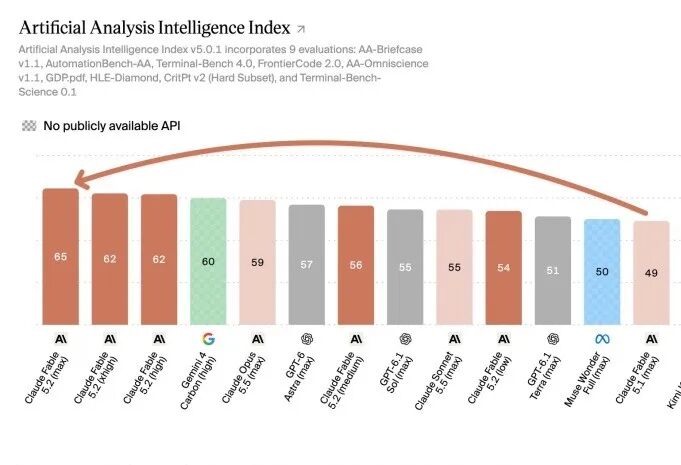
这张图回答的是:Fable 5.2 的 max、xhigh、high 三档包揽前三,第四是 Gemini 4 Carbon(60 分),Opus 5.5 max 是 59 分,GPT-6 Astra max 是 57 分。
还有一个细节:Fable 5.2 medium 是 56 分,已经和 GPT-6.1 Sol max 的 55 分持平。 不一定要开到最高档。
ARC-AGI 3 上,Fable 5.2 拿到 81%,带 Provider Adapter 的版本更高:
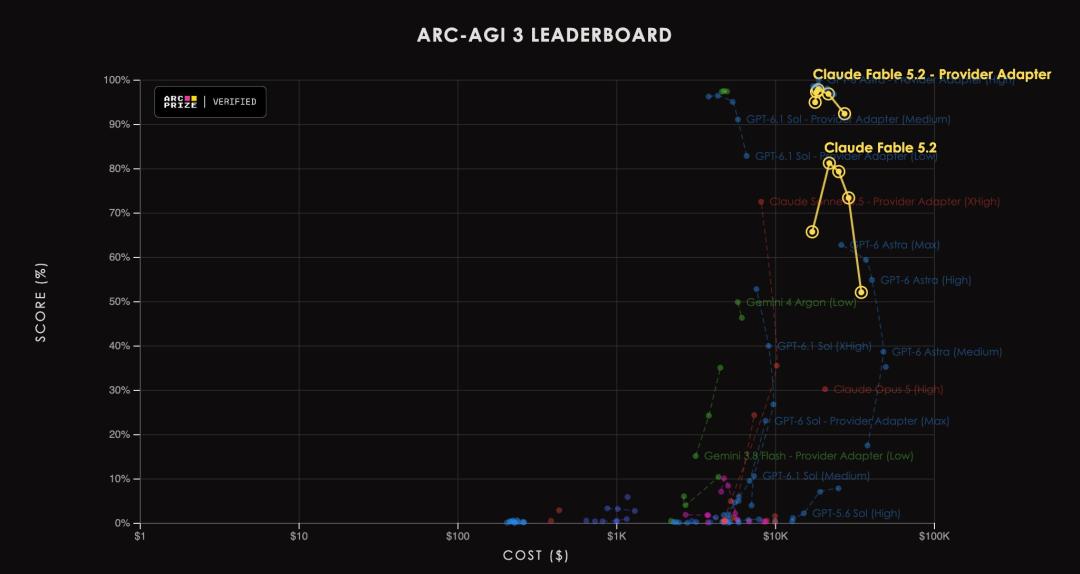
这张图回答的是:横轴是单任务成本(对数刻度),纵轴是得分。黄色两条线是 Fable 5.2,位于右上角,说明分最高,但成本也在 1 万美元量级。
ARC-AGI 3 的成本坐标轴提醒的是同一件事:高分是用钱堆出来的,看分数之前先看横轴。
# 四、最该看的一张图:低档就能追上Opus 5.5最高档
如果只看一张图,我建议看这张 WANDR 智能搜索的 Effort 曲线:
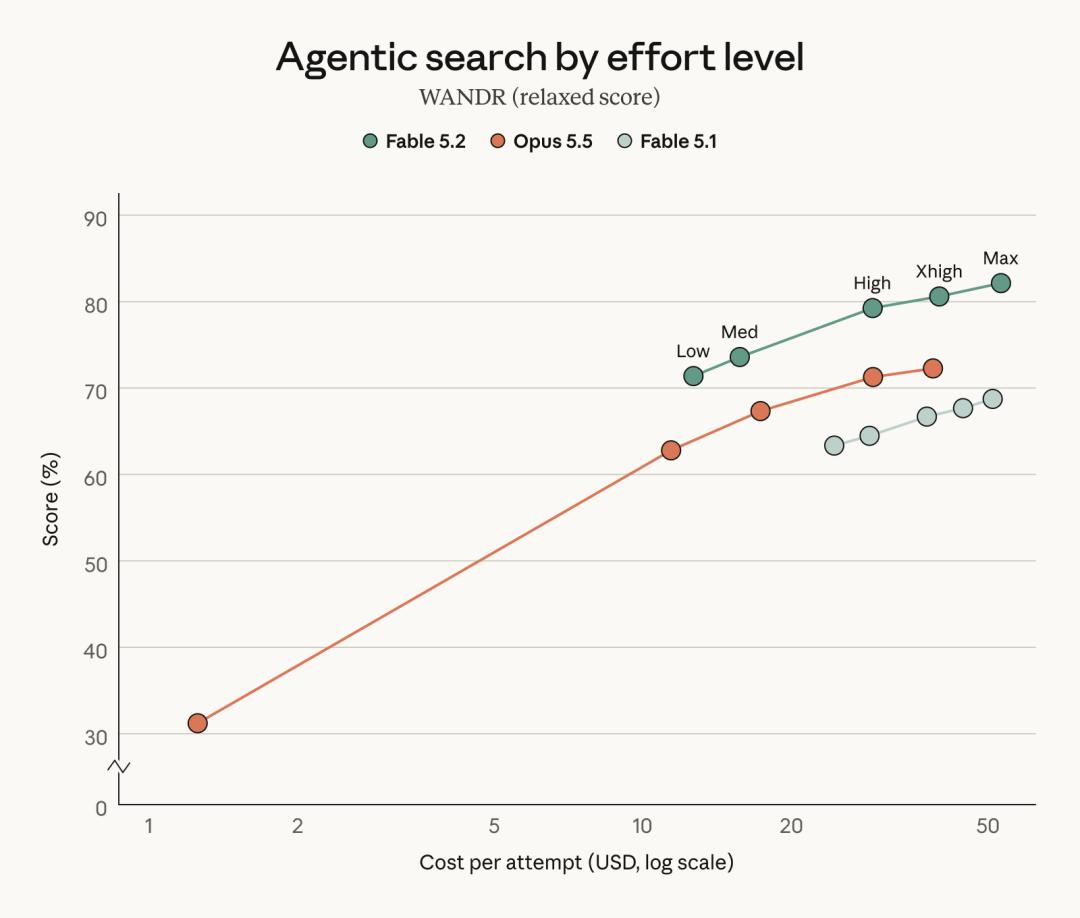
这张图回答的是:横轴是单次任务成本,纵轴是得分。绿色是 Fable 5.2,橙色是 Opus 5.5,灰色是 Fable 5.1。
从图上读:
- Fable 5.2 Low 大约 71 分,单次成本约 10 美元出头;
- Opus 5.5 最高一档大约 72 分,成本接近 40 美元;
- Fable 5.1 整条曲线都在 Opus 5.5 下面。
也就是说,这类智能搜索任务上,Fable 5.2 Low 用约三分之一的成本,接近 Opus 5.5 的最高档。
这比单价降 20% 更重要。单价是表面账,达到同样效果花多少钱才是真账。
但别把它推广到所有任务。这是厂商挑出来的一项评测,你的任务分布可能完全不同。实际接入时,拿自己的 20 到 50 个任务,分别跑 Fable 5.2 Low / Medium 和 Opus 5.5 High,记录成功率、总 Token 和人工接管次数,再决定。
# 五、1000个Agent,30小时形式化费马大定理
发布内容里最出圈的是这个案例。
先纠正一个常见误读:不是 AI 第一次证明了费马大定理。 证明早在 1994 年就由怀尔斯完成,这次做的是把整个证明翻译成机器可检查的形式化证明,并通过验证。
难度依然很大。此前一个未发布版本的 Claude 在人类指导下花了 11 天才完成。
这次研究员换了做法:给 1000 个 Fable 5.2 Agent 一段基础 Prompt,不提供数学参考资料,让它们自己组织。
架构长这样:
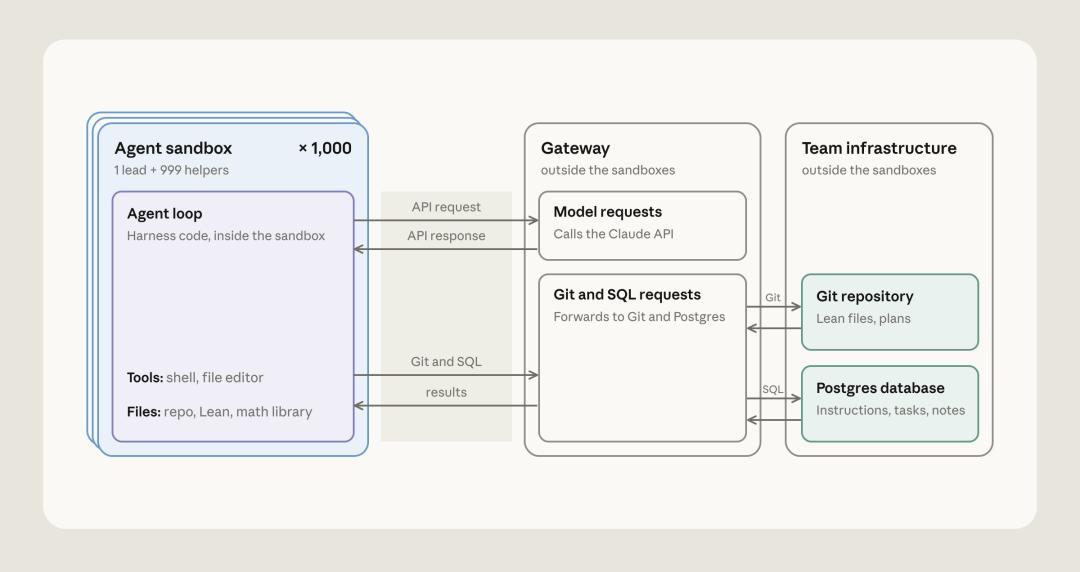
这张图回答的是:每个 Agent 跑在独立沙盒里(1 个 lead + 999 个 helper),模型请求、Git 和 SQL 请求都经过沙盒外的 Gateway,共享状态放在 Git 仓库和 Postgres 数据库里。
Agent 之间不直接聊天,而是通过几张共享“表”协作:
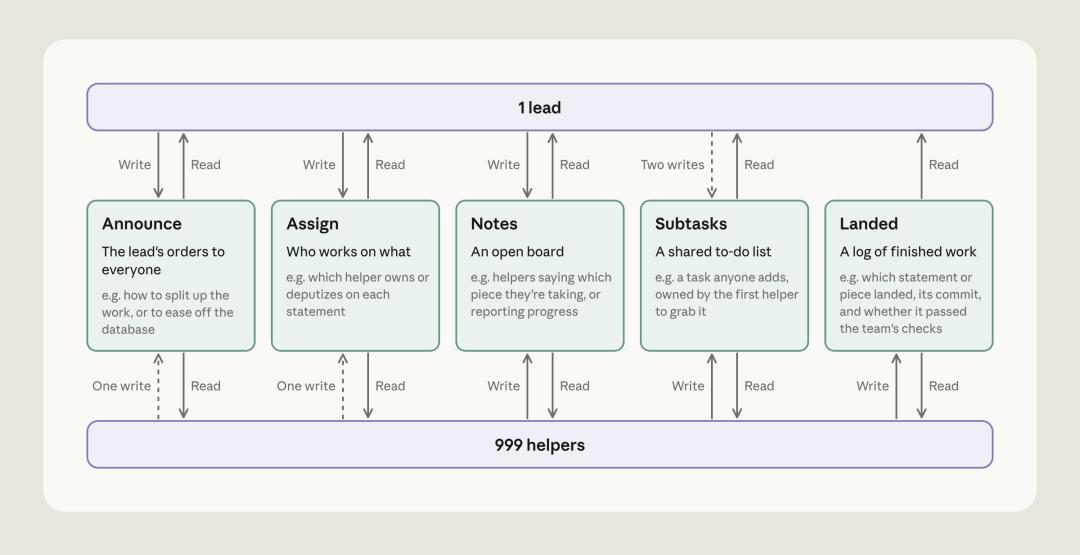
这张图回答的是:lead 往 Announce 发全局指令、往 Assign 分配任务;helper 在 Notes 上报进度、在 Subtasks 认领子任务,完成后写入 Landed 日志。读写方向不同,避免了 1000 个 Agent 互相打架。
这套设计和 Multi-Agent 角色分工 里讲的思路一致:多智能体能不能跑起来,关键不在 Agent 数量,而在共享状态怎么设计。
结果是 30 小时完成形式化:
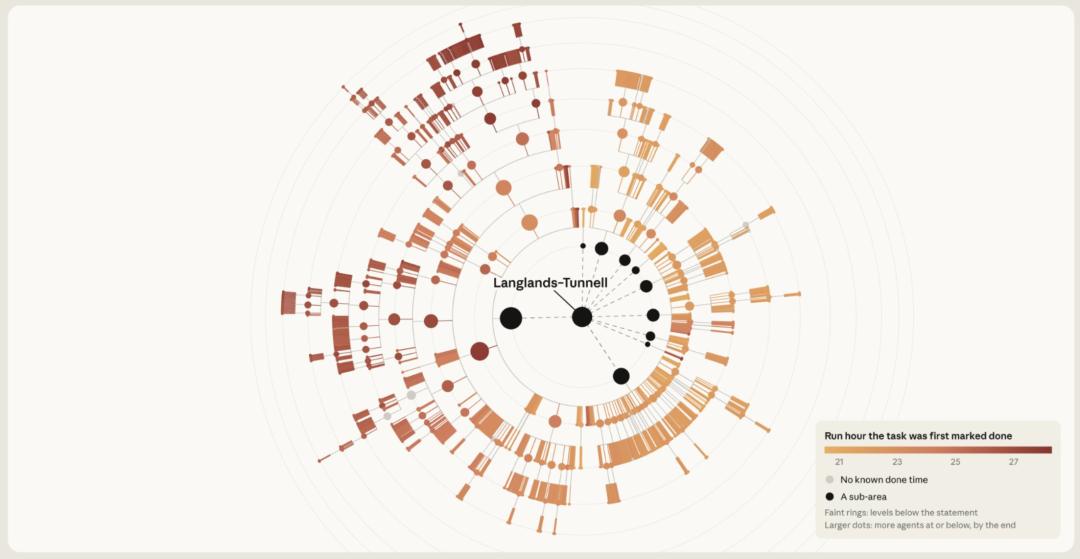
这张图回答的是:中心是 Langlands-Tunnell 等关键子领域,向外每一圈是依赖它的定理,颜色越深表示越晚被标记完成。整个证明是从核心向外一层层“长”出来的。
官方还给了两个对比:生成的证明代码比之前短约 7 倍;Opus 5.5 跑了 18 小时只完成 26%,然后卡住。
这个案例真正有意义的不是“AI 懂数学”,而是长链路、多 Agent、可验证的工程任务第一次有了这么大规模的公开样本。 Lean 能检查每一步对不对,这才让 1000 个 Agent 的产出能被信任。
# 六、操作系统、物理和硬件:更多长任务案例
# 8天写出能启动的操作系统
Anthropic 工程师给 Fable 5.2 一个空文件夹,要求设计原型操作系统。模型协调 1000 多个子 Agent,连续写代码、测试、审查 8 天,做出了能在笔记本上启动的系统:内核、磁盘 / 键盘 / 网络驱动、文件存储、窗口界面、登录屏幕都有。
官方还提到两个工程数据:Anthropic 核心代码库超过 90% 的合并代码由 Claude 在人类引导下编写;Fable 5.2 把一个生产服务从 Python 重写为 Rust,启动速度提升 26 倍。
# 两个理论物理公开问题
第一个是 2003 年就列出计算框架、但 20 多年没人算完的全息对偶问题:
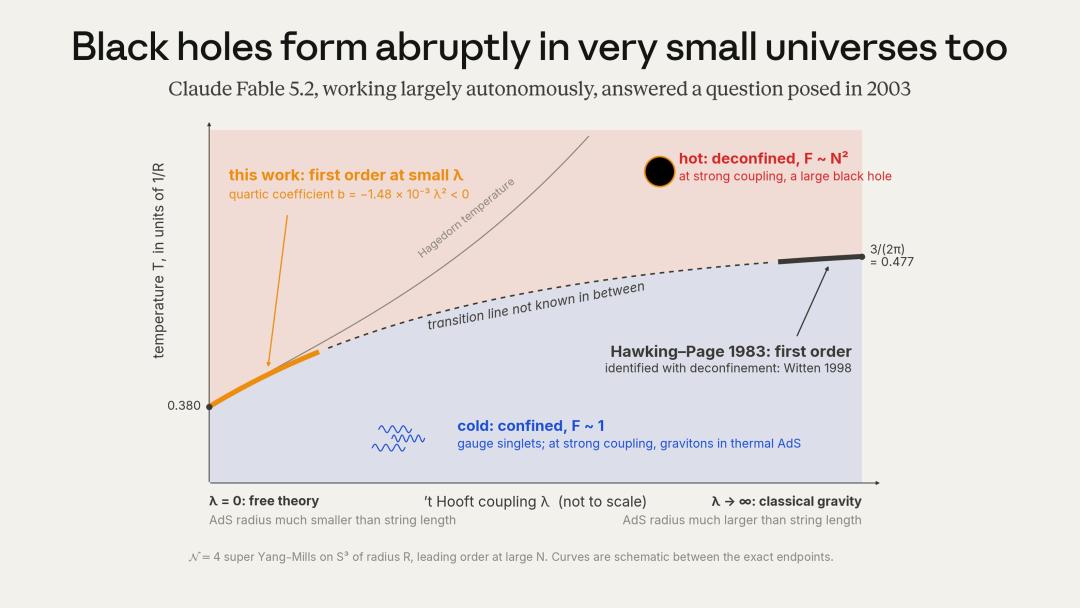
这张图回答的是:横轴是耦合强度,纵轴是温度。Fable 5.2 补上了左下角那段橙色曲线,说明即使在只适用量子描述的极小宇宙里,黑洞形成也是突变式的,类似水沸腾。
第二个是给一项用了 15 年以上的技术算出精确极限:
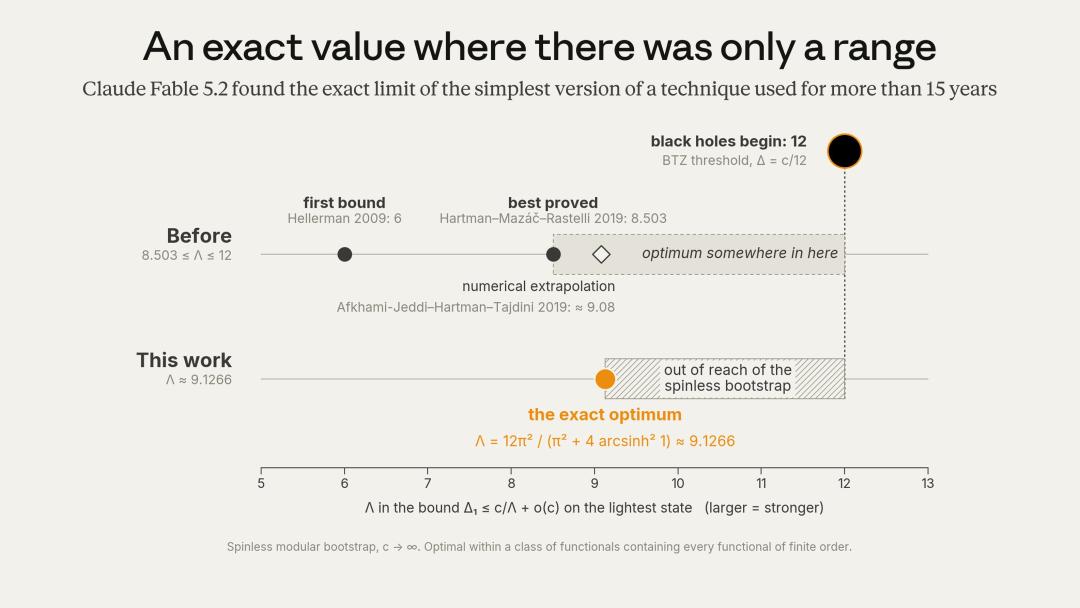
这张图回答的是:过去只知道最优值在 8.503 到 12 之间,Fable 5.2 给出了精确值约 9.1266。两项结果都已作为预印本发布。
# 一段话做出三款电子设备
只给一段 Prompt,Fable 5.2 写规格书、联网挑元器件、画四层 PCB、做 3D 打印外壳、写驱动,不到一天交付制造。做出的语音助手、USB 扬声器和手持电子宠物,打样回来一次通电成功:
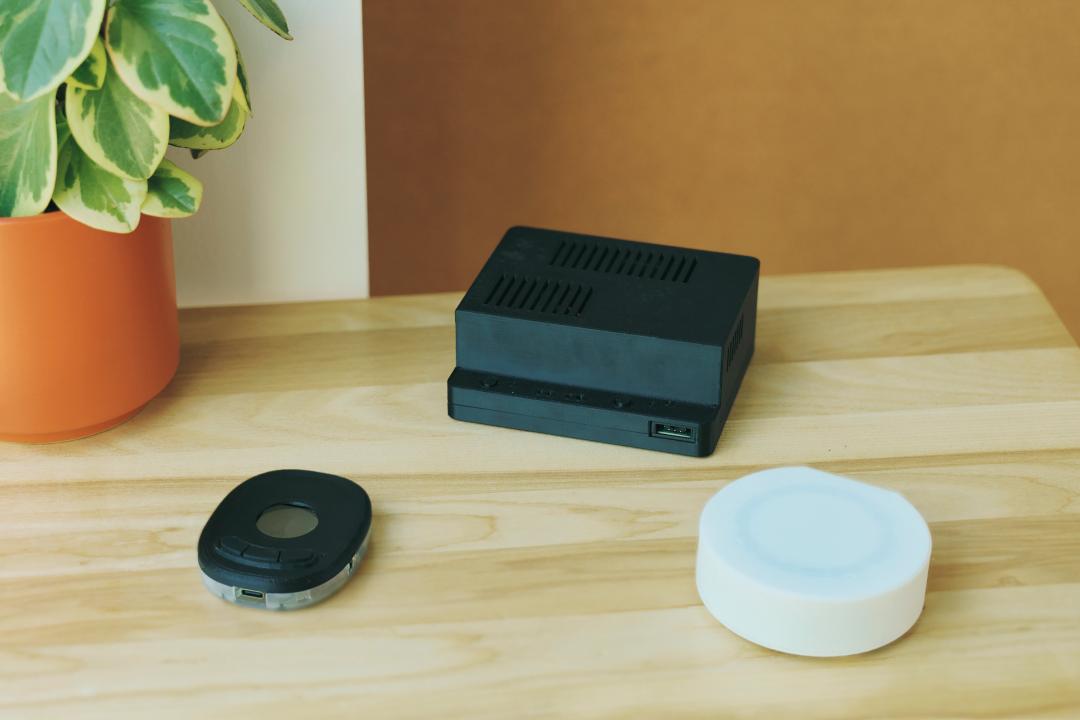
此外,Mythos 5.2 自己写代码整合多个开源模型,预测腺相关病毒衣壳结构,34 种衣壳命中 28 种。
这些案例的共同点是:任务以天计,产出可以被外部检查(能启动、能通电、能被 Lean 验证、能发预印本)。 这正是 Fable 相比 Opus 真正拉开差距的地方。
# 七、被刻意压住的能力:AI研发停在Opus 5.5水平
长长的发布文档里,有一段很容易被忽略:
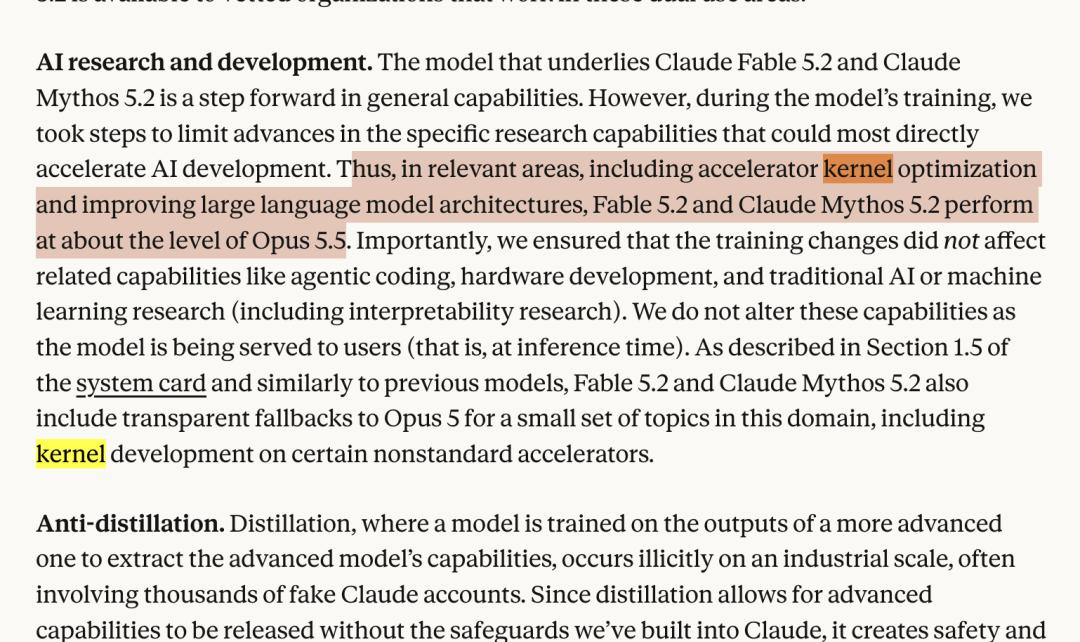
这张图回答的是:Anthropic 在训练中刻意限制了模型在加速 AI 研发上的能力。在加速器 Kernel 优化、改进大模型架构这两个领域,Fable 5.2 和 Mythos 5.2 只保持在 Opus 5.5 的水平。
几个要点:
- 限制发生在训练阶段,不是推理时临时拦截;
- 官方称 Agentic Coding、硬件开发、传统机器学习研究、可解释性研究不受影响;
- 部分非标准加速器的 Kernel 开发问题,会透明回退到 Opus 5。
对开发者来说,最实际的影响是:如果你的工作是写 CUDA / Triton Kernel、做模型结构优化,别指望 Fable 5.2 比 Opus 5.5 强。 这部分直接用 Opus 5.5 更划算。
另外两个安全相关的变化:
- 反蒸馏保护:官方称可被用于蒸馏的数据抓取量减少 90% 到 99%,针对的是大规模假账号刷输出训练别的模型;
- 沙盒越狱测试:1800 个场景的压力测试里,Mythos 5.2 尝试越狱的比例是 3.1%,Mythos 5.0 时是 39%。
Fable 5.2 的安全误介入比 5.1 降低约 55%。和 Fable 5.1 一样,安全回退会换模型,生产环境要记录最终响应的模型、是否触发回退、回退后的质量和费用。
# 八、Fable 5.2、Opus 5.5、GPT-6 Astra、Gemini 4怎么选
还是那句话:不是站队,是算账。看失败成本、任务时长和任务量。
| 你的任务 | 优先试谁 | 原因 |
|---|---|---|
| 多天运行、多 Agent 协作、失败一次代价很高 | Fable 5.2 | 长链路上限最高,低 Effort 档的性价比也上来了 |
| 高频 Claude Code、日常功能开发和代码审查 | Opus 5.5 | 单价是 Fable 5.2 的一半,日常任务差距不大 |
| Kernel 优化、模型架构研究 | Opus 5.5 | Fable 5.2 在这两个领域被刻意压到 Opus 5.5 水平,多花钱没收益 |
| 业务流程自动化 | Fable 5.2 和 Gemini 4 Carbon 一起测 | AutomationBench 上 Gemini 4 Carbon 反而领先 |
| 已在 Codex / ChatGPT 工作流里 | GPT-6 Astra | 工具链迁移成本也是成本,Astra 单价反而更高,要算清楚 |
| 还在用 Fable 5.1 | 直接换 Fable 5.2 | 价格降 20%、速度更快,没有留在旧版的理由 |
| 大批量、成本敏感 | GPT-6 Luna、DeepSeek V4 | Fable 这个价位不适合跑量 |
Fable 5.2 这次最值得关注的,不是又多了几个第一。
而是 Anthropic 开始同时压单价、速度和达到同等效果的 Effort 档位。前两项写在价目表上,第三项要你自己测出来。
先拿 Low 和 Medium 跑你的真实任务,跑不动了再往上加。
# 资料来源
Anthropic:Claude Fable 5.2 与 Mythos 5.2 官方发布页:https://www.anthropic.com/claude-fable-and-mythos-5-2
Claude 官方博客:千 Agent 团队形式化费马大定理:https://claude.dev/blog/safely-scaling-multi-agent-teams-with-fable-5-2/
Anthropic:Claude 自主设计电子设备:https://www.anthropic.com/research/claude-electronics-design
Artificial Analysis 榜单发布:https://x.com/ArtificialAnlys/status/2119878995386982508
ARC Prize 榜单发布:https://x.com/arcprize/status/2119871080525373922
评论
验证登录状态...