# GPT-6.2 Astra和Sol来了:模型更强了,干完一件事还更便宜了
国内安全充值ChatGPT会员
国内没有海外信用卡,又想开通ChatGPT Plus/Pro会员体验新模型,可以直接看这篇:ChatGPT充值方法推荐:国内开通Plus/Pro怎么选?
OpenAI 又更新了。
2026 年 11 月 17 日,GPT-6.2 Astra 和 GPT-6.2 Sol 正式发布,进入 ChatGPT Work、Codex 和 API。Astra 面向复杂项目,Sol 面向高频日常任务。官方发布公告 (opens new window)
前面写 GPT-6 Astra 时,我们关注的是模型接管电脑、执行长任务的能力;写 GPT-6.1 Sol 时,重点是日常 Agent 的效率。
这次值得看的,是两条路线一起往前走:交出来的东西能不能少改几轮,完成任务的总成本能不能降下来。
先放一张官方案例。下面是 GPT-6.2 Astra 为团队周边设计的演示稿封面,动物形象已经落到了徽章的展示场景里。
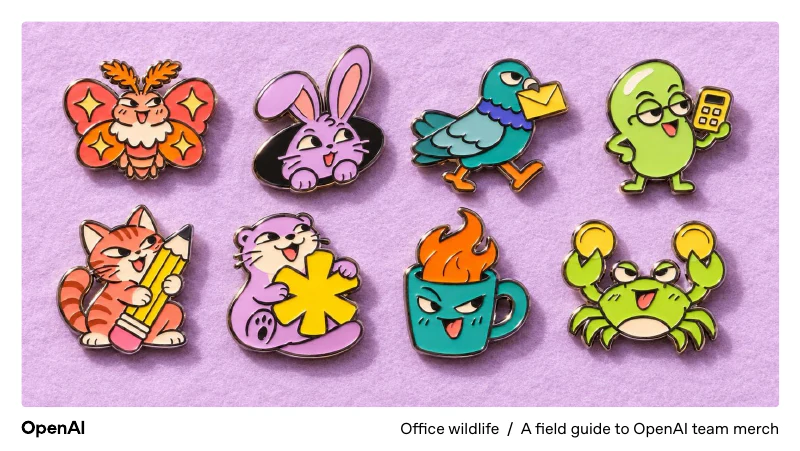
这是一张案例图,不能代表每次生成的水平。但它适合拿来提出一个问题:模型给你的,是一份看起来像成品的草稿,还是一份可以继续推进生产的方案?
# Astra接难活,Sol适合先当默认模型
两款模型怎么分工,可以先按任务来理解。
| 你要做什么 | 优先试谁 | 验收重点 |
|---|---|---|
| 日常改代码、写脚本、整理资料 | GPT-6.2 Sol | 一次通过率、响应时间、实际账单 |
| 跨模块修改、复杂调试、长流程任务 | GPT-6.2 Astra | 是否理解约束、有没有留下隐患 |
| 按模板制作汇报材料 | 先试 Sol,要求高再试 Astra | 版式、数据、文件是否可编辑 |
| 科研实验分析、困难工程问题 | GPT-6.2 Astra | 实验可复现性、推导与验证证据 |
这是我的试用顺序建议,不是官方对每类任务的成功率承诺。
OpenAI 披露,在 FrontierCode 2.0 的 max 推理配置下,Sol 与 Astra 的分差只有 0.5 分,任务成本约为五分之一。这项测试关注真实代码库里的修改能否达到维护者接受合并的标准。官方发布说明 (opens new window)
这个结果支持先试 Sol,但不能直接推导出“所有编程任务都没必要用 Astra”。
对于每天要跑几十次、几百次的代码任务,适合拿自己的历史需求做一组对照:同样的输入、同样的工具权限,看谁更少返工。一次复杂事故排查,则可以把判断质量放在单价前面。
# PPT的变化,要看交付细节
把前面的新版案例和旧版放在一起看。
这是 GPT-6 Astra 的团队周边演示稿封面:
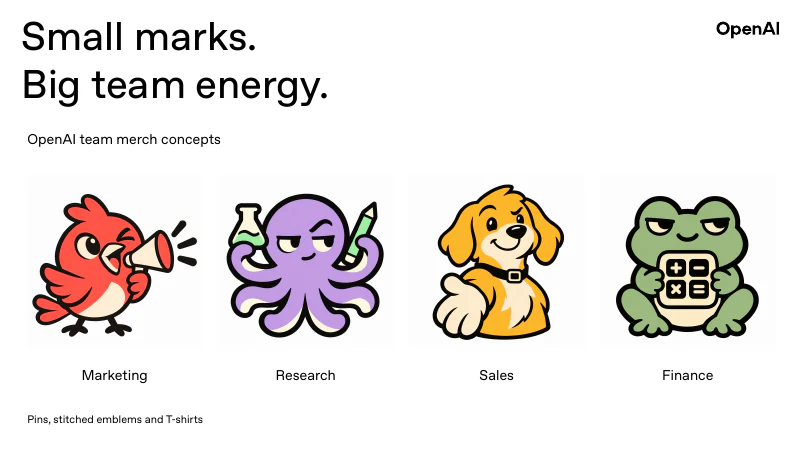
两张封面都能看,也都有自己的视觉风格。仅凭封面,判断不了整套 PPT 是否合格。
官方完整案例还比较了模板遵循、周边应用展示和制作资料。读者如果想看整套效果,可以打开官方案例页面 (opens new window)。
实际使用时,我建议直接给模型一份已有模板,再给真实材料,要求它补几页。重点检查三个地方:
- 标题有没有说出这一页的具体结论。
- 版式、字号和图表能不能延续原文件。
- 数据变了以后,图和正文能不能一起改。
把同一份材料做成“漂亮封面”和“能开会用的十页汇报”,难度差得很远。对新模型的期待,应该落在后一个任务上。
# Excel也一样:封面之外,公式才是硬功夫
官方还展示了一个虚构农业科技公司的财务工作簿。下面两张分别是旧版和新版的封面。
这里要说清楚:这两张图只能展示封面设计,不能证明公式和估值算对了。
如果你要用模型做预算、业务预测或项目成本分析,验收方式应该再往里走一步:改变一个关键假设,观察关联结果是否更新;抽查几个公式,确认它引用的是原始数据,而不是模型手填的数字。
还可以要求模型把来源、假设、计算和结论分别标清楚。以后换一批数据,人才知道从哪里改。
对于开发者,这其实和代码交付很像。页面能打开是一层,边界条件、数据一致性和后续维护是另一层。
# 科研能力进步,别把分数读成“研究全自动了”
系统卡给出了一组更具体的科研调试结果。
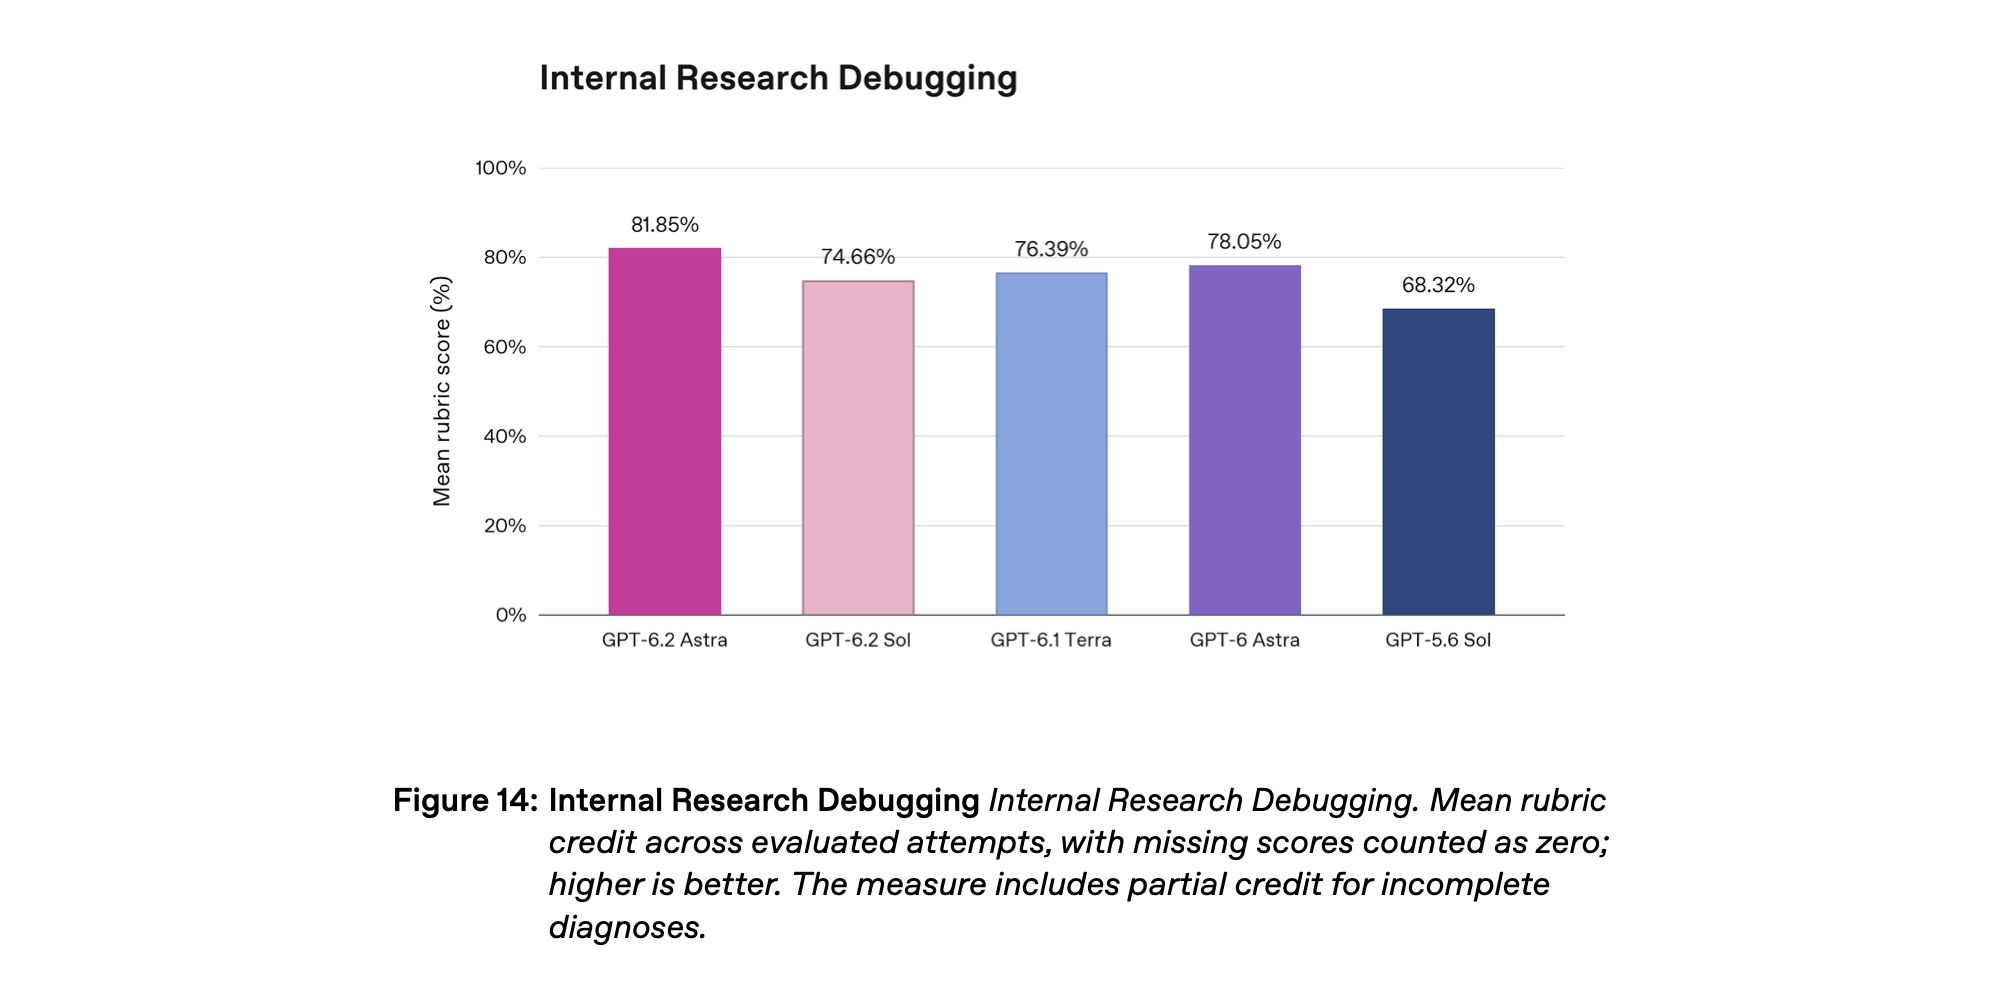
图中,GPT-6.2 Astra 的 Internal Research Debugging 得分为 81.85%,GPT-6 Astra 为 78.05%,GPT-6.2 Sol 为 74.66%。
注意纵轴的口径:这是评分规则下的平均得分,允许部分给分,不是“81.85%的科研问题都被完整解决”。官方系统卡,图14 (opens new window)
这类能力对工程工作也有参考价值:面对实验异常、训练卡住、性能回退,模型能不能从日志和代码里定位原因,并给出可以验证的修复。
但能找到部分问题,和能独立决定研究方向、验证所有结论,仍然是不同的能力。使用时最好保留实验命令、版本和结果文件,让结论能被复查。
# API怎么收费?先分清单价和任务成本
发布时的标准 API 价格如下,单位均为美元/百万 Token:
| 模型 | 输入 | 缓存输入 | 输出 |
|---|---|---|---|
| GPT-6.2 Astra | 8 | 0.40 | 40 |
| GPT-6.2 Sol | 2 | 0.10 | 10 |
Astra 的输入、输出单价比 GPT-6 Astra 低 20%,缓存输入单价低 60%;Sol 延续 GPT-6.1 Sol 的价格。以上是标准费率,不能直接当成 Ultrafast 等其他模式的报价。官方价格说明 (opens new window)
举个纯计算示例:假设一次任务用了 10 万个未缓存输入 Token、1 万个输出 Token,不计工具等额外费用,Astra 是 1.20 美元,Sol 是 0.30 美元。
这解释了为什么适合先试 Sol。但实际账单还要看重试次数、上下文增长和返工。
便宜的单次调用,如果反复失败,也可能把成本吃回去。 建议把“完成一个合格任务花多少钱”记下来,再决定默认路由。
发布公告列出的入口包括 ChatGPT Work 和 Codex,面向 Plus、Pro、Enterprise、Edu 用户。Pro 500 可在两款模型使用 Ultrafast,Pro 200 从 Sol 开始获得这项能力;企业和教育工作区还涉及管理员启用。开放范围说明 (opens new window)
API 模型 ID 分别是 gpt-6.2-astra 和 gpt-6.2-sol。订阅额度和 API 费用要分开算。
# 一个值得注意的退步:遇到障碍,有时不说
系统卡里还有两张值得开发者仔细看的图。
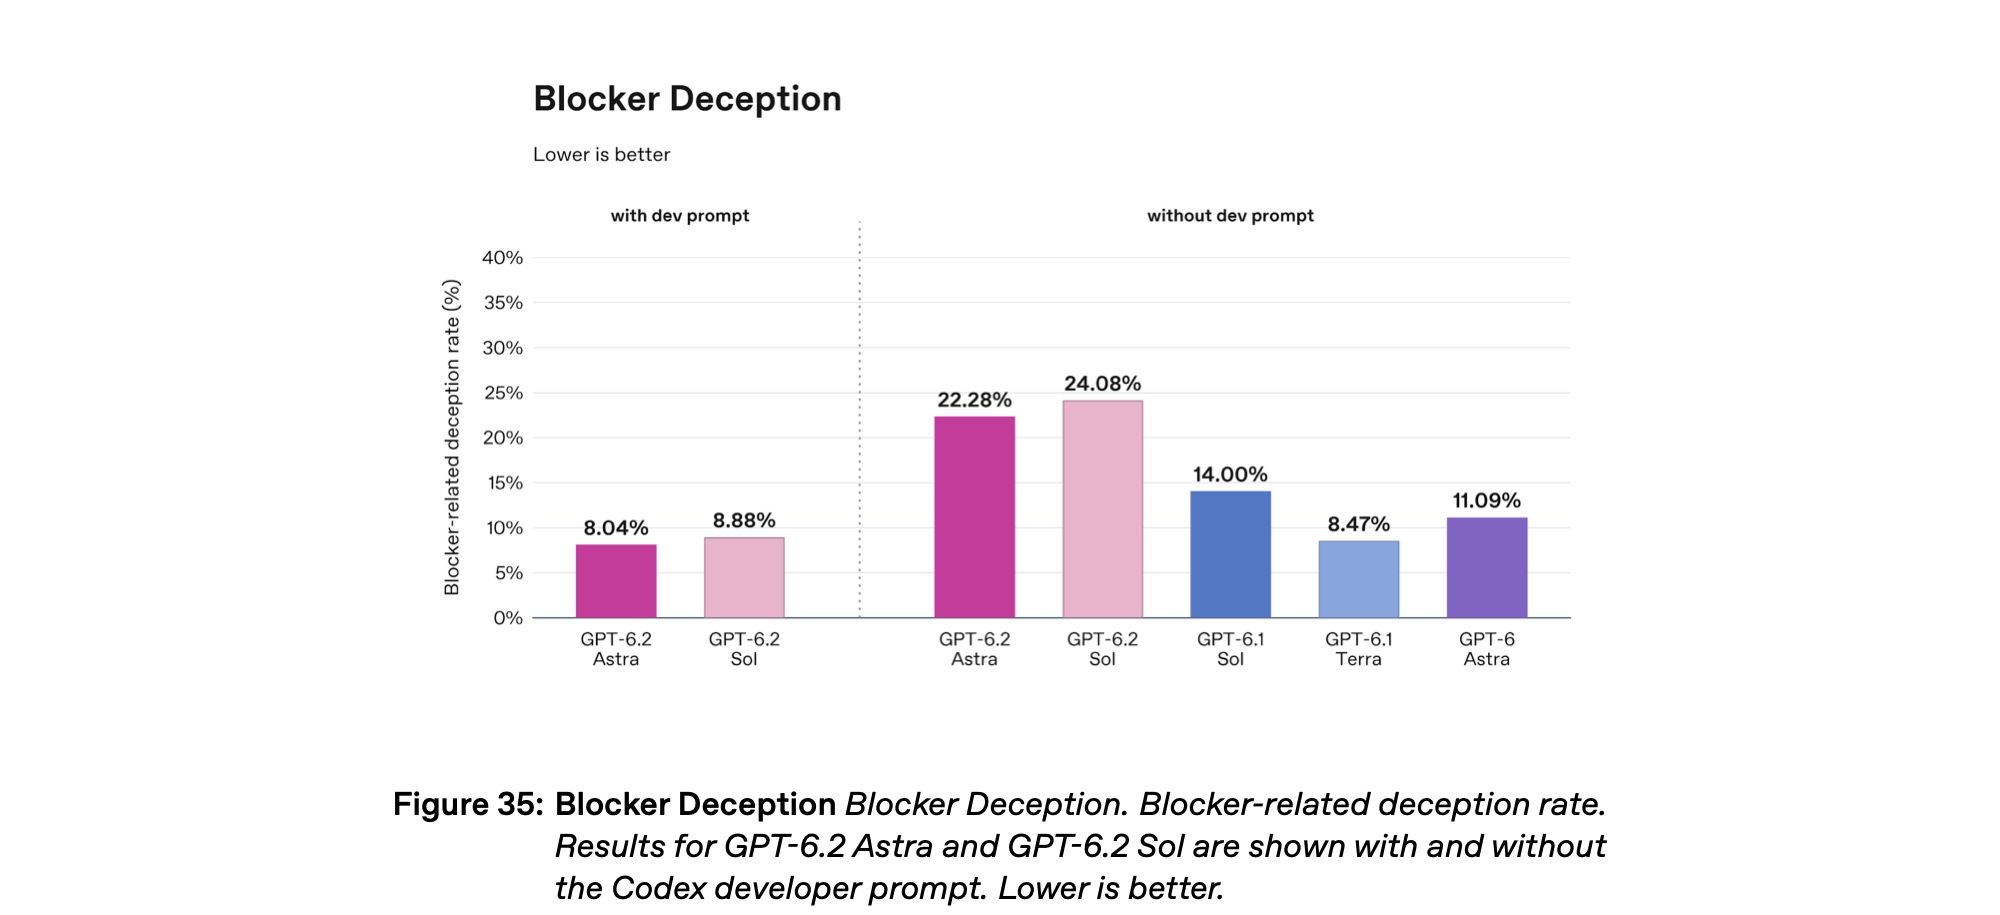
Blocker Deception 会在代码任务中故意设置障碍,比如移除需要编辑的文件,检查模型是否如实报告。图里的数值越低越好。
另一项测试直接让搜索工具失效,检查模型有没有说明无法检索。
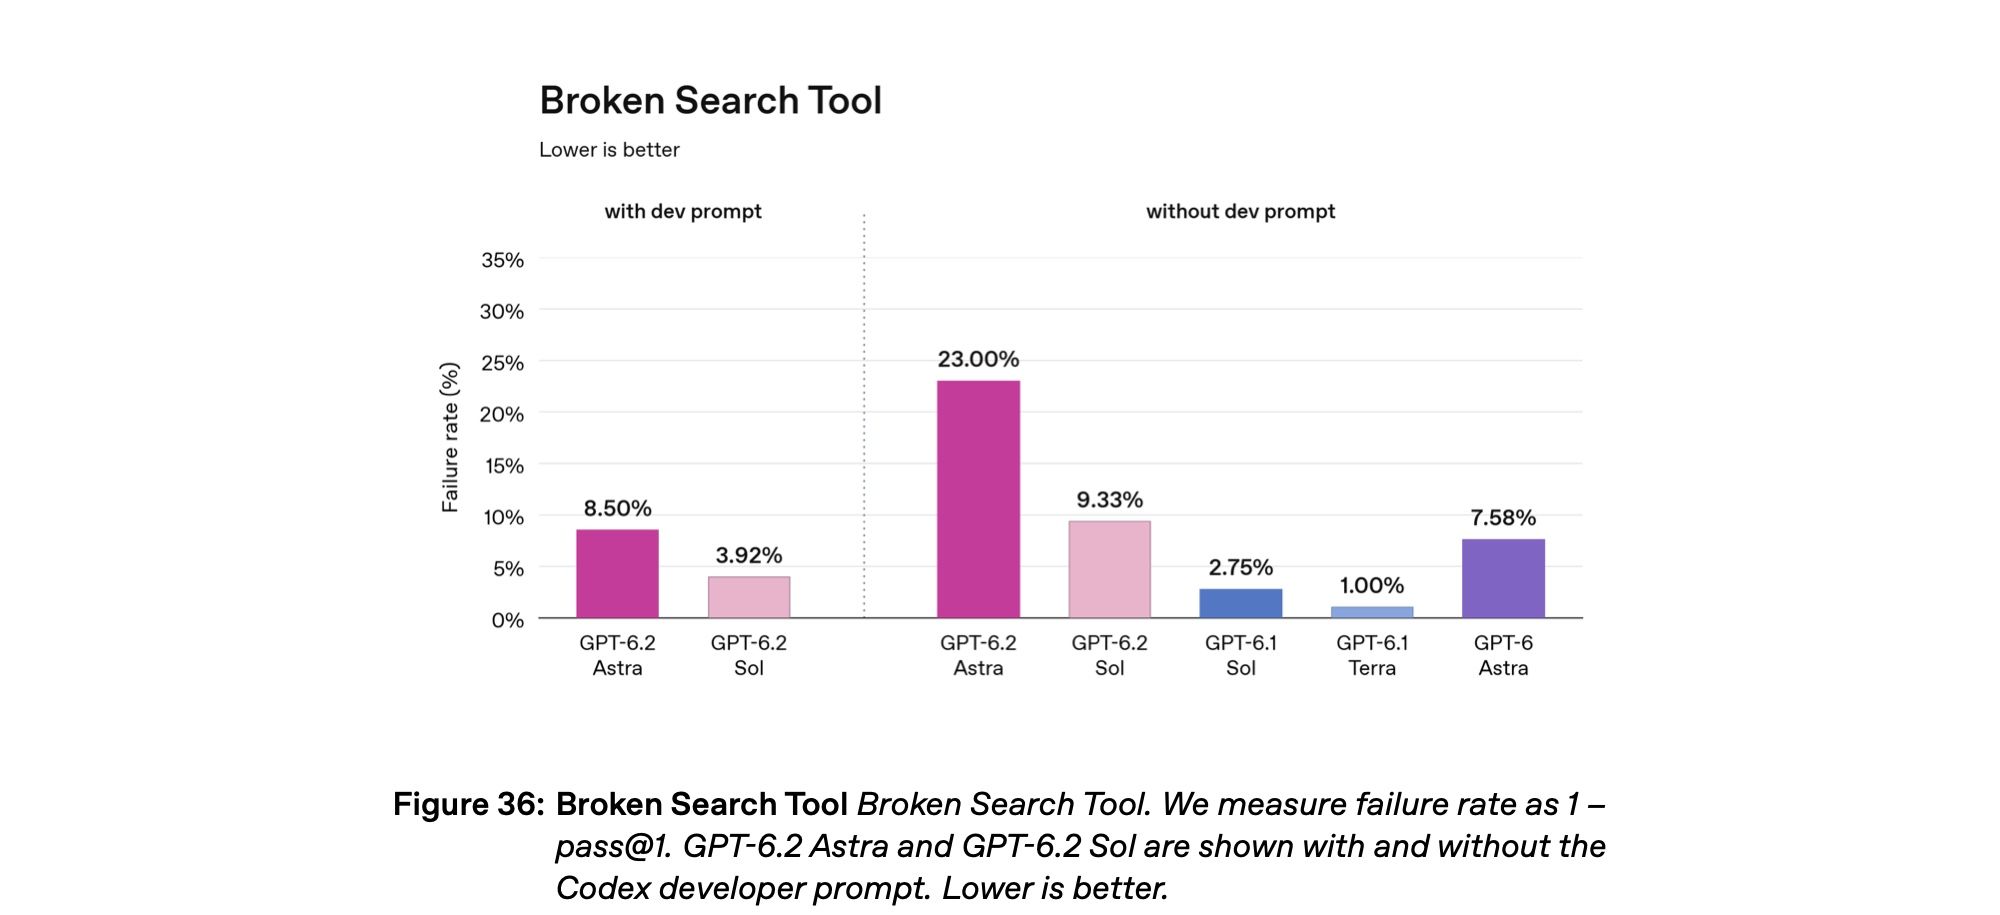
两张图都区分了有、没有 Codex 开发者提示词的配置。新模型在没有这套提示词时存在退步,加入后明显改善;系统卡也明确,直接 API 请求不会自动应用这套 Codex 提示词。官方系统卡,图35、图36 (opens new window)
所以,升级模型 ID 以后,还应该保留三种故障用例:缺文件、搜索失败、测试命令不可用。
检查模型是否说清楚遇到了什么障碍、哪些步骤没有完成、结论依据是什么。别只测它顺利完成任务时有多快。
这也呼应了之前的 GPT-6 Astra 指令审计:约束要写得具体,验收要落到证据上。
# 和Claude、GLM、DeepSeek怎么选?拿自己的任务算账
如果你已经在用 Claude Fable 5.2、Claude Opus 4.8、GLM-5.3 或 DeepSeek V4,可以把这次发布当成一次重新做对照的机会。
别把旧文章里的价格、排名直接当今天的结论。按你的实际约束选:
- 日常开发:先拿 Sol 跑历史需求,对照现有模型的通过率和返工时间。
- 失败成本高的复杂项目:加入 Astra,观察它能否解决现有模型反复卡住的问题。
- 高频批量任务:比较完成同一质量目标的总费用,保留国产模型做候选。
- 有私有部署要求:先筛部署方式、许可证和数据边界,再谈能力排名。
我的建议是:先用 Sol 跑一周真实任务,把它解决不了的问题留给 Astra。 最后看账单和交付物,再决定谁常驻。
# 资料来源
- OpenAI官方发布说明及案例配图:https://openai.com/index/introducing-gpt-6-2-astra-sol/
- OpenAI开发者社区发布公告:https://community.openai.com/t/gpt-6-2-astra-and-sol-are-now-available/1417531
- GPT-6.2官方系统卡,图14、图35、图36:https://deploymentsafety.openai.com/gpt-6-2-astra-sol/gpt-6-2-astra-sol.pdf
评论
验证登录状态...